Zum Inhalt springen
Beta

Landing-Zone-Journey

Zuletzt aktualisiert am

Stackit LogoStackit Logo
STACKIT

Landing-Zone-Journey

STACKIT Landing-Zone-Design, Accelerator-Topologien, Configurator-Workflows, Applikations-Self-Service und Managed Delivery in einer geführten Journey erkunden.

OPS

STACKIT Service Portfolio

PLAN

STACKIT Regionen erkunden

Hover over a country to highlight its regions. Hover over EU01 or EU02 to show documented region details. Keyboard users can focus the countries and region labels with Tab; on a touch screen, tap a region label.

STACKIT regions in Germany, Austria and the Netherlands EU01 is in Germany and EU02 in Austria. The supplied roadmap image also shows DE02 starting Q1 2027, NL01 starting Q3 2027 and DE03 starting Q3 2028. These are roadmap dates, not current availability. Focus EU01 or EU02 for documented region details. Germany: EU01, DE02 and DE03 DE02: roadmap image, starting Q1 2027 DE03: roadmap image, starting Q3 2028 EU01: Germany EU01 · Germany At least three physically separate availability zones. Independent power, cooling and network per AZ. Source: STACKIT regions documentation Netherlands: NL01 NL01: roadmap image, starting Q3 2027 Austria: EU02 EU02: Austria EU02 · Austria A physically separate region from EU01. At least three physically separate availability zones. Source: STACKIT regions documentation
OPS

STACKIT Serviceportfolio erkunden

PLAN

Landing Zone im Migration Framework einordnen

Eine Landing Zone ist die gemeinsame Startbahn für eine steuerbare Migration. Sie wird in Design and Mobilize als Plattformbasis etabliert, damit Migrationswellen auf einer funktionierenden Grundlage für kontrollierte Delivery und stabilen Betrieb aufbauen.

STACKIT Cloud Migration Framework Journey across the four phases Assess, Design and Mobilize, Migrate, and Run with their key modules. Assess PHASE 1 Assess Design & Mobilize PHASE 2 Design & Mobilize Migrate PHASE 3 Migrate Run PHASE 4 Run PLANUNG Discovery Discovery Apps und Abhängigkeiten erfassen. Design Design Ziel-Patterns definieren. Migration Plan Migration Plan Wellen und Reihenfolge planen. Rapid Discovery Rapid Discovery Workloads inventarisieren für eine frühe Scope- und Kosten-Baseline. TCO-Report TCO-Report Migrationskosten modellieren für Investitions- und Planungsentscheidungen. Readiness Assessment Readiness Assessment Technologie- und Organisationslücken vor dem Detail-Design bewerten. Deepdive-Workshop Deepdive-Workshop STACKIT-Services und Plattform-Optionen für das Zieldesign erkunden. Briefings & Workshops Briefings & Workshops Stakeholder zu Zielen, Scope und Migrations- Erwartungen ausrichten. Business Case Business Case Wert, Aufwand und Investition pro Applikation vergleichen. Enablement ENABLEMENT Center of Excellence Trainings & Learning Paths Documentation & Reference Landing Zone Landing Zone Sichere Plattform-Basis für migrierte Workloads aufbauen. Security & Compliance Security & Compliance Security- und Compliance- Kontrollen für Migration und Betrieb definieren. Target Operating Model Target Operating Model Rollen, Prozesse und Verantwortung für den Zielbetrieb definieren. Migration Factory Setup Migration Factory Setup Teams, Tools und Runbooks für die skalierbare Umsetzung vorbereiten. Migrate MIGRATE Relocate Relocate Rehost Rehost Replatform Replatform Optimize Optimize Sizing, Performance und Kosten nach dem Cutover optimieren. Repurchase Repurchase SaaS-Optionen bewerten, wenn ein Ersatz mehr Wert liefert. Refactor Refactor Strategische Workloads für Cloud-native Skalierbarkeit umbauen. Operating Model Handover Operating Model Handover TOM-Validierung und Ownership-Übergabe Hypercare Hypercare Stabilisierungsphase direkt nach dem Cutover. Operate Operate Stabiler Cloud-Regelbetrieb. Support Support Incidents und Service Requests über alle Support-Verantwortungen steuern. Customer Success Customer Success Adoption, Ergebnisse und Wertrealisierung mit Stakeholdern verfolgen.
Übersicht des Migration Frameworks mit der Phase Design and Mobilize
STEP

Platform Landing Zone definieren

Ordnen Sie die Landing Zone als strukturierte Cloud-Basis für einen steuerbaren STACKIT-Betrieb ein. Klären Sie früh, welche Leitplanken verbindlich sind, wer sie verantwortet und welche Anforderungen die Anwendungen mitbringen.

Design and mobilizeLanding ZonesÜbersicht In 6 Trails

Eine Landing Zone ist die strukturierte Cloud-Grundlage, die festlegt, wie Ihre Organisation auf STACKIT von Anfang an betrieben wird. Sie verbindet Governance, Identität, Security, Netzwerkarchitektur, Kostensteuerung und Automatisierung zu einem belastbaren Rahmen.

Ohne diese Grundlage stocken Migrationswellen typischerweise durch fehlende Freigaben, inkonsistente Kontrollen und wiederkehrende Plattformentscheidungen.

Die folgende Visualisierung zeigt die zentralen Komponenten für eine belastbare Plattform-Basis.

Landing-Zone-Kernkomponenten Sechs Bausteine einer sicheren Landing Zone. Landing-Zone-KernkomponentenDie sechs Bausteine einer sicheren Plattformbasis auf STACKIT.Account GovernanceAccount GovernanceWie strukturiere ich meine Projekte?Identity & Access ManagementIdentity & Access ManagementWer darf was tun auf der Plattform?Security und ComplianceSecurity und ComplianceWie überwache ich die Plattform sicher?NetzwerkarchitekturNetzwerkarchitekturWie sind Komponenten sicher verbunden?Kostensteuerung und KontrolleKostensteuerung und KontrolleWie behalte ich Ausgaben im Blick?Automatisierung (IaC)Automatisierung (IaC)Wie wird alles bereitgestellt?
  • Kontrolle und Risikoreduktion: Security- und Compliance-Kontrollen werden konsistent umgesetzt.
  • Skalierbare Delivery-Basis: Wiederverwendbare Muster beschleunigen mehrere Migrationswellen.
  • Klare Verantwortlichkeiten: Zuständigkeiten zwischen Plattform-, Security- und Applikationsteams sind klar.
  • Höhere Umsetzungsgeschwindigkeit: Grundlegende Kontrollen müssen nicht je Applikation neu entworfen werden.

Starten Sie den Landing-Zone-Stream so früh wie möglich parallel zum Discovery.

  • Zu spät: Produktive Migrationen werden blockiert, weil Pflichtkontrollen noch fehlen.
  • Zu früh ohne Discovery-Feedback: Relevante Applikationsrandbedingungen fehlen und führen zu Nacharbeit.

Bewährt hat sich ein zweigleisiges Vorgehen: Die Plattform-Basis früh etablieren und Application-Landing-Zone-Templates iterativ mit Discovery-Erkenntnissen verfeinern.

Zwei Ebenen: Platform und Application Landing Zone

Abschnitt betitelt „Zwei Ebenen: Platform und Application Landing Zone“

Platform Landing Zone

Unternehmensweite Grundlage für Governance, Identität, Security, Netzwerk, Kostensteuerung und Automatisierung.

Zur Platform Landing Zone

Application Landing Zone

Workload-spezifische Umsetzungsprofile, abgeleitet aus Plattform-Basis und Discovery-Ergebnissen.

Zur Application Landing Zone

Für ein belastbares Landing-Zone-Design werden typischerweise benötigt:

  • Organisations- und Ownership-Modell: Einheiten, Projektgrenzen und Verantwortungsmodell.
  • Compliance- und Policy-Anforderungen: Regulatorische Pflichten und interne Kontrollvorgaben.
  • Security-Anforderungen: IAM-Standards, Netzsegmentierung, Verschlüsselung und Logging.
  • Betriebs- und Supportvorgaben: Incident-Prozesse, Eskalationswege und Übergabemodell.
  • Erkenntnisse aus dem Applikationsportfolio: Discovery-Resultate zu Abhängigkeiten und Archetypen.
  1. Unternehmensweite Leitplanken und Kontrollmodell definieren.
  2. Platform Landing Zone als Code aufbauen und validieren.
  3. Application-Landing-Zone-Templates aus Discovery und Migrationsdesign ableiten.
  4. Mit Pilot-Workloads testen und über Migration-Factory-Runbooks skalieren.

Der Landing Zone Accelerator liefert wiederverwendbare Infrastrukturmodule und Referenztopologien. Der Landing Zone Configurator ergänzt geführte Konfiguration, assistentengestützte Prüfung, Veröffentlichung von Projekt-Templates und Applikations-Self-Service auf dieser Grundlage.

Die Praxis-Trails verbinden die Architektur mit den Bereitstellungsworkflows der Teams.

Cloud Framework Eine gesteuerte Plattform mit dem Configurator aufbauen Folgen Sie dem Platform-Engineer-Pfad von Anforderungen zu gemeinsamer Infrastruktur und wiederverwendbarem Projektkatalog. Seite öffnen Cloud Framework Application Landing Zone über Self-Service bereitstellen Folgen Sie dem Application-Owner-Pfad von der Template-Auswahl zur geprüften Bereitstellung und Workload-Übergabe. Seite öffnen

Die folgenden Assets liefern Umsetzungsgrundlagen und Bereitstellungsansätze:

Asset-Titel
Framework
Asset-Typ

BASE

Die Grenze der Platform Landing Zone festlegen

Erklären Sie gemeinsame Plattformaufgaben, Applikationsverantwortung und ihren Vertrag. Zentrales Audit Logging und die freigegebene Sandbox-Ausnahme machen die Grenze konkret.

Design and mobilizeLanding ZonesPlatform Landing Zone In 1 Trail

Die Platform Landing Zone ist die unternehmensweite Ziel-Basis für die Cloud-Nutzung auf STACKIT. Sie definiert die übergreifenden Kontrollen und Plattformleitplanken, die alle Produktteams übernehmen. Ohne diese Basis entstehen häufig inkonsistente Sicherheitsniveaus, doppelte Architekturentscheidungen und verzögerte Freigaben in den Migrationswellen.

Die Plattform verantwortet gemeinsame Regeln und Services; Applikationsteams verantworten ihre Workloads und Projekte innerhalb dieser Basis. Application Landing Zones nutzen diese Governance, statt sie erneut aufzubauen.

Beispiel und Übergabe: Der Platform Owner fordert zentrales Audit Logging für Applikationsprojekte und erlaubt eine separate Sandbox-Ausnahme. Die Plattform setzt Scope und Ziele um und übergibt geprüfte Referenzen und Leitplanken; Teams nutzen sie mit klarer Verantwortung, ohne die Regel zu ändern.

BASE

Account Governance strukturieren

Etablieren Sie Organisationsstruktur, Projektgrenzen und ein Ownership-Modell, damit Landing-Zone-Governance über Teams und Umgebungen hinweg wiederholbar bleibt.
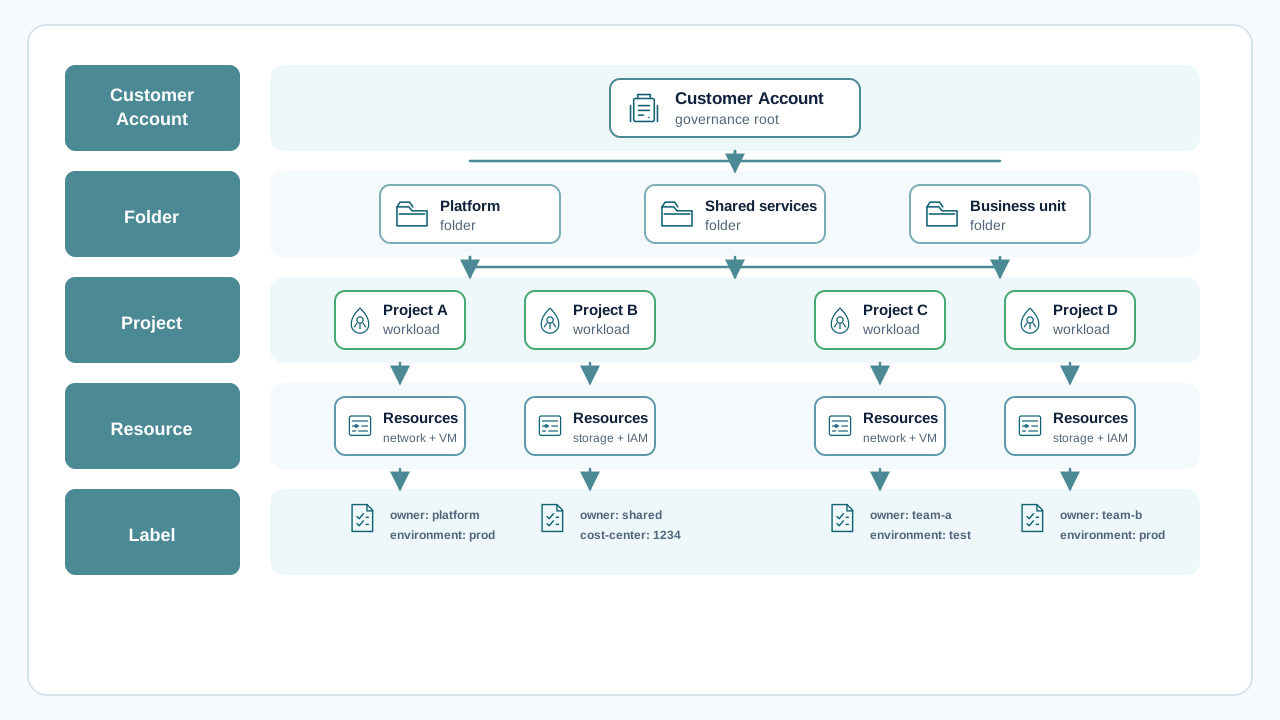
Design and mobilizeLanding ZonesAccount Governance In 3 Trails
Governance-Hierarchie vom Customer Account über Folder zu Projects und Ressourcen
  • Regions: Die Regionenstrategie bestimmt Datenlokalität, Latenzprofil und Resilienzgrenzen für Workloads und Shared Services. Definieren Sie früh verbindliche Nutzungsmuster und stimmen Sie diese mit Compliance- und Kontinuitätsanforderungen ab. Dokumentation
  • Customer Account: Der Customer Account ist die oberste Governance-Grenze für Ownership, Abrechnung und Administration. Er bildet den Anker für organisationsweite Standards und Kontrollverantwortung. Dokumentation
  • STACKIT Folder: Folder strukturieren organisatorische Domänen (zum Beispiel Plattform, Shared Services, Business Units, Umgebungen) und ermöglichen Policy-Vererbung sowie klare Delegationsmodelle. Dokumentation
  • STACKIT Projects: Projects sind die Delivery-Scopes, in denen Ressourcen bereitgestellt und betrieben werden. Sie sollten über ein definiertes Onboarding-Modell an Folder angebunden werden und nicht ad hoc entstehen. Dokumentation
  • Regionprinzipien zuerst: Legen Sie fest, welche Regionen für welche Workload-Klassen zulässig sind.
  • Customer Account als Governance-Root: Verankern Sie globale Ownership, Policy-Absicht und finanzielle Verantwortlichkeit.
  • Folder für Struktur und Delegation: Überführen Sie das Betriebsmodell in skalierbare organisatorische Grenzen.
  • Projects für Delivery: Stellen Sie Projektscopes über einen standardisierten Lebenszyklus mit verpflichtenden, vom Folder geerbten Kontrollen bereit.
  • Region-Governance-Modell: Entscheiden Sie zwischen Single-Region-, Dual-Region- oder Workload-basiertem Regionenansatz inklusive Ausnahmen.
  • Customer-Account-Verantwortung: Definieren Sie, welche zentralen Teams Governance, Billing-Transparenz und Kontrollbetrieb verantworten.
  • Folder-Topologie: Legen Sie fest, wie Folder auf Domänen wie Plattform, Umgebungen und Business Units abgebildet werden.
  • Project-Onboarding-Modell: Standardisieren Sie Projekterstellung, Namenskonventionen, Tagging und Lebenszyklus-Kontrollen.
  • Policies und Ausnahmen: Definieren Sie verpflichtende Guardrails und transparente Ausnahmeprozesse.
  • Governance-Blueprint: Customer-Account-, Folder- und Project-Topologie mit Verantwortungsmatrix.
  • Regionen-Nutzungsrichtlinie: Freigegebene Regionenmuster je Workload-Typ und Risikoprofil.
  • Project-Onboarding-Standard: Wiederholbarer Prozess für die Erstellung und Anbindung gesteuerter Projekte.
  • Control-Baseline: Erzwungene Namens-, Tagging- und Policy-Kontrollen mit dokumentiertem Ausnahmefluss.
  • Keine Regionenrichtlinie: Regionauswahl pro Team oder Projekt ohne unternehmensweite Leitplanken.
  • Unstrukturierte Project-Sprawl: Projekte entstehen ohne Folder-Strategie, klare Ownership oder Lebenszyklusstandards.
  • Governance nur auf Papier: Kontrollen sind dokumentiert, aber nicht im Projekt-Onboarding und Betrieb verankert.
STACKIT LogoSTACKIT Logo
Identity and Access Management STACKIT · Design And Mobilize › Landing Zones Open page ↗

IAM stellt sicher, dass Zugriffe eindeutig zugeordnet, nachvollziehbar und auf das notwendige Maß begrenzt sind.

Für Migrations-Landing-Zones ist IAM das zentrale Kontrollrückgrat, das menschliche Identitäten, technische Identitäten und Autorisierungsregeln in ein steuerbares Betriebsmodell überführt.

  • Access and Identity (zentrale Domäne): Nutzen Sie die Plattformdomäne als zentrale Referenz für IAM-Funktionen und Betriebsverantwortung. Dokumentation
  • STACKIT IDP: Nutzen Sie den STACKIT IDP als Identitäts-Kontrollpunkt für Authentifizierung und Account-Zugriffsflüsse. Dokumentation
  • Federation (SAML 2.0): Integrieren Sie Unternehmensidentitäten per Föderation, um zentrale Identity-Lifecycles durchzusetzen und lokale Account-Sprawl zu reduzieren. Dokumentation
  • Roles and Permissions: Definieren Sie rollenbasierte Autorisierungsgrenzen für Plattformteams, Applikationsteams und Betrieb. Dokumentation
  • Custom Roles: Implementieren Sie Least-Privilege-Muster, wenn Standardrollen für Enterprise-Kontrollen zu weit gefasst sind. Dokumentation
  • Service Accounts: Trennen Sie technische Identitäten von Benutzeridentitäten für Automatisierung, CI/CD und betriebliche Integrationen. Dokumentation
  • Identitätsquelle und Vertrauen: STACKIT IDP plus Federation legen fest, wer authentifiziert wird und unter welchen Unternehmensrichtlinien.
  • Autorisierungsmodell: Roles and Permissions definieren, wer in welchem Governance-Scope welche Aktionen ausführen darf.
  • Least-Privilege-Verfeinerung: Custom Roles schließen Berechtigungslücken, wenn Standardrollen Anforderungen zur Aufgabentrennung nicht abdecken.
  • Automatisierungs-Identitätsmodell: Service Accounts liefern nicht-menschliche Identitäten für wiederholbaren Betrieb ohne persönliche Zugangsdaten.
  • Identity-Integrationsansatz: Entscheiden Sie, wie Unternehmensidentitäten föderiert werden und wie Lifecycle-Ereignisse synchronisiert sind.
  • Rollenarchitektur je Scope: Definieren Sie Rollengrenzen für Plattform, Security, Betrieb und Applikationsteams.
  • Custom-Role-Strategie: Legen Sie fest, wann Custom Roles erforderlich sind und wie sie geprüft und freigegeben werden.
  • Kontrollen für privilegierten Zugriff: Definieren Sie Freigabe-Workflows, temporäre Erhöhung und Notfallzugriffsprozesse.
  • Service-Account-Governance: Standardisieren Sie Erstellung, Ownership, Credential-Rotation und Nachverfolgbarkeit technischer Identitäten.
  • IAM-Architektur-Baseline: Föderiertes Authentifizierungsmodell mit dokumentierten Vertrauensgrenzen.
  • Rollen- und Berechtigungsmatrix: Zuordnung von Standard- und Custom-Rollen pro organisatorischem Scope.
  • Service-Identity-Standard: Guardrails für Service Accounts in Automatisierung und Plattformbetrieb.
  • Operatives IAM-Betriebsmodell: Verfahren für privilegierten Zugriff, Freigaben und Notfallzugriffe.
  • Keine Föderationsstrategie: Lokale Identitätssilos und inkonsistentes Lifecycle-Handling.
  • Überprivilegierte Standardrollen: Breite Berechtigungen ohne Custom-Least-Privilege-Kontrollen.
  • Geteilte privilegierte Benutzerkonten: Administrative Aktionen sind keiner eindeutig verantwortlichen Identität zuordenbar.
  • Automatisierung mit menschlichen Identitäten: Pipelines und Integrationen laufen unter persönlichen Konten statt Service Accounts.
SAFE

Security- und Compliance-Themen

Nutzen Sie diese semantische Karte als strukturierten Einstieg in alle Themen dieses Moduls.

Seitlich wischen, um das ganze Diagramm zu sehen
Sicherheit und Compliance Wählen Sie einen Themencluster und springen Sie direkt zur passenden Unterseite. Sicherheit und ComplianceWählen Sie einen Themencluster und springen Sie direkt zur passenden Unterseite.Steuerung und MigrationsbetriebsmodellBetriebsmodell und SteuerungBetriebsmodell und SteuerungRollen, Prüfpunkte, Verantwortung und EntscheidungenÜbergang in die CloudÜbergang in die CloudKontrollübersetzung und neue VerantwortungenSicherheitsarchitektur und Design-BasisArchitekturmusterArchitekturmusterBoundary-zentriert und Zero Trust kombiniertSicherheitsgrundsätzeSicherheitsgrundsätzeVerbindliche Basiskontrollen je BereichCompliance-Nachweise und SouveränitätKontrollen und NachweiseKontrollen und NachweisePräventive, detektive Kontrollen und EvidenzSouveränität und CSF-AbgleichSouveränität und CSF-AbgleichCSF-Abgleich, ES3 und PrüfbarkeitZero-Trust-VertiefungFünf Fokusbereiche für Umsetzung und Kontrollen.Zero Trust für MenschenZero Trust für MenschenIdentitätslebenszyklus, privilegierte Zugriffe, HygieneZero Trust für GeräteZero Trust für GeräteGerätezustand, Endpunkt-Härtung, sichere AdministrationZero Trust für NetzeZero Trust für NetzeSegmentierung, Verkehrsrichtlinien, KonnektivitätZero Trust für WorkloadsZero Trust für WorkloadsLaufzeit-Härtung, Least Privilege, IsolationZero Trust für DatenZero Trust für DatenKlassifizierung, Verschlüsselung, Schlüssel, Aufbewahrung
SAFE

Sicherheit und Compliance Themen

Ordnen Sie Sicherheits- und Compliance-Themen früh ein, damit Kontrollanforderungen, Nachweise, Souveränitätsentscheidungen und Zero-Trust-Prinzipien in das Landing-Zone-Design einfließen.

Design and mobilizeSicherheit und ComplianceÜbersicht In 1 Trail

Nutzen Sie diese semantische Karte als strukturierten Einstieg in alle Themen dieses Moduls.

Seitlich wischen, um das ganze Diagramm zu sehen
Sicherheit und Compliance Wählen Sie einen Themencluster und springen Sie direkt zur passenden Unterseite. Sicherheit und ComplianceWählen Sie einen Themencluster und springen Sie direkt zur passenden Unterseite.Steuerung und MigrationsbetriebsmodellBetriebsmodell und SteuerungBetriebsmodell und SteuerungRollen, Prüfpunkte, Verantwortung und EntscheidungenÜbergang in die CloudÜbergang in die CloudKontrollübersetzung und neue VerantwortungenSicherheitsarchitektur und Design-BasisArchitekturmusterArchitekturmusterBoundary-zentriert und Zero Trust kombiniertSicherheitsgrundsätzeSicherheitsgrundsätzeVerbindliche Basiskontrollen je BereichCompliance-Nachweise und SouveränitätKontrollen und NachweiseKontrollen und NachweisePräventive, detektive Kontrollen und EvidenzSouveränität und CSF-AbgleichSouveränität und CSF-AbgleichCSF-Abgleich, ES3 und PrüfbarkeitZero-Trust-VertiefungFünf Fokusbereiche für Umsetzung und Kontrollen.Zero Trust für MenschenZero Trust für MenschenIdentitätslebenszyklus, privilegierte Zugriffe, HygieneZero Trust für GeräteZero Trust für GeräteGerätezustand, Endpunkt-Härtung, sichere AdministrationZero Trust für NetzeZero Trust für NetzeSegmentierung, Verkehrsrichtlinien, KonnektivitätZero Trust für WorkloadsZero Trust für WorkloadsLaufzeit-Härtung, Least Privilege, IsolationZero Trust für DatenZero Trust für DatenKlassifizierung, Verschlüsselung, Schlüssel, Aufbewahrung
STACKIT LogoSTACKIT Logo
Sicherheit und Compliance STACKIT · Design And Mobilize › Landing Zones Open page ↗

In Landing Zones sind Sicherheit und Compliance verbindliche Leitlinien für die Umsetzung, die aus dem eigenständigen Modul abgeleitet werden.

Nutzen Sie diese Seite für die konkrete Anwendung in Platform- und Application-Landing-Zones.

  • Audit Logging: Nutzen Sie zentrales Audit Logging als autoritative Quelle für sicherheitsrelevante Plattformaktionen und administrative Änderungen. Dokumentation
  • Telemetry Router: Leiten und normalisieren Sie Telemetrieströme, damit Logs und Metriken aus verteilten Workloads konsistent erfasst werden. Dokumentation
  • Logs: Etablieren Sie zentrale Muster für Log-Erfassung zur operativen und sicherheitsbezogenen Analyse. Dokumentation
  • Observability: Entwerfen Sie Observability als Schichtenmodell: Application Logs je Anwendung plus zentrales Audit Logging und Plattformtelemetrie für Governance und Incident-Analyse. Dokumentation
  • Netzwerksicherheit: Wenden Sie Härtungsprinzipien für Segmentierung, kontrollierte Verkehrsflüsse und reduzierte Angriffsflächen an. Dokumentation
  • Sicherheit für Compute-Ressourcen: Definieren Sie Härtungsstandards für Workloads und sichere Praktiken für die Laufzeit von Compute-Ressourcen. Dokumentation
  • Secrets Manager: Speichern und verwalten Sie sensible Zugangsdaten und Geheimnisse von Anwendungen über gemanagte Kontrollen statt ad hoc. Dokumentation
  • KMS: Steuern Sie Schlüssellebenszyklen und Verschlüsselungs-Governance über einen zentralen Key-Management-Ansatz. Dokumentation
  • ACL-Muster für PaaS-Services: Nutzen Sie servicebezogene Access Control Lists, um Verbindungswege zu gemanagten Services zu begrenzen. PostgreSQL ist ein Beispiel, das Muster gilt jedoch für STACKIT-PaaS-Services allgemein. PostgreSQL-Referenz: Dokumentation .
  • Unified Firewall: Nutzen Sie zentrale Firewall-Kontrollen für konsistente Netzwerk-Policy-Durchsetzung über Zonen und Workloads hinweg. Dokumentation
  • Nachweis- und Erkennungsschicht: Audit Logging, Logs, Telemetry Router und Observability bilden die Datengrundlage für Compliance-Nachweise und Incident-Analyse.
  • Präventive Härtungsschicht: Netzwerksicherheit, Sicherheit für Compute-Ressourcen, Unified Firewall und Service-ACLs reduzieren Exposition und erzwingen freigegebene Verkehrs- und Grenzen für die Laufzeit.
  • Datenschutzschicht: Secrets Manager und KMS schützen sensitive Datenpfade und kryptografische Assets über den gesamten Workload-Lebenszyklus.
  • Betriebsmodell: Applikationsteams liefern Workload-Telemetrie, zentrale Teams verantworten die gemeinsame Audit- und Governance-Sicht.
  • Grenzen der Logging-Architektur: Definieren Sie, was auf Applikations-, Plattform- und Audit-Ebene geloggt wird und wo jeder Stream aufbewahrt wird.
  • Telemetry- und Observability-Modell: Legen Sie Routing, Enrichment und Ownership für Logs, Metriken und Traces fest.
  • Hardening-Baseline-Umfang: Definieren Sie verpflichtende Kontrollen für Netzwerk- und Compute-Domänen inklusive Firewall- und Service-ACL-Mustern.
  • Geheimnis- und Schlüssel-Governance: Standardisieren Sie Nutzung, Verantwortlichkeit und Lebenszyklus-Verantwortung für Secrets Manager und KMS.
  • Compliance-Betriebsmodell: Definieren Sie, wer Nachweiserhebung, Kontrollverifikation und Reporting-Takt verantwortet.
  • Sicherheits-Basiskatalog: Kontrollen für Netzwerk, Compute, Identität und Datenschutz.
  • Logging- und Nachweisarchitektur: Zentrales Audit Logging plus Workload-Observability mit klaren Ownership-Grenzen.
  • Geheimnis- und Verschlüsselungsstandard: Definiertes Nutzungsmodell für Secrets Manager, KMS und den Lebenszyklus von Schlüsseln und Geheimnissen.
  • Response- und Eskalationsmodell: Operative Runbooks für Erkennung, Bewertung und Incident-Reporting.
  • Sicherheit erst in späten Migrationsphasen: Kontrollen werden nach dem Workload-Onboarding statt von Anfang an eingeführt.
  • Entkoppelte Telemetrie-Stacks: Audit-, Plattform- und Applikationssignale sind bei Incidents nicht korrelierbar.
  • Secrets im Code oder in ungemanagten Stores: Sensitive Werte werden nicht über dediziertes Secret Management gesteuert.
  • Flacher Netzwerkzugriff ohne Service-Kontrollen: Fehlende Firewall- und ACL-Grenzen erlauben übermäßige laterale Bewegung.
LIFT

Netzwerkarchitektur gestalten

Definieren Sie Segmentierung, Connectivity, DNS, Routing und sichere Kommunikationsmuster für Shared Services und Workload-Umgebungen.
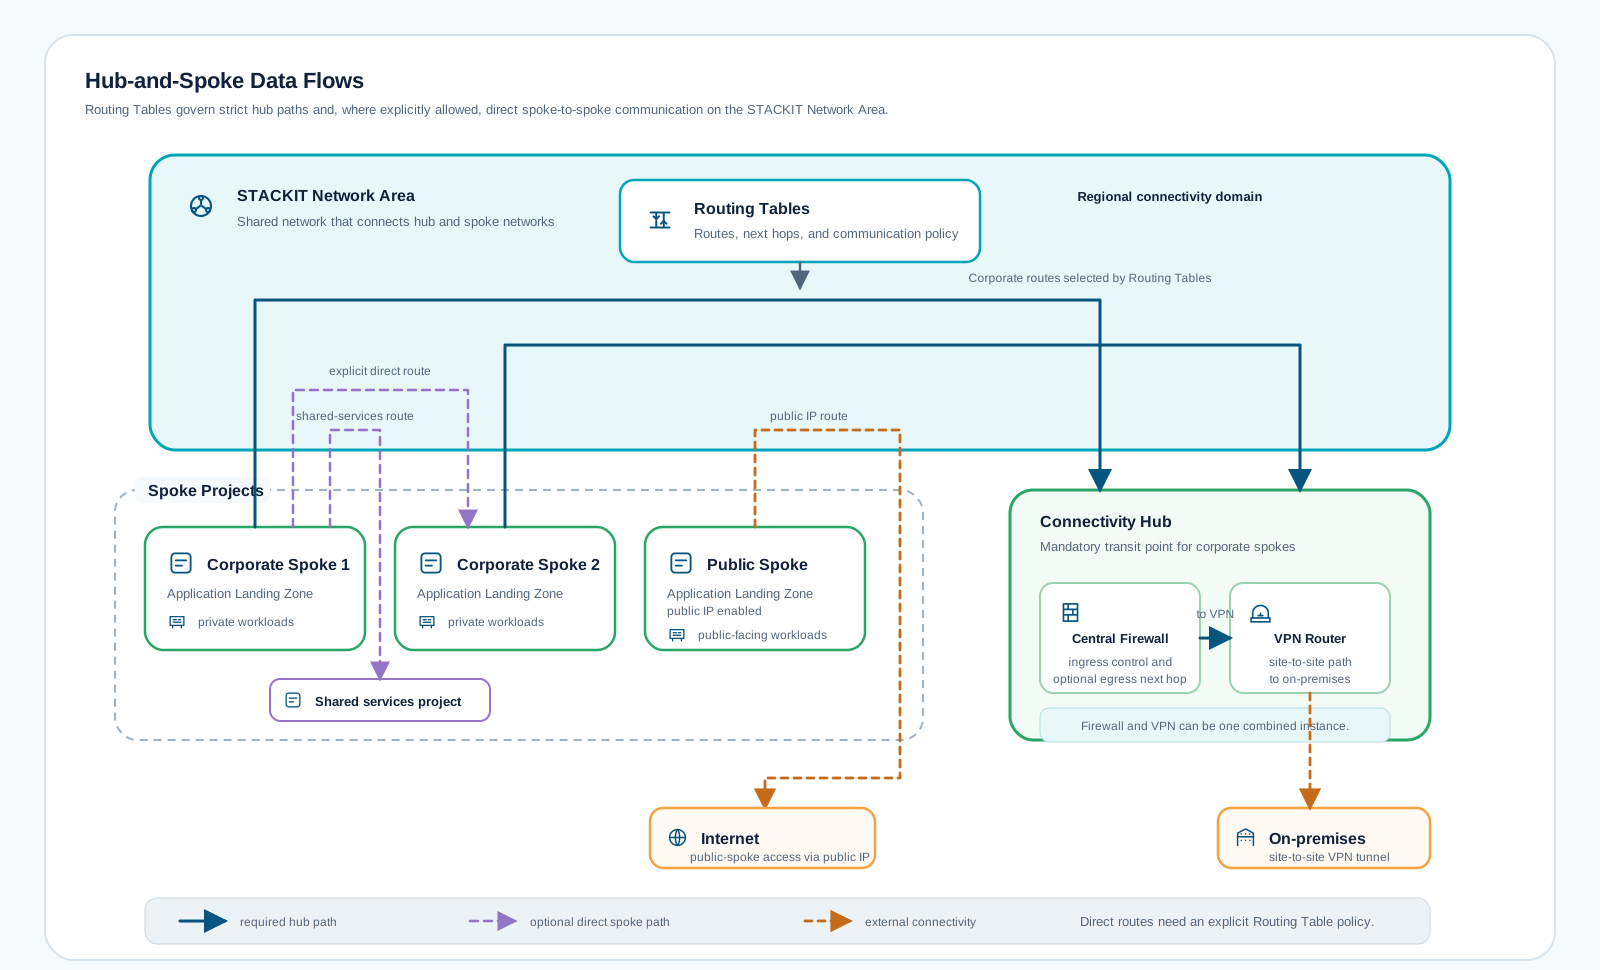
Design and mobilizeLanding ZonesNetzwerkarchitektur In 3 Trails
Network-Area-Hub-and-Spoke-Architektur mit zentraler Firewall und VPN-Router
  • STACKIT Network Area: Nutzen Sie eine geteilte Unternehmens-Netzwerkscope als zentrales Rückgrat für Projektanbindung und Governance-Planung. Dokumentation
  • Routing Tables: Definieren und erzwingen Sie, wie Projekte innerhalb einer Network Area verbunden sind und ob ein Hub-and-Spoke-Modell mit zentraler Firewall-Kontrolle oder eine flachere Topologie genutzt wird. Dokumentation
  • DNS: Standardisieren Sie Namensgebung und Service Discovery frühzeitig, damit Connectivity-Design, Zertifikatshandling und Workload-Cutovers konsistent bleiben. Dokumentation
  • VPN (Connectivity): Behandeln Sie VPN als zentrale Connectivity-Fähigkeit für Hybrid- und Multi-Cloud-Integrationsmuster, nicht als isolierte Einzellösung. Dokumentation
  • Network-Area-Ownership-Modell: Entscheiden Sie, wer geteilte Connectivity zentral steuert und welche Onboarding-Kriterien für angebundene Projekte gelten.
  • Routing-Strategie je Domäne: Legen Sie fest, wo Hub-and-Spoke mit zentraler Inspektion verpflichtend ist und wo eine flache Routing-Topologie ausreicht.
  • Hybrid-Connectivity-Baseline: Definieren Sie, wie VPN-basierte Konnektivität in Plattformstandards und Betriebs-Lifecycle integriert wird.
  • Namensauflösungsdesign: Standardisieren Sie DNS-Grenzen und Muster für Plattformservices, Shared Services und Applikations-Landing-Zones.
  • Zieltopologie und Vertrauensgrenzen: Dokumentierter Zielzustand für Segmentierung und projektübergreifende Kommunikation.
  • Network-Area-Onboarding-Prinzipien: Klare Kriterien, welche Projekte angebunden werden, wie Reviews ablaufen und wie Änderungen freigegeben werden.
  • Routing-Governance-Modell: Definierter Einsatz von Routing Tables inklusive Entscheidungskriterien für Hub-and-Spoke versus flaches Routing.
  • Connectivity-Baseline: Wiederverwendbare Standards für VPN, DNS und gemeinsame Netzwerk-Services.
Asset-Titel
Framework
Asset-Typ

  • Ungeplantes Wachstum der Network Area: Projekte werden ohne zentrale Architekturprüfung und Ownership angebunden.
  • Ad-hoc-Einsatz von Routing Tables: Inkonsistente Routing-Logik je Projekt ohne Referenzarchitektur.
  • DNS als Nachgedanke: Späte DNS-Entscheidungen bremsen Migrationstermine oder stören Service Discovery.
  • VPN als Ausnahmepfad: VPN wird als Sonderlösung statt als geregelte Grundlage für die Konnektivität genutzt.
STACKIT LogoSTACKIT Logo
Kostensteuerung und Kontrolle STACKIT · Design And Mobilize › Landing Zones Open page ↗

Kostensteuerung macht Cloud-Ausgaben über Migrationswellen und Regelbetrieb transparent, zurechenbar und aktiv steuerbar.

Für Migrations-Landing-Zones braucht es dafür ein gemeinsames finanzielles Steuerungsmodell über Plattformteams, Anwendungs-Teams und Business-Stakeholder hinweg.

  • Costs and Billing (zentrale Domäne): Nutzen Sie die Cost-and-Billing-Domäne als zentrale Grundlage für Kostentransparenz, Governance-Rollen und Reporting-Logik. Dokumentation
  • Billing Accounts: Definieren Sie Billing Accounts als strukturelle Grenzen für Ownership, Abrechnung und finanzielle Verantwortlichkeit. Dokumentation
  • FOCUS: Nutzen Sie das FOCUS-Modell zur Standardisierung und Normalisierung von Kostendaten für transparente Analysen und teamübergreifendes Finanz-Reporting. Dokumentation
  • Resource Labeling: Erzwingen Sie konsistente Labels, um technische Nutzung verlässlich Teams, Produkten, Umgebungen und Kostenstellen-IDs zuzuordnen. Dokumentation
  • Finanzstruktur-Ebene: Billing Accounts legen fest, wo Kosten anfallen und wer dafür verantwortlich ist.
  • Datenstandardisierungs-Ebene: FOCUS liefert ein konsistentes Kostenmodell über Services und Teams hinweg.
  • Zuordnungs- und Ownership-Ebene: Resource Labels verbinden Cloud-Nutzung mit fachlicher und technischer Verantwortung.
  • Betriebs-Ebene (FinOps): FinOps etabliert einen wiederkehrenden Zyklus aus Transparenz, Optimierungsmaßnahmen und Ownership-Tracking.

FinOps sollte von Beginn an in das Landing-Zone-Design integriert werden und nicht erst nach dem Start von Migrationswellen.

  • Transparenz: Gemeinsame Sichtbarkeit für Plattform-, Shared-Service- und Workload-Kosten aufbauen.
  • Verantwortung: Klare Zuständigkeiten je Billing Account, Team und Service-Domäne festlegen.
  • Optimierung: Ein aktives Optimierungs-Backlog mit regelmäßigem Review-Rhythmus betreiben.
  • Governance: Budgetgrenzen und Eskalationswege mit benannten Verantwortlichen und Entscheider-Kreis verknüpfen.
  • Grenzen der Zuordnung: Festlegen, wie Ausgaben auf Billing Accounts, Produkte, Teams und Umgebungen verteilt werden.
  • Standardisierung der Daten: Entscheiden, wie FOCUS und interne Reporting-Dimensionen konsistent umgesetzt werden.
  • Label-Strategie: Pflicht-Labels und Qualitätskontrollen für verlässliche Zuordnung und Chargeback/Showback definieren.
  • Budget- und Eskalationsmodell: Schwellenwerte, Verantwortlichkeiten und Reaktions-Workflows festlegen.
  • FinOps-Rhythmus: Review-Frequenz, Optimierungs-Governance und Nachverfolgung realisierter Einsparungen definieren.
  • Kostentaxonomie und Ownership-Modell: Standardisierte Zuordnung über Billing Accounts, Labels und verantwortliche Teams.
  • Kosten-Reporting-Baseline: FOCUS-ausgerichtete finanzielle Sicht für Trendanalysen und Stakeholder-Reporting.
  • Budget-Guardrails: Definierte Schwellwerte mit dokumentierter Eskalation und Entscheidungs-Ownership.
  • FinOps-Betriebsmodell: Regelmäßiger Review-Rhythmus mit priorisiertem Optimierungs-Backlog und Outcome-Tracking.
  • Keine Billing-Account-Strategie: Kosten sind nur aggregiert sichtbar und nicht klar verantwortbar.
  • Inkonsistente oder fehlende Labels: Nutzung kann Produkten, Teams oder Umgebungen nicht verlässlich zugeordnet werden.
  • Keine Standardisierung von Daten: Kostenübersichten unterscheiden sich je Team und sind nicht belastbar vergleichbar.
  • FinOps nur als Reporting: Kein wiederkehrender Ablauf für Optimierung und keine Ownership für Verbesserungsmaßnahmen.
STACKIT LogoSTACKIT Logo
Automatisierung (IaC) STACKIT · Design And Mobilize › Landing Zones Open page ↗

Automatisierung stellt sicher, dass Landing-Zone-Funktionen reproduzierbar, versioniert und testbar bereitgestellt werden.

Für Migrations-Landing-Zones ist Automatisierung das Delivery-Rückgrat, das Plattform-APIs, IaC-Werkzeuge, Entwickler-Workflows und Release-Kontrollen in ein verlässliches Betriebsmodell überführt.

  • STACKIT API: Nutzen Sie die API als grundlegende Steuerungsschnittstelle für Plattformautomatisierung und Integrationsmuster. Dokumentation
  • Terraform Provider: Nutzen Sie den offiziellen Provider für deklarative Infrastruktur-Bereitstellung und Lifecycle-Steuerung. Dokumentation
  • OpenTofu Provider: Nutzen Sie OpenTofu mit dem STACKIT Provider als offene IaC-Option mit vergleichbaren deklarativen Workflows. Dokumentation
  • Pulumi: Nutzen Sie Pulumi, wenn Teams für Infrastruktur-Automatisierung allgemeine Programmiersprachen bevorzugen. Dokumentation
  • Ansible: Nutzen Sie Ansible primär für Post-Provisioning-Konfiguration und Betriebsaufgaben. In einem kombinierten Modell stellen Terraform/OpenTofu die Infrastruktur bereit, während Ansible OS- und Middleware-Konfiguration übernimmt.
  • STACKIT CLI: Standardisieren Sie CLI-basierte Operationen für Skripting, Fehleranalyse und wiederholbare Betriebsaufgaben. Dokumentation
  • SDKs (Go, Python, Java): Nutzen Sie SDKs für kundenspezifische Automatisierung und Service-Integrationen, wenn IaC-Abstraktionen nicht ausreichen. Go SDK , Python SDK , Java SDK .
  • STACKIT Git: Nutzen Sie Git als Source of Truth für IaC-Module, Policies und Delivery-Workflows. Dokumentation
  • CI/CD Pipeline: Nutzen Sie Pipelines für Validierung, Policy-Prüfungen, kontrollierte Promotion und auditierbare Releases. Dokumentation
  • Container Registry: Nutzen Sie eine zentrale Registry für versionierte Build-Artefakte und konsistente Deployments über Umgebungen hinweg. Dokumentation
  • Steuerungsschicht: STACKIT API, CLI und SDKs liefern direkte und programmierbare Steuerungsschnittstellen.
  • Provisioning-Schicht: Terraform/OpenTofu und Pulumi definieren und synchronisieren den gewünschten Infrastrukturzustand.
  • Konfigurationsschicht: Ansible setzt Host- und Middleware-Konfiguration nach dem Infrastruktur-Provisioning um.
  • Delivery-Schicht: Git und CI/CD Pipelines erzwingen Qualitäts-Gates, Policy-Prüfungen und kontrollierten Rollout über Umgebungen.
  • Artefakt-Schicht: Die Container Registry liefert unveränderliche und versionierte Artefakte für vorhersehbare Deployments.

Der STACKIT Landing Zone Accelerator liefert wiederverwendbare OpenTofu-/Terraform-Module für die Plattform- und Applikationsprojektbasis. Teams nutzen native Eingaben über CLI und eigene Bereitstellungspipelines, einschließlich eines separaten Application-Roots mit eigenem State.

Der STACKIT Landing Zone Configurator bietet einen geführten Workflow auf derselben Grundlage: Konfiguration bearbeiten und prüfen, wiederverwendbare Projekt-Templates veröffentlichen und Infrastrukturänderungen vor der ausdrücklichen Apply-Freigabe vorbereiten und bewerten. Sein isolierter Runner führt den versionierten Accelerator mit OpenTofu aus.

Vereinbaren und dokumentieren Sie je Umgebung Änderungsverantwortung und Bereitstellungsweg. Konfigurationsexporte und optionale GitHub-Versionierung verbinden den geführten Workflow mit dem IaC-Prozess des Teams.

Cloud Framework Workflow für Plattformkonfiguration und Bereitstellung Von Unternehmensanforderungen über geprüfte Plan- und Apply-Schritte zur Veröffentlichung von Projekt-Templates. Seite öffnen

Terraform oder OpenTofu und Ansible lösen unterschiedliche Aufgaben innerhalb eines Delivery-Flows. Halten Sie die Grenze explizit, damit Infrastrukturänderungen prüfbar und Host-Konfigurationen wiederholbar bleiben.

Terraform / OpenTofu

Verantwortet den Infrastruktur-Lifecycle: Projekte, Netzwerke, Sicherheitskontrollen, Compute, Storage, Managed Services und die für das Konfigurationsmanagement benötigten Outputs.

Ansible

Verantwortet die Konfiguration im erreichbaren Ziel: Betriebssystempakete, Middleware, Applikationsartefakte, Service Units und die Validierung auf Workload-Ebene.

  1. Versionieren Sie Infrastruktur-Inputs, Konfiguration und Referenzen auf Applikationsartefakte in Git.
  2. Validieren und prüfen Sie den Terraform/OpenTofu-Plan einschließlich Ersetzungen und Security-Auswirkungen.
  3. Wenden Sie den freigegebenen Plan an und übergeben Sie nur das von Ansible benötigte Zielinventar und die erforderlichen Outputs.
  4. Führen Sie Ansible idempotent aus, um Betriebssystem, Middleware, Workload und Telemetrie zu konfigurieren.
  5. Validieren Sie Infrastrukturzustand, Service Health und betriebliche Kontrollen und bewahren Sie die Nachweise auf.
  6. Promoten Sie denselben versionierten Workflow durch die Umgebungen, statt manuelle Einrichtungsschritte zu wiederholen.

Verwischen Sie die Zuständigkeit beider Ebenen nicht durch Provisioner oder Ad-hoc-Skripte. Ansible aus Terraform anzustoßen kann eine praktische Brücke sein, aber jedes Werkzeug muss eigenständig verständlich, testbar und wiederholbar bleiben.

  • Empfehlung 1: Nutzen Sie Git plus CI/CD als Standard-Steuerungspfad und vermeiden Sie direkte manuelle Änderungen in produktiven Scopes.
  • Empfehlung 2: Wählen Sie je Plattformdomäne ein primäres IaC-Tool (Terraform oder OpenTofu), um Fragmentierung zu reduzieren.
  • Empfehlung 3: Nutzen Sie Ansible für Konfigurationsmanagement, nicht als Ersatz für deklaratives Infrastruktur-Provisioning.
  • Empfehlung 4: Nutzen Sie SDKs für domänenspezifische Automatisierung, wenn Provider-Ressourcen das gewünschte Verhalten nicht abdecken.
  • Empfehlung 5: Versionieren und promoten Sie Container-Artefakte über klare Umgebungsstufen mit rollbackfähigen Tags.
  • Automatisierungs-Schnittstellenstrategie: Definieren Sie, wo API, CLI, SDK und IaC-Werkzeuge als Primärschnittstellen eingesetzt werden.
  • IaC-Tool-Strategie: Entscheiden Sie Terraform versus OpenTofu versus Pulumi anhand von Skills, Governance und Ecosystem-Fit.
  • Modul- und Repository-Strategie: Definieren Sie wiederverwendbare Modulgrenzen, Versionierung und Ownership.
  • Pipeline-Control-Modell: Implementieren Sie Validierung, Policy-Prüfungen, Freigaben und Promotion-Gates.
  • Artefakt- und Release-Strategie: Definieren Sie Registry-Nutzung, Image-Versionierung und Rollback-Standards.
  • Wiederverwendbare Automatisierungs-Baseline: IaC-Module, Templates und Konfigurations-Playbooks mit Ownership-Modell.
  • Delivery-Blueprint: CI/CD-Flow mit Qualitäts-Gates, Policy-Prüfungen und gestufter Promotion.
  • Integrations-Toolkit: Standardisierte Nutzung von CLI- und SDK-Automatisierung für Betrieb und produktspezifische Workflows.
  • Release-Baseline: Versionierter Artefakt-Lifecycle in der Container Registry mit rollbackfähigen Praktiken.
  • Zu viele Automatisierungs-Paradigmen: Parallele Tool-Stacks ohne klare Ownership oder Governance-Modell.
  • Provisioning und Konfiguration ad hoc vermischt: Keine klare Trennung zwischen IaC-Provisioning und Ansible-Konfiguration.
  • Keine Artefakt-Disziplin: Veränderliche Container-Tags und unklare Release-Nachverfolgbarkeit.
  • CLI-Skripte ohne Git- und Pipeline-Kontrollen: Betriebsautomatisierung ist nicht verlässlich auditierbar oder reproduzierbar.
STACKIT LogoSTACKIT Logo
Platform Landing Zone STACKIT · Design And Mobilize › Landing Zones Open page ↗

Die Platform Landing Zone ist die unternehmensweite Ziel-Basis für die Cloud-Nutzung auf STACKIT. Sie definiert die übergreifenden Kontrollen und Plattformleitplanken, die alle Produktteams übernehmen. Ohne diese Basis entstehen häufig inkonsistente Sicherheitsniveaus, doppelte Architekturentscheidungen und verzögerte Freigaben in den Migrationswellen.

Die Plattform verantwortet gemeinsame Regeln und Services; Applikationsteams verantworten ihre Workloads und Projekte innerhalb dieser Basis. Application Landing Zones nutzen diese Governance, statt sie erneut aufzubauen.

Beispiel und Übergabe: Der Platform Owner fordert zentrales Audit Logging für Applikationsprojekte und erlaubt eine separate Sandbox-Ausnahme. Die Plattform setzt Scope und Ziele um und übergibt geprüfte Referenzen und Leitplanken; Teams nutzen sie mit klarer Verantwortung, ohne die Regel zu ändern.

STACKIT LogoSTACKIT Logo
Platform Landing Zone STACKIT · Design And Mobilize › Landing Zones Open page ↗
  • Organisationsmodell: Geschäftsbereiche, Ownership-Grenzen und Umgebungsstrategie.
  • Regulatorische Vorgaben: Branchenanforderungen, Audit-Scope und Nachweispflichten.
  • Security-Standards: Identitätsmodell, Verschlüsselungsstandards, Secret-Handling und Incident Response.
  • Konnektivitätsanforderungen: On-Prem-, Partner-, Internet- und Service-Integrationen.
  • Betriebsmodell-Vorgaben: Rollen, Eskalationswege und Übergabeschnittstellen.
STACKIT LogoSTACKIT Logo
Platform Landing Zone STACKIT · Design And Mobilize › Landing Zones Open page ↗
  1. Governance- und Kontrollziele mit Enterprise-Stakeholdern abstimmen.
  2. Plattform-Basis für Identität, Netzwerk, Security und Kostensteuerung designen.
  3. Baseline-Automatisierung und Policy-Leitplanken als wiederverwendbare Module implementieren.
  4. Kontrollen mit Pilot-Workloads validieren und Lücken schließen.
  5. Betrieb mit Ownership-Modell, Runbook-Standards und Change-Prozess verstetigen.
STACKIT LogoSTACKIT Logo
Platform Landing Zone STACKIT · Design And Mobilize › Landing Zones Open page ↗
  • Erst standardisieren, dann Ausnahmen zulassen: Ausnahmen explizit, genehmigt und zeitlich befristet führen.
  • Kontrollen automatisieren: Policies und Baseline als Code etablieren, um Drift zu reduzieren.
  • Nachweise früh mitdenken: Compliance-Evidenz bereits im Plattformdesign berücksichtigen.
  • Auf Skalierung auslegen: Von Beginn an mehrere Teams und Applikationsarten einplanen.
OPS

R-Strategie mit dem Landing-Zone-Design verbinden

Leiten Sie aus der gewählten R-Strategie und Zielarchitektur jeder Anwendung die Landing-Zone-Fähigkeiten, Kontrollen, Connectivity und Service-Muster ab, die ihre Migration benötigt.

Design and mobilizeDesignOverview In 2 Trails

Die R-Strategie-Methodik ist das zentrale Modell in diesem Modul. Für jede Anwendung muss die gewählte Strategie mit Architektur-, Business-, Risiko- und Argumenten für den Betrieb belegt werden.

Seitlich wischen, um das ganze Diagramm zu sehen
R-Strategie-Migrationsmethode Entscheidungsfluss von Discovery bis Produktion mit den sieben R-Strategien: Relocate, Rehost, Replatform, Repurchase, Refactor, Retain und Retire. R-Strategie-MigrationsmethodeFrom discovery and path selection through the seven R-strategies to validation, transition, and production.DiscoveryDiscoveryAssess / prioritizeAssess / prioritizeDetermine migration pathDetermine migration pathValidationValidationTransitionTransitionProductionProductionRelocateRelocate(move VM)Define Landing ZoneDefine Landing ZoneUse migration toolsUse migration toolsAUTOMATEMANUALInstallInstallConfigConfigDeployDeployValidation & handoverRehostingRehosting(move application)Define Landing ZoneDefine Landing ZoneUse migration toolsUse migration toolsAUTOMATEMANUALInstallInstallConfigConfigDeployDeployReplatformingReplatforming(lift and reshape)Define Landing ZoneDefine Landing ZoneMap Target PlatformMap Target PlatformAdapt Platform StackAdapt Platform StackRepurchasingRepurchasing(replace, drop and shop)Purchase COTS/SaaS and licensingPurchase COTS/SaaS and licensingMigrate business processMigrate business processRefactoringRefactoring(re-architecting applications)Redesign application/ infrastructure architectureRedesign application/ infrastructure architectureApp code developmentApp code developmentFull ALM/SDLCFull ALM/SDLCIntegrationIntegrationRetain/moveRetain/movekeep for now or move laterRetire/decommissionRetire/decommissionLanding zone foundationLanding zone foundationShared platform base for all paths
  • Relocate: Sinnvoll, wenn eine schnelle Überführung von Virtualisierungs-Stacks möglich ist; je nach Wellenumfang tool-gestützt oder kontrolliert manuell ausführen.
  • Rehost: Sinnvoll bei geringer Veränderungstoleranz und engem Zeitrahmen, wenn Geschwindigkeit vor sofortiger Modernisierung steht.
  • Replatform: Sinnvoll, wenn begrenzte Anpassungen über die STACKIT Plattform klare Vorteile in Betrieb, Skalierung oder Kosten bringen.
  • Repurchase: Sinnvoll für passende Angebote im STACKIT Ökosystem, in dieser Phase gezielt für Workspace by STACKIT, ServiceNow, RISE with SAP on STACKIT und STACKIT Domain Solutions.
  • Refactor: Sinnvoll für strategische Anwendungen, wenn eine cloud-native Überarbeitung klaren Mehrwert in Agilität, Resilienz oder Kosten schafft.
  • Retain: Retain bei zeitlichen, technischen oder Governance-Hürden in der aktuellen Welle.
  • Retire: Retire bei fehlendem Geschäftswert im Verhältnis zum Betriebsaufwand.
AUTO

Application Landing Zones

Eine Application Landing Zone ist ein workload-spezifisches Umsetzungsprofil, das aus der Platform-Landing-Zone-Basis abgeleitet wird.

Sie übersetzt unternehmensweite Leitplanken in konkrete Muster für Applikationstypen, zum Beispiel VM-basierte Rehost-Szenarien, Container-Workloads oder datenintensive Plattformen.

Application Landing Zones werden nicht isoliert entworfen. Sie benötigen validierte Discovery-Eingaben zu Abhängigkeiten, Datenklassifizierung, Laufzeitverhalten und betrieblichen Randbedingungen.

Typische Discovery-getriebene Eingaben:

  • Abhängigkeitsprofil: Ein- und ausgehende Kommunikationspfade sowie Vertrauensgrenzen.
  • Laufzeitprofil: Ressourcenverhalten, Verfügbarkeitsanforderungen und Skalierungsmuster.
  • Daten- und Compliance-Profil: Klassifizierung, Aufbewahrung und Kontrollpflichten.
  • Migrationsstrategie-Fit: Rehost-, Replatform- oder Refactor-Randbedingungen je Workload.
OPS

Discovery mit dem Landing-Zone-Design verbinden

Die folgende Darstellung zeigt, wie Discovery technische und menschliche Eingaben in entscheidungsreife Ergebnisse für die nachgelagerten Module überführt.

Seitlich wischen, um das ganze Diagramm zu sehen
Discovery von Quelle zur Entscheidung Discovery trennt technische und menschliche Eingaben, führt technische und menschlich angereicherte Analysen aus und übergibt beide Ergebnisströme an nachgelagerte Module. Discovery-EingabenTechnisches und automatisiertes DiscoveryInfrastruktur-InventarCMDB, VM, Datenbanken, Middleware, StorageLaufzeit- und NutzungsdatenCPU, RAM, I/O, Netzwerk und SaisonalitätIntegrations- und Fluss-SignaleNetzwerkpfade, APIs, Identität, DatenflüsseAssessment-getriebene menschliche EingabenSecurity- und Compliance-KontextDatenklassen, Kontrollen, Audit-AnforderungenOwner- und Business-InputKritikalität, Release-Fenster, Lifecycle-PläneDiscovery-Analyse-ToolingTechnikbasierte AnalysenNormalisieren und korrelierenDatensätze und technische Identitäten zusammenführenAbhängigkeiten abbildenKommunikation und Kopplung ableitenNutzungs- und Sizing-AnalyseBelastbare Lastkorridore ableitenVorläufige SegmentierungNach Stack und Umgebung gruppierenHuman-driven Analysen (Application-Owner-Input)Kritikalität und Risiko kalibrierenBusiness-Impact und Restriktionen validierenWellenfähigkeit und ReihenfolgeAbhängigkeiten mit Release-Fenstern abstimmenAnnahmen- und Gap-RegisterOffene Punkte und Reifegrad dokumentierenÜbergabe-ErgebnisseTool-basierte ErgebnisseDesignOptionen für Zielarchitektur und belastbare Sizing-DatenLanding ZonePlattform-Guidelines und Anforderungen an Account-StrukturenMigrationsplanWellen-Backlog, Reihenfolge und Cutover-FensterAssessment-validierte ErgebnisseSecurity und ComplianceControl-Bedarfe, Datenklassen und Remediation-PunkteOperating ModelRollenbild, Ownership-Grenzen und ProzessauswirkungenBusiness CaseValue-/Risikoprofil und Modernisierungsprioritäten
AUTO

Application Landing Zones: Muster und Bereitstellung

Rehost-fähiges Muster

Zielprofil mit minimalen Änderungen für VM-basierte Workloads unter zentralen Kontrollen.

Container-Plattform-Muster

Segmentiertes, policy-gesteuertes Setup für Kubernetes-basierte Workload-Gruppen.

Daten-Workload-Muster

Landing-Zone-Profil für Datendienste, Integrationspfade und strengere Kontrollen.

Shared-Service-Muster

Isoliertes Setup für Basisdienste, die von mehreren Produktteams genutzt werden.

  1. Workload-Archetypen aus Discovery-Ergebnissen und Zielstrategie klassifizieren.
  2. Plattform-Basiskontrollen je Archetyp abbilden und kontrollierte Abweichungen identifizieren.
  3. Wiederverwendbare IaC-Templates und Policy-Sets pro Landing-Zone-Profil erstellen.
  4. Mit Pilot-Workloads und produktionsnahen Cutover-Szenarien validieren.
  5. Templates, Runbooks und Onboarding-Leitfäden für Migrationswellen veröffentlichen.
  • Templates vor Einzellösungen: Wiederverwendbare Muster beschleunigen Migrationswellen.
  • Abweichungen explizit dokumentieren: Risiko, Owner und Ablaufdatum transparent halten.
  • Mit der Migration Factory verzahnen: Landing-Zone-Muster in Wellen-Runbooks integrieren.
  • Kontinuierlich verbessern: Erkenntnisse aus Migrate und Run in den Template-Backlog zurückführen.
AUTO

Application Landing Zones

Eine Application Landing Zone ist ein workload-spezifisches Umsetzungsprofil, das aus der Platform-Landing-Zone-Basis abgeleitet wird.

Sie übersetzt unternehmensweite Leitplanken in konkrete Muster für Applikationstypen, zum Beispiel VM-basierte Rehost-Szenarien, Container-Workloads oder datenintensive Plattformen.

Application Landing Zones werden nicht isoliert entworfen. Sie benötigen validierte Discovery-Eingaben zu Abhängigkeiten, Datenklassifizierung, Laufzeitverhalten und betrieblichen Randbedingungen.

Typische Discovery-getriebene Eingaben:

  • Abhängigkeitsprofil: Ein- und ausgehende Kommunikationspfade sowie Vertrauensgrenzen.
  • Laufzeitprofil: Ressourcenverhalten, Verfügbarkeitsanforderungen und Skalierungsmuster.
  • Daten- und Compliance-Profil: Klassifizierung, Aufbewahrung und Kontrollpflichten.
  • Migrationsstrategie-Fit: Rehost-, Replatform- oder Refactor-Randbedingungen je Workload.

Rehost-fähiges Muster

Zielprofil mit minimalen Änderungen für VM-basierte Workloads unter zentralen Kontrollen.

Container-Plattform-Muster

Segmentiertes, policy-gesteuertes Setup für Kubernetes-basierte Workload-Gruppen.

Daten-Workload-Muster

Landing-Zone-Profil für Datendienste, Integrationspfade und strengere Kontrollen.

Shared-Service-Muster

Isoliertes Setup für Basisdienste, die von mehreren Produktteams genutzt werden.

Die folgende Darstellung zeigt, wie Discovery technische und menschliche Eingaben in entscheidungsreife Ergebnisse für die nachgelagerten Module überführt.

Seitlich wischen, um das ganze Diagramm zu sehen
Discovery von Quelle zur Entscheidung Discovery trennt technische und menschliche Eingaben, führt technische und menschlich angereicherte Analysen aus und übergibt beide Ergebnisströme an nachgelagerte Module. Discovery-EingabenTechnisches und automatisiertes DiscoveryInfrastruktur-InventarCMDB, VM, Datenbanken, Middleware, StorageLaufzeit- und NutzungsdatenCPU, RAM, I/O, Netzwerk und SaisonalitätIntegrations- und Fluss-SignaleNetzwerkpfade, APIs, Identität, DatenflüsseAssessment-getriebene menschliche EingabenSecurity- und Compliance-KontextDatenklassen, Kontrollen, Audit-AnforderungenOwner- und Business-InputKritikalität, Release-Fenster, Lifecycle-PläneDiscovery-Analyse-ToolingTechnikbasierte AnalysenNormalisieren und korrelierenDatensätze und technische Identitäten zusammenführenAbhängigkeiten abbildenKommunikation und Kopplung ableitenNutzungs- und Sizing-AnalyseBelastbare Lastkorridore ableitenVorläufige SegmentierungNach Stack und Umgebung gruppierenHuman-driven Analysen (Application-Owner-Input)Kritikalität und Risiko kalibrierenBusiness-Impact und Restriktionen validierenWellenfähigkeit und ReihenfolgeAbhängigkeiten mit Release-Fenstern abstimmenAnnahmen- und Gap-RegisterOffene Punkte und Reifegrad dokumentierenÜbergabe-ErgebnisseTool-basierte ErgebnisseDesignOptionen für Zielarchitektur und belastbare Sizing-DatenLanding ZonePlattform-Guidelines und Anforderungen an Account-StrukturenMigrationsplanWellen-Backlog, Reihenfolge und Cutover-FensterAssessment-validierte ErgebnisseSecurity und ComplianceControl-Bedarfe, Datenklassen und Remediation-PunkteOperating ModelRollenbild, Ownership-Grenzen und ProzessauswirkungenBusiness CaseValue-/Risikoprofil und Modernisierungsprioritäten
  1. Workload-Archetypen aus Discovery-Ergebnissen und Zielstrategie klassifizieren.
  2. Plattform-Basiskontrollen je Archetyp abbilden und kontrollierte Abweichungen identifizieren.
  3. Wiederverwendbare IaC-Templates und Policy-Sets pro Landing-Zone-Profil erstellen.
  4. Mit Pilot-Workloads und produktionsnahen Cutover-Szenarien validieren.
  5. Templates, Runbooks und Onboarding-Leitfäden für Migrationswellen veröffentlichen.
  • Templates vor Einzellösungen: Wiederverwendbare Muster beschleunigen Migrationswellen.
  • Abweichungen explizit dokumentieren: Risiko, Owner und Ablaufdatum transparent halten.
  • Mit der Migration Factory verzahnen: Landing-Zone-Muster in Wellen-Runbooks integrieren.
  • Kontinuierlich verbessern: Erkenntnisse aus Migrate und Run in den Template-Backlog zurückführen.
LIVE

Landing Zone Accelerator

Dieses Asset liefert eine wiederverwendbare Grundlage für die Umsetzung einer STACKIT Platform Landing Zone. Es ist für Enterprise-Umgebungen ausgelegt, die eine strukturierte Basis für Governance, Security, Netzwerk, Kostensteuerung und Automatisierung benötigen.

Repository:

Das Repository bietet wiederverwendbare Module, Referenzkonfigurationen und unabhängig nutzbare Bereitstellungswege für Plattform und Applikationen.

  • Das Root-Modul in src/main.tf orchestriert die Plattformbausteine und unterstützt kombinierte Plattform-/Applikationskonfigurationen.
  • Das separate Root-Modul in src/application/ stellt eine Applikationsinstanz aus geprüften Plattformreferenzen bereit, mit eigenem Backend und State.
  • Die Konfiguration erfolgt über flavor-spezifische Variablendateien in src/config/.
  • Der Accelerator kann direkt mit OpenTofu oder Terraform genutzt werden.
  • Das erste Deployment nutzt einen temporären Bootstrap-Service-Account und wechselt danach auf Managed Backend und Managed Credentials.
PLAN

Die Accelerator-Referenztopologie wählen

Das Repository enthält acht Referenzkonfigurationen in src/config/. Wählen Sie die einfachste Topologie, die die erforderlichen Netzwerk-, Sicherheits-, Organisations-, Mandanten- und Regionsgrenzen erfüllt.

Entscheidung: Halten Sie Referenzkonfiguration, Domänengrenzen, Adressplan und zuständige Teams fest. Übertragen Sie diese Entscheidungen in den Configurator, bevor Sie optionale Plattformservices ergänzen.
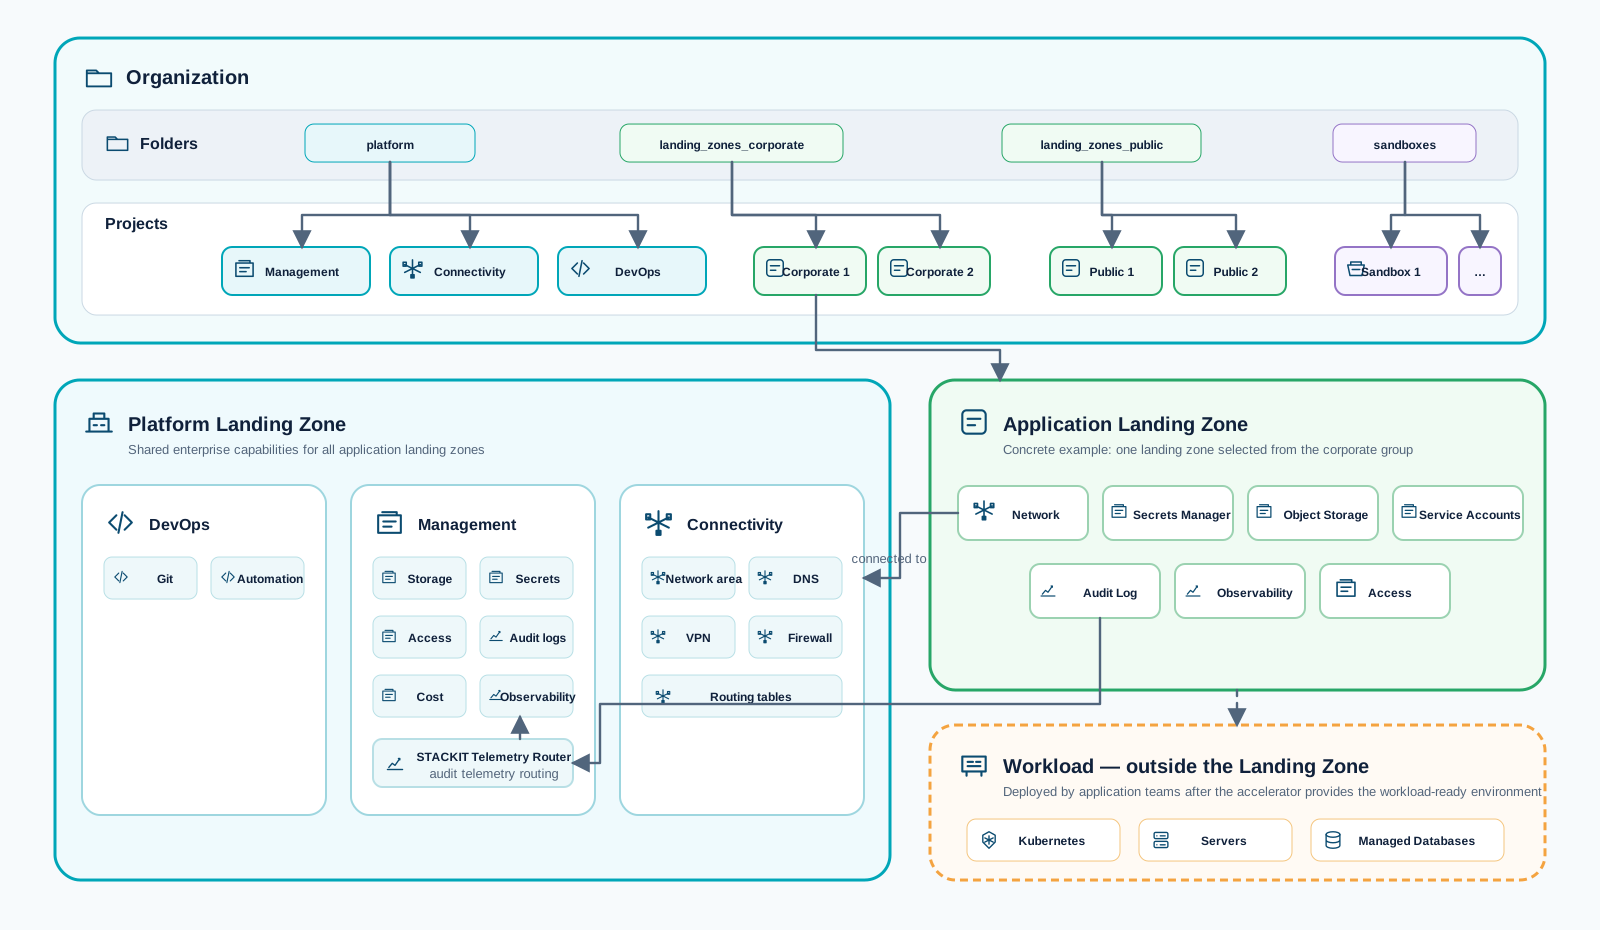
LIVE

Die Accelerator-Architektur lesen

Architektur des STACKIT Landing Zone Accelerators von Bootstrap über Plattformfähigkeiten zu Application Landing Zones
LIVE

Landing Zone Accelerator vorstellen

Dieses Asset liefert eine wiederverwendbare Grundlage für die Umsetzung einer STACKIT Platform Landing Zone. Es ist für Enterprise-Umgebungen ausgelegt, die eine strukturierte Basis für Governance, Security, Netzwerk, Kostensteuerung und Automatisierung benötigen.

Repository:

Das Repository bietet wiederverwendbare Module, Referenzkonfigurationen und unabhängig nutzbare Bereitstellungswege für Plattform und Applikationen.

  • Das Root-Modul in src/main.tf orchestriert die Plattformbausteine und unterstützt kombinierte Plattform-/Applikationskonfigurationen.
  • Das separate Root-Modul in src/application/ stellt eine Applikationsinstanz aus geprüften Plattformreferenzen bereit, mit eigenem Backend und State.
  • Die Konfiguration erfolgt über flavor-spezifische Variablendateien in src/config/.
  • Der Accelerator kann direkt mit OpenTofu oder Terraform genutzt werden.
  • Das erste Deployment nutzt einen temporären Bootstrap-Service-Account und wechselt danach auf Managed Backend und Managed Credentials.

Das Repository enthält acht Referenzkonfigurationen in src/config/. Wählen Sie die einfachste Topologie, die die erforderlichen Netzwerk-, Sicherheits-, Organisations-, Mandanten- und Regionsgrenzen erfüllt.

Entscheidung: Halten Sie Referenzkonfiguration, Domänengrenzen, Adressplan und zuständige Teams fest. Übertragen Sie diese Entscheidungen in den Configurator, bevor Sie optionale Plattformservices ergänzen.

Architektur des STACKIT Landing Zone Accelerators von Bootstrap über Plattformfähigkeiten zu Application Landing Zones
SAFE

Platform-Basis etablieren

Zweck:

  • Erstellt die RM-Folder-Struktur (platform, landing_zones_corporate, landing_zones_public, sandboxes).
  • Vergibt Folder-Owner- und Auditor-Rollen.
  • Vergibt Organization-Owner- und Auditor-Rollen.
  • Erstellt Custom Roles auf Organisationsebene.

Landing-Zone-Zuordnung:

  • Platform Landing Zone: zentrale Governance-Basis.

Zweck:

  • Erstellt ein zentrales Management-Projekt.
  • Provisioniert Secrets Manager und einen Default-Zugangsuser.
  • Provisioniert Object-Storage-Buckets (inklusive tfstate-Bucket).
  • Erstellt Object-Storage-Credentials und speichert sie im Secrets Manager.
  • Erstellt Automation-Service-Account plus rotierende Keys und speichert den Key im Secrets Manager.
  • Stellt optional Observability bereit und speichert die zugehörigen Zugangsdaten im Secrets Manager.
  • Konfiguriert optional Federated Identity Provider für den Automation-Service-Account.

Landing-Zone-Zuordnung:

  • Platform Landing Zone: gemeinsamer Operations- und Automatisierungs-Kontrollpfad.

Zweck:

  • Erstellt ein dediziertes Connectivity-Projekt.
  • Erstellt Network Area und regionale Network-Area-Konfiguration.
  • Erstellt DNS-Zonen für gemeinsame Namensräume.
  • Stellt optional Firewall-Image, Volume, Server, Interfaces und Public IP bereit.
  • Liefert die Firewall-Next-Hop-IP für Routen in Corporate Landing Zones.

Landing-Zone-Zuordnung:

  • Platform Landing Zone: gemeinsame Netzwerk- und Routing-Basis.

Zweck:

  • Erstellt ein dediziertes DevOps-Projekt.
  • Erstellt optional eine zentrale STACKIT Git-Instanz mit ACL-Ranges.

Landing-Zone-Zuordnung:

  • Platform Landing Zone in der Architektur dieses Accelerators.
  • Begründung: Das Modul liefert zentrale Delivery-Tooling-Grundlagen und Source-Control-Kapazität für mehrere Landing Zones.
PLAN

Mit einer Standalone-Basis starten

Wählen Sie die kleinste Accelerator-Topologie, wenn Workloads unabhängige Netzwerke und direkten Internetzugang ohne gemeinsame private Connectivity benötigen.
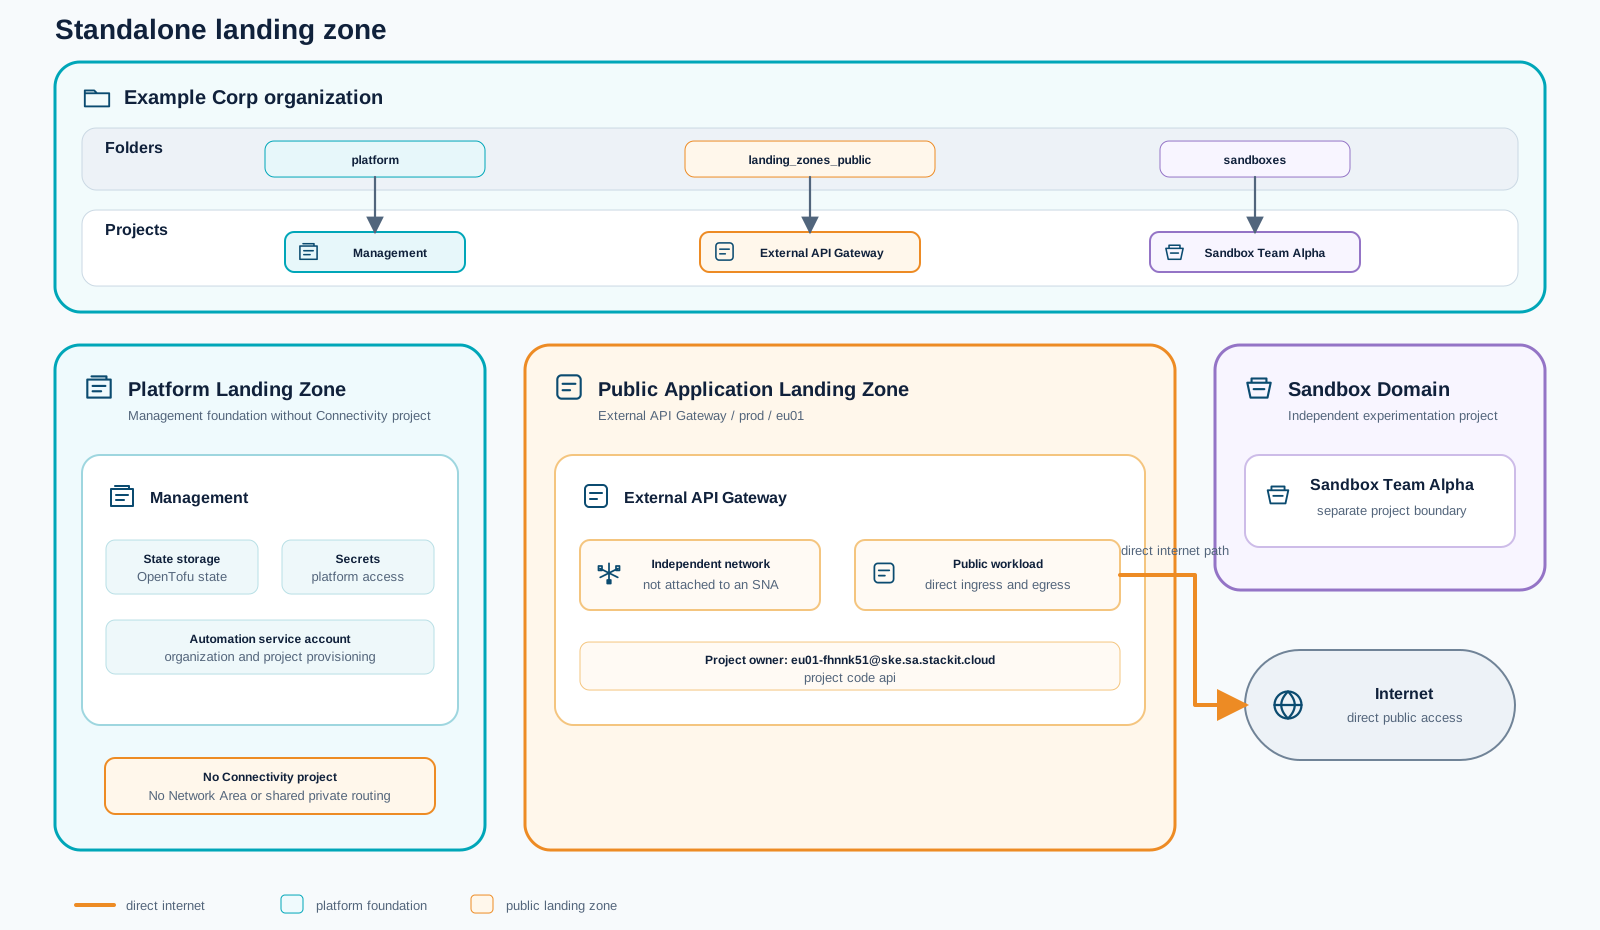
Standalone-Topologie mit Management-Basis, Sandbox und öffentlicher Application Landing Zone
OPS

Corporate Workloads privat verbinden

Führen Sie ein zentrales Connectivity-Projekt, eine gemeinsame Network Area und DNS ein, wenn Corporate Workloads private Ost-West-Kommunikation benötigen.
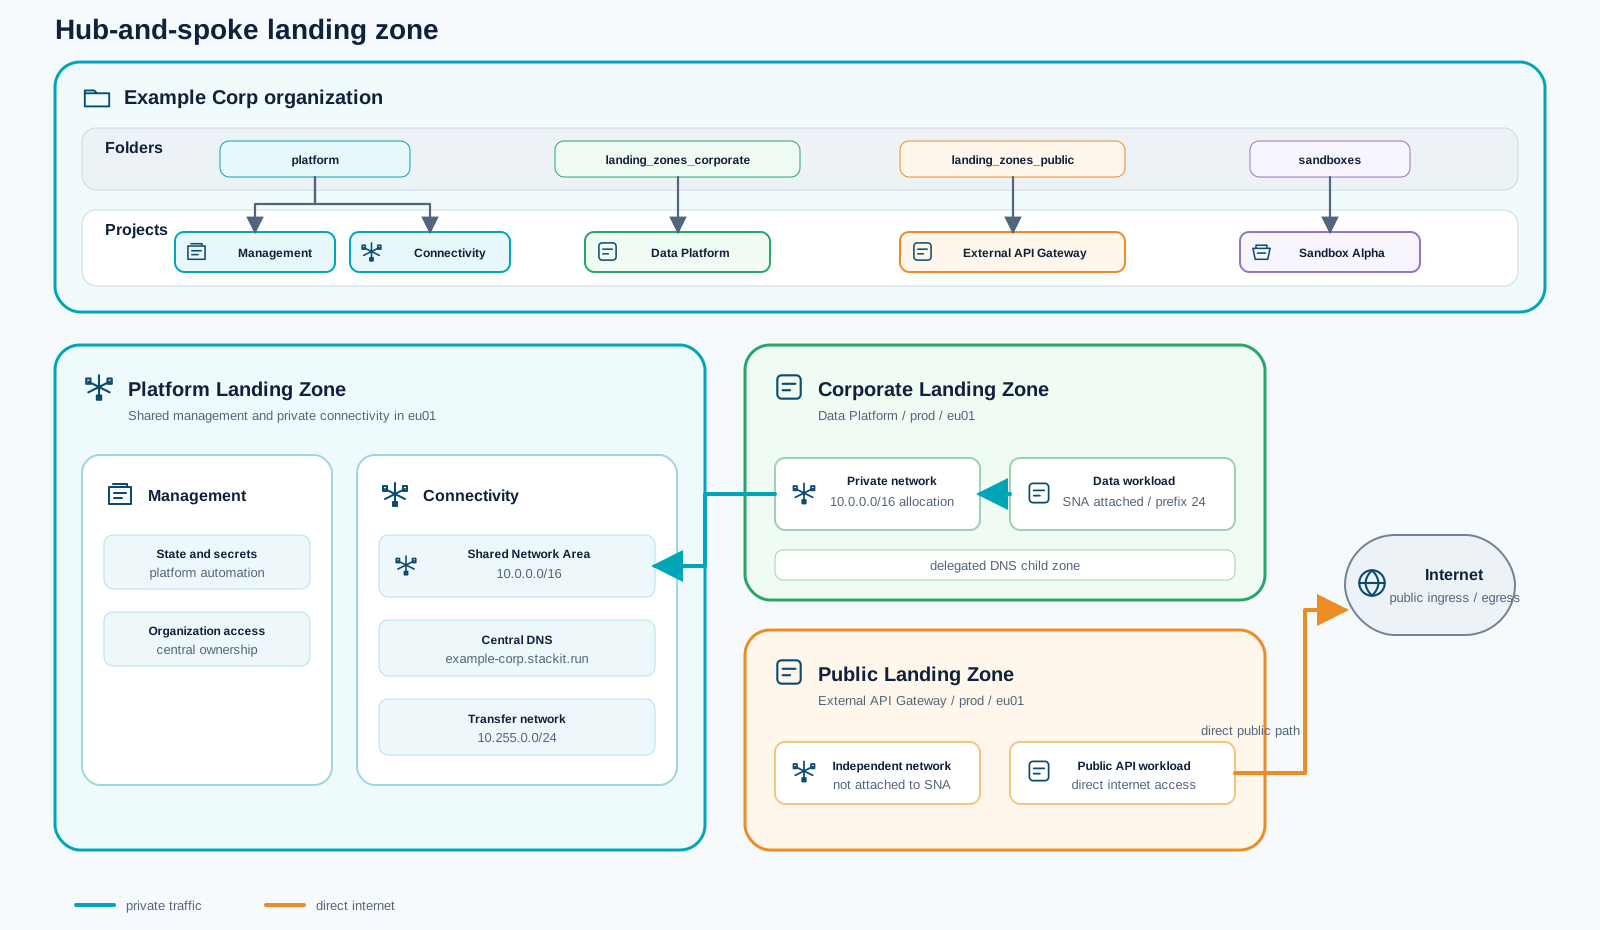
Hub-and-Spoke-Topologie mit gemeinsamer Network Area und separater öffentlicher Landing Zone
SAFE

Egress-Inspektion zentralisieren

Erweitern Sie Hub-and-Spoke um eine OPNsense-Firewall, wenn Corporate Traffic einen einheitlichen Inspektionspunkt und kontrollierten Egress-Pfad benötigt.
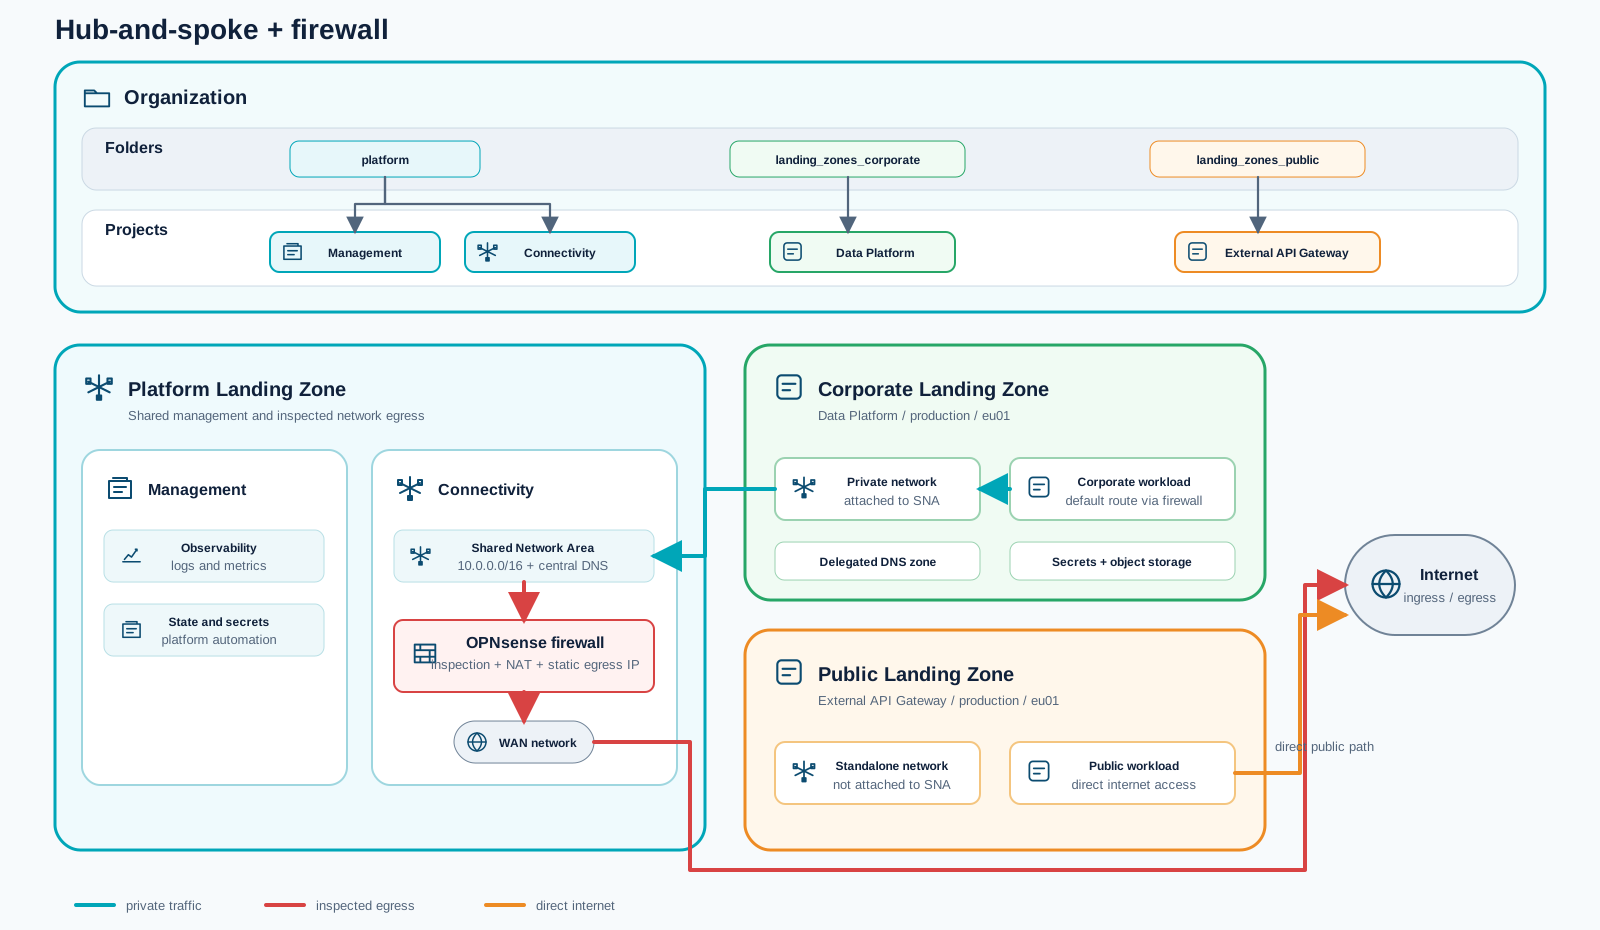
Hub-and-Spoke-Topologie mit zentraler Inspektion durch eine OPNsense-Firewall
BASE

Business-Unit-Domänen trennen

Geben Sie Finance und Research unabhängige Ownership, Adresspläne, Connectivity-Projekte und private Workload-Domänen innerhalb einer Organisation.
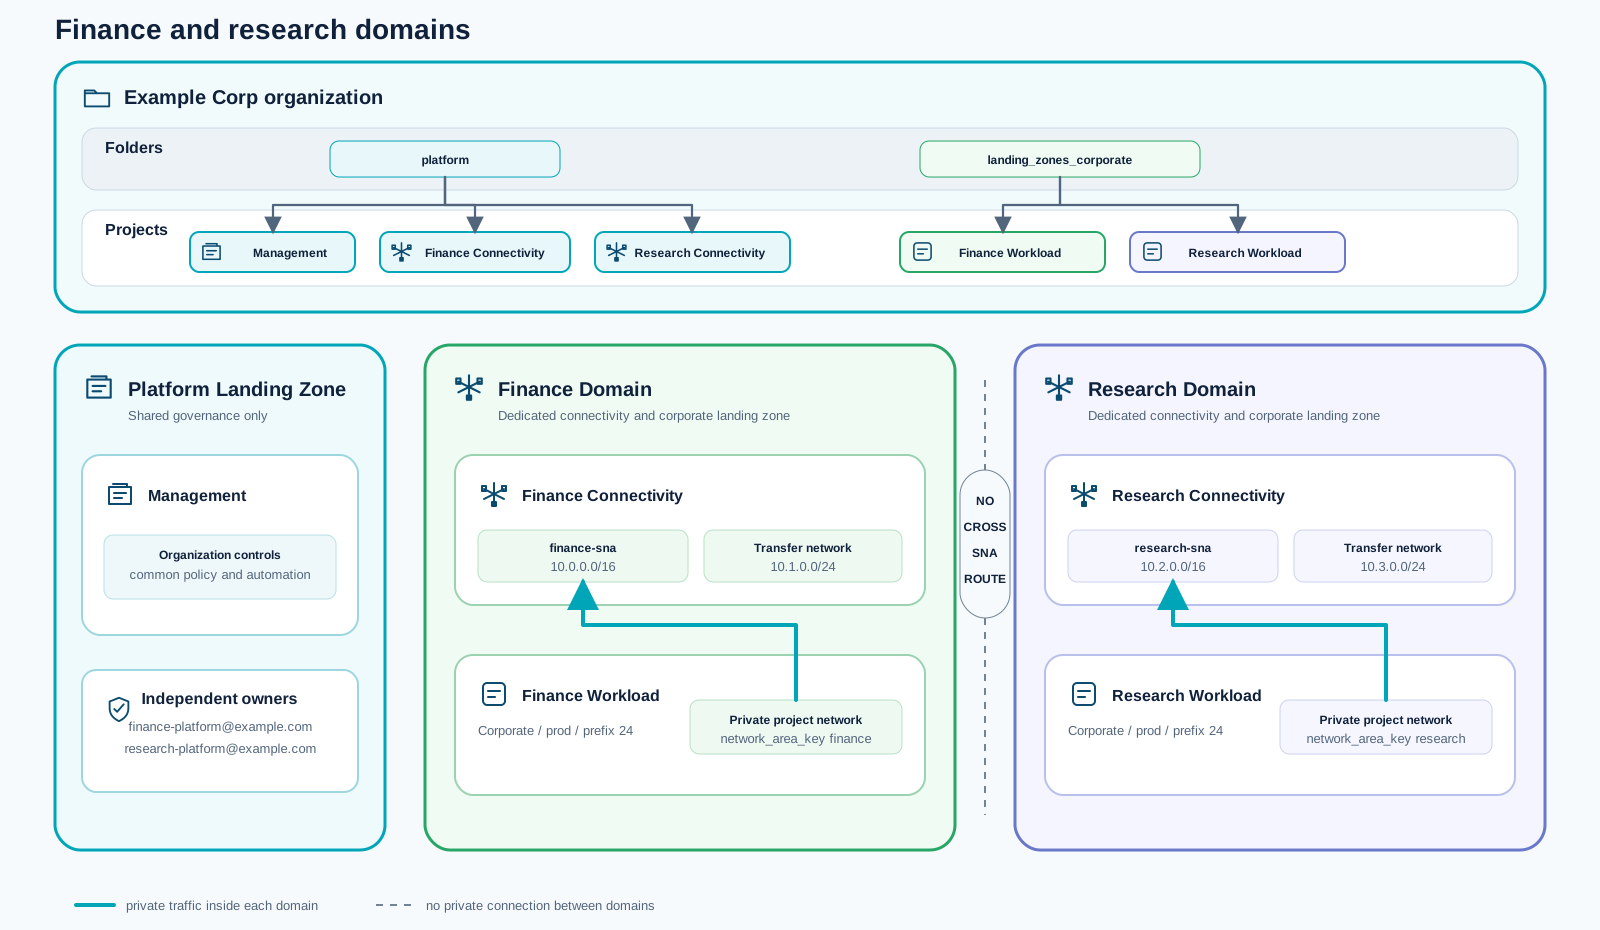
Finance- und Research-Topologie mit unabhängigen privaten Connectivity-Domänen
STEP

Regulierte und gemeinsame Workloads trennen

Erstellen Sie getrennte Network Areas und DNS-Zonen, wenn zwischen regulierten und gemeinsamen Workloads kein implizites privates Routing bestehen darf.
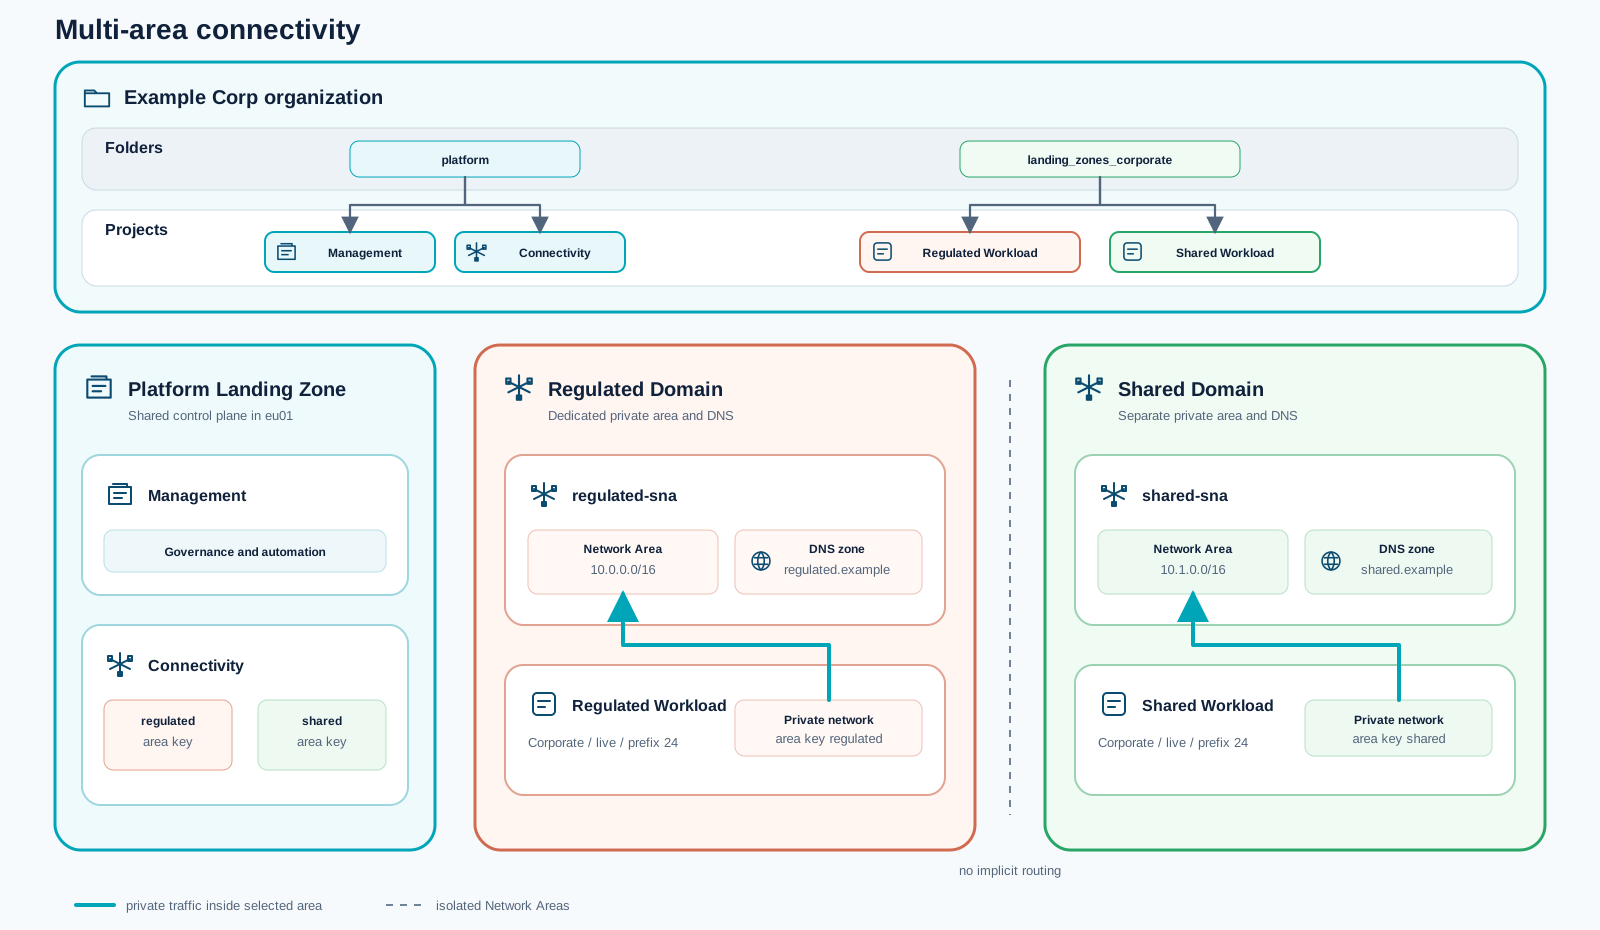
Multi-Area-Topologie zur Trennung regulierter und gemeinsamer Workloads
AUTO

Unabhängige regionale Hubs aufbauen

Stellen Sie isolierte Basen in eu01 und eu02 bereit, wenn regionale Workloads eigene Connectivity-, Landing-Zone- und Plattformgrenzen benötigen.
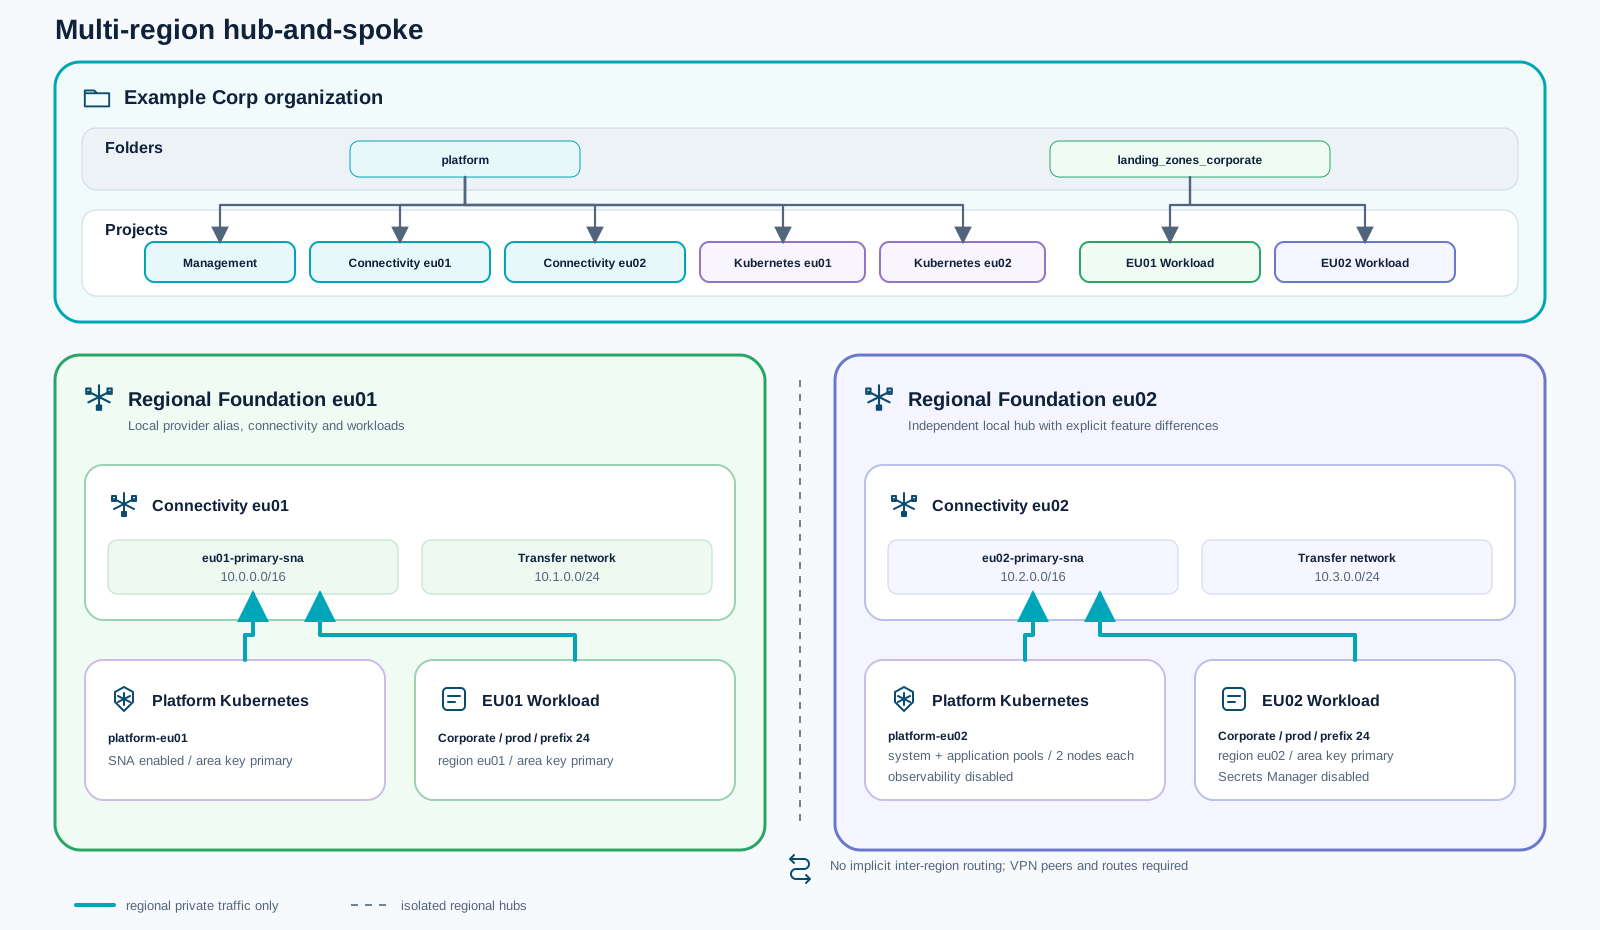
Multi-Region-Topologie mit unabhängigen Hubs in eu01 und eu02
SAFE

Produktion von Nicht-Produktion isolieren

Nutzen Sie getrennte Network Areas und Firewalls, wenn Produktion eine stärkere Grenze benötigt, während Development und Test eine Nicht-Produktions-Domäne teilen können.
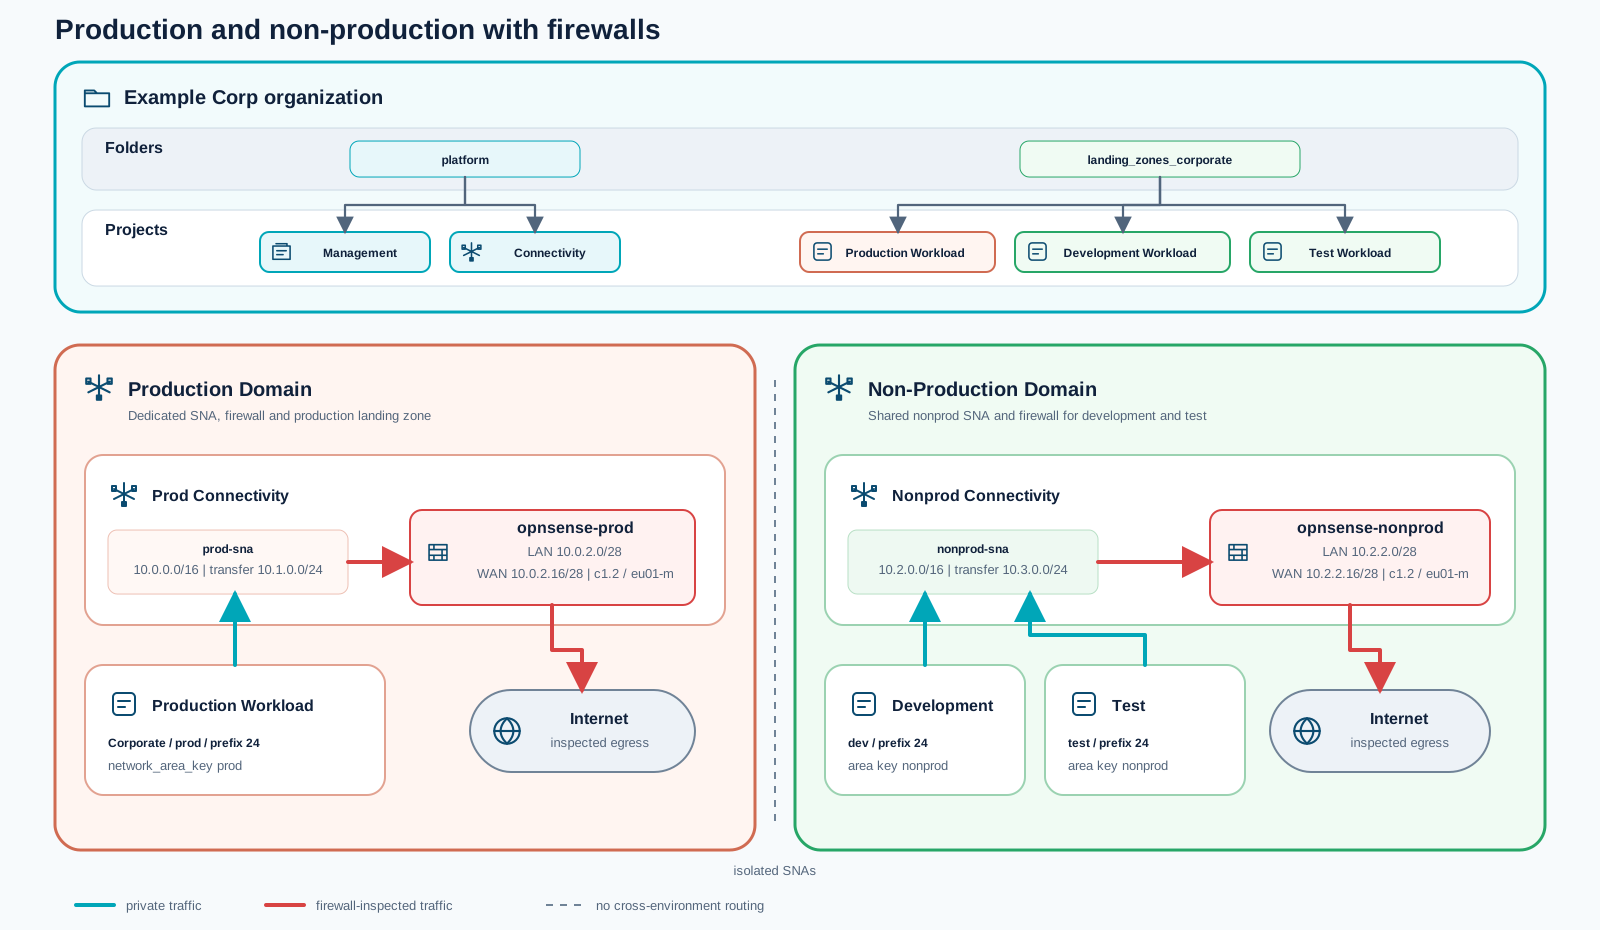
Produktions- und Nicht-Produktions-Topologie mit getrennten Network Areas und Firewalls
LIFT

Mandanten-Connectivity isolieren

Erstellen Sie unabhängige Ownership, Adresspläne und private Connectivity-Domänen, wenn mehrere Mandanten eine Organisation teilen, aber nicht untereinander routen dürfen.
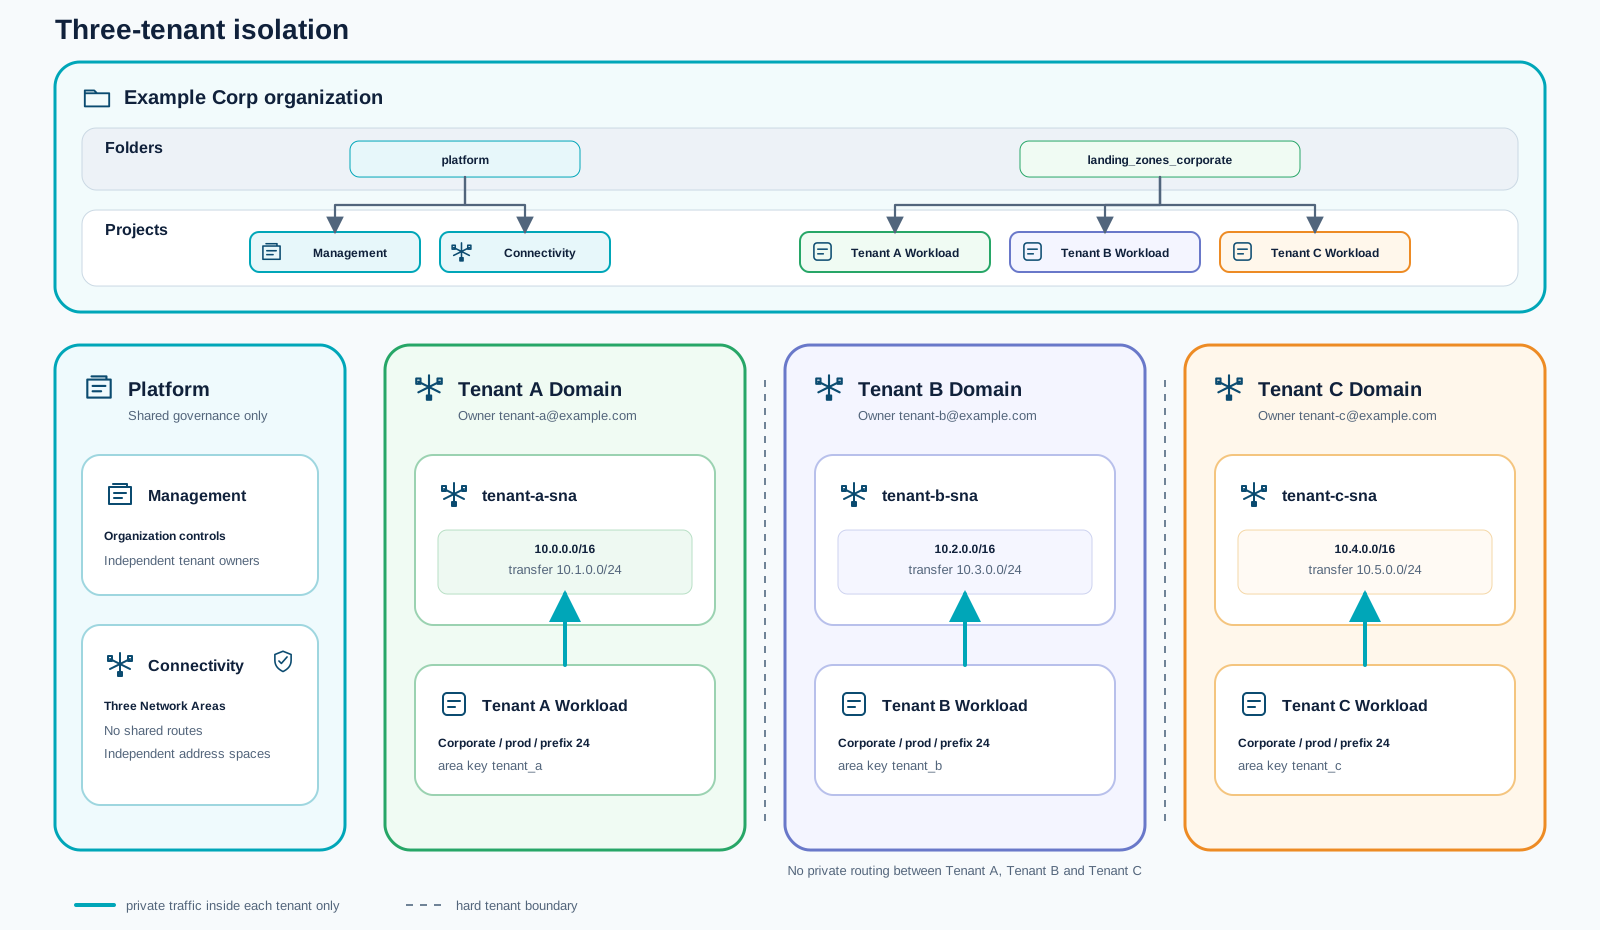
Mandantenisolation mit drei unabhängigen privaten Mandantendomänen
AUTO

Application-Umgebungen bereitstellen

Zweck:

  • Erstellt anwendungsnahe Landing-Zone-Projekte iterativ über for_each.
  • Unterstützt corporate Landing Zones (an Network Area angebunden) und public Landing Zones.
  • Erstellt geroutete Netzwerke und optional Default-Route über Firewall-Next-Hop.
  • Erstellt optional projektbezogene Child-DNS-Zonen.
  • Erstellt projektbezogene Custom Roles und Role Assignments.
  • Erstellt Secrets Manager, Object-Storage-Buckets und Automation-Service-Account-Key-Material pro Landing Zone.

Landing-Zone-Zuordnung:

  • Application Landing Zone: zentrales ALZ-Umsetzungsmodul.

Zweck:

  • Erstellt schlanke Sandbox-Projekte im dedizierten sandboxes-Folder.
  • Vergibt Project-Owner.

Landing-Zone-Zuordnung:

  • Application Landing Zone (unterstützend): nicht-produktive Testumgebung nahe ALZ-Nutzungsmustern.

Platform vs Application Landing Zone Umfang in diesem Repository

Abschnitt betitelt „Platform vs Application Landing Zone Umfang in diesem Repository“
  • Platform Landing Zone Fokus (derzeit der größere Umfang):
    • governance
    • management
    • connectivity
    • devops
  • Application Landing Zone Umfang (derzeit fokussierter):
    • landing-zone (ALZ-Kernprovisionierung)
    • sandboxes (unterstützende ALZ-nahe Umgebungen)

Damit liefert das Repository aktuell primär eine starke Plattform-Basis, während ALZ-Funktionalität bewusst auf Landing-Zone-Instanziierung und Sandbox-Enabling fokussiert ist.

  • Plattform-Basis früh starten (Governance, Management, Connectivity, optional DevOps).
  • Corporate- vs Public-ALZ-Muster anhand von Connectivity- und Compliance-Anforderungen definieren.
  • Application Landing Zones über die landing_zones-Map in Variablendateien bereitstellen.
  • Sandboxes für Team-Onboarding und kontrollierte frühe Experimente nutzen.
  • Nach erstem Apply State in das Managed Backend migrieren und von Bootstrap-Credentials auf Managed Automation-Credentials wechseln.
  • Wiederverwendbare Basismodule: Bausteine für Account-/Projektstruktur, IAM, Netzwerk und Kontrollen.
  • Policy-orientiertes Setup: Leitplanken und Konventionen für sichere und steuerbare Cloud-Nutzung.
  • IaC-First-Ansatz: OpenTofu/Terraform als Modell für wiederholbare Bereitstellung.
  • Erweiterbar für Enterprise-Bedarf: Bewusst als Basis für kundenspezifische Anpassungen ausgelegt.
  • Früher Plattform-Stream: Aufbau parallel zum Discovery starten.
  • Kontrollbasis vor produktiver Migration: Pflichtkontrollen vor dem ersten produktiven Move etablieren.
  • Template-Quelle für Application Landing Zones: Basismodule für Workload-Archetypen wiederverwenden und verfeinern.
  • Organisations- und Ownership-Modell für Projekte und Umgebungen.
  • Security- und Compliance-Vorgaben (Identität, Logging, Nachweise, Segmentierung).
  • Konnektivitäts- und Integrationsanforderungen.
  • Betriebsmodell-Abstimmung zwischen Plattform-, Security- und Applikationsteams.
PLAN

Den Arbeitsweg für Landing Zones wählen

Landing Zone Configurator zur Demo öffnen

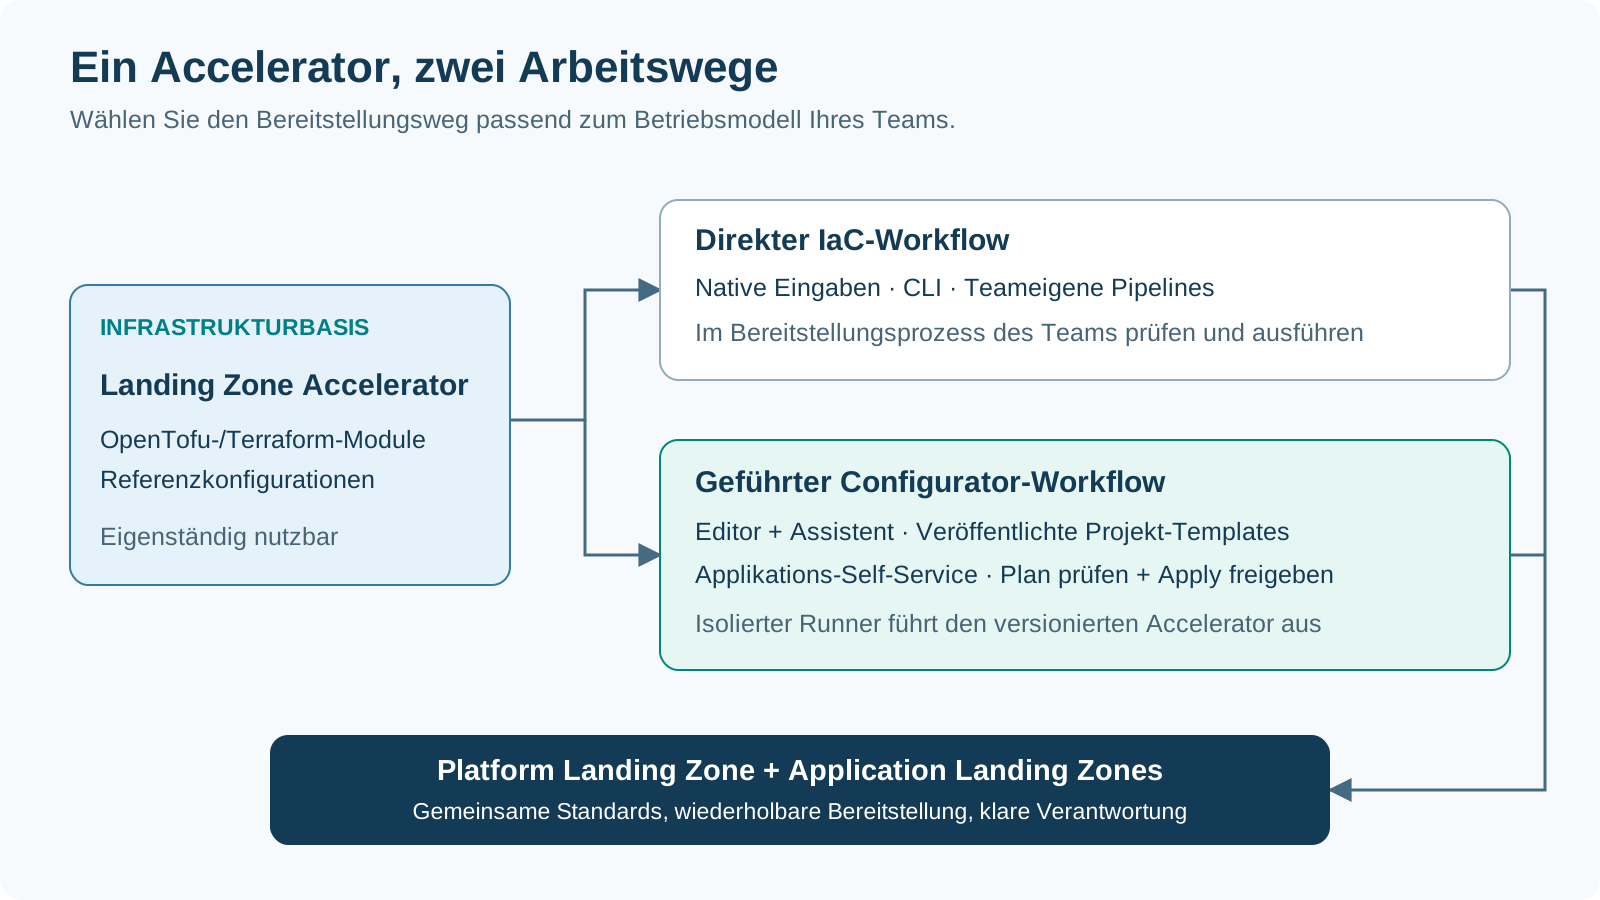
Der Accelerator liefert wiederverwendbaren Infrastrukturcode; Teams nutzen ihn direkt über CLI und Pipelines oder über Editor, Templates und autorisierten Runner des Configurators

Der Landing Zone Accelerator liefert OpenTofu-/Terraform-Module und Referenzkonfigurationen. Er bildet die Infrastrukturgrundlage für Governance, Identität, Netzwerk, gemeinsame Services und Applikationsprojekte.

Der Landing Zone Configurator ergänzt die Arbeitsabläufe rund um diese Grundlage: einen visuellen Editor, einen Assistenten, versionierte Projekt-Templates und kontrollierte Infrastrukturausführung. Sowohl die direkte IaC-Nutzung als auch der geführte Configurator-Workflow bauen auf dem Accelerator auf. Teams wählen den Weg, der zu ihrem Betriebsmodell passt.

Landing Zone Accelerator erkunden
STEP

Plattformstandards mit Self-Service verbinden

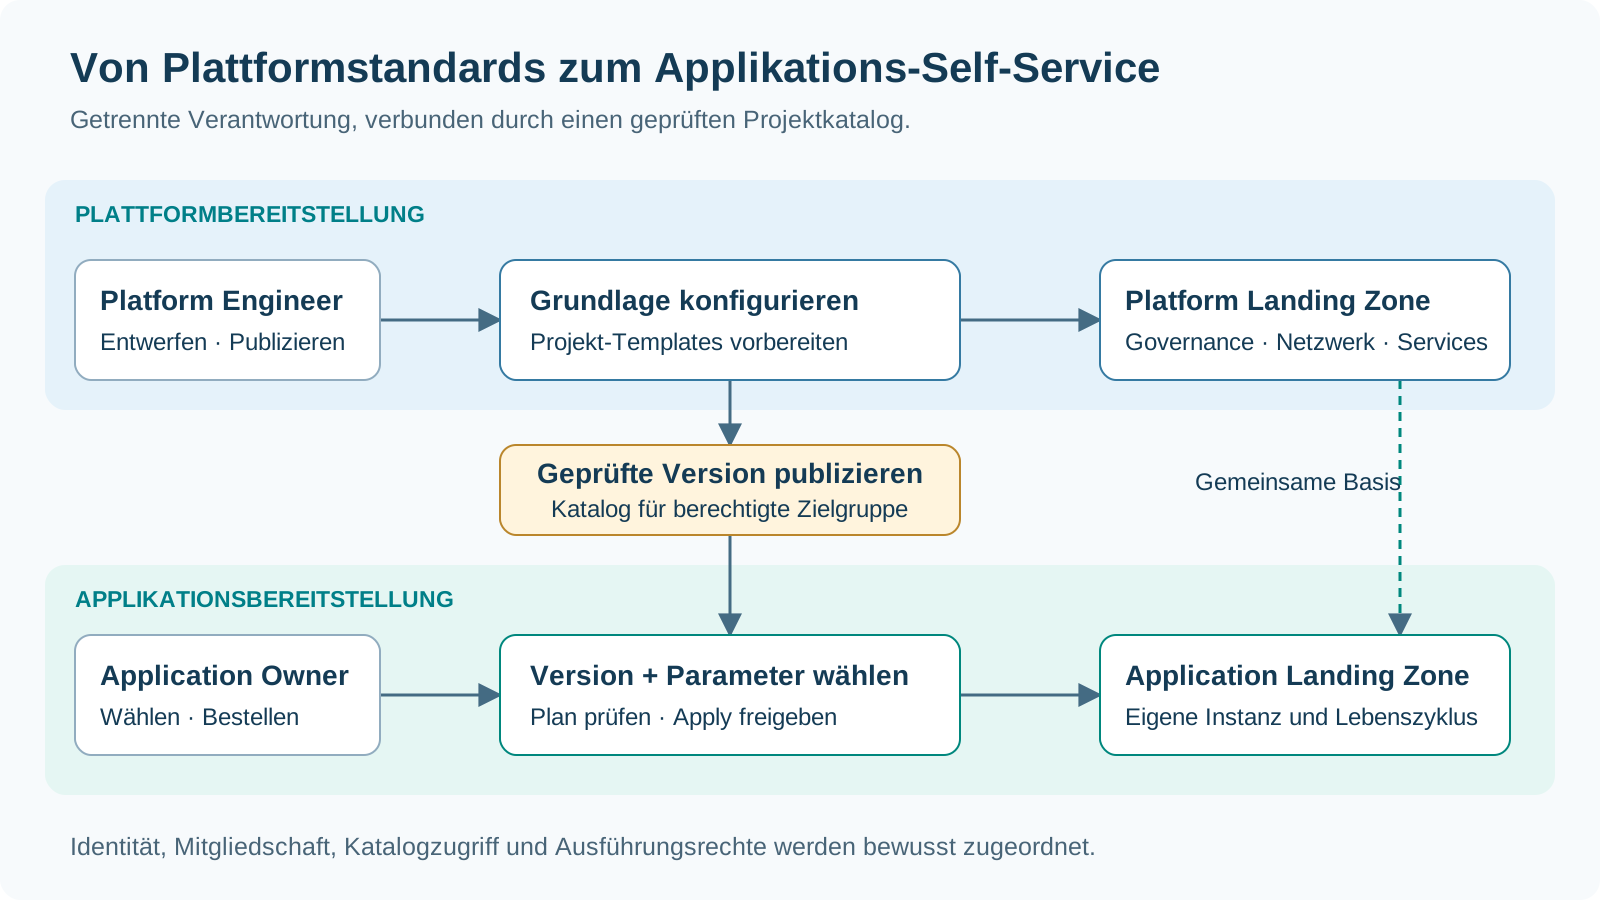
Platform Engineers konfigurieren die Plattform und veröffentlichen geprüfte Template-Versionen; Application Owner wählen diese aus und erstellen separate Applikationsinstanzen

Wählen Sie Organisation und Arbeitsumgebung passend zur Aufgabe. Die STACKIT Anmeldung bestätigt die Identität; Mitgliedschaft im Arbeitsbereich, Katalogzugriff und technische Ausführungsrechte bestimmen die Handlungsmöglichkeiten. Ordnen Sie Mitgliederverwaltung und Delegation technischer Zugangsdaten den verantwortlichen Personen zu.

PLAN

Regeln und Ausnahmen

Audit Logging ist das durchgängige Beispiel: Gesteuerte Applikationsprojekte folgen der zentralen Regel; die Sandbox-Ausnahme gibt der Platform Owner ausdrücklich frei.
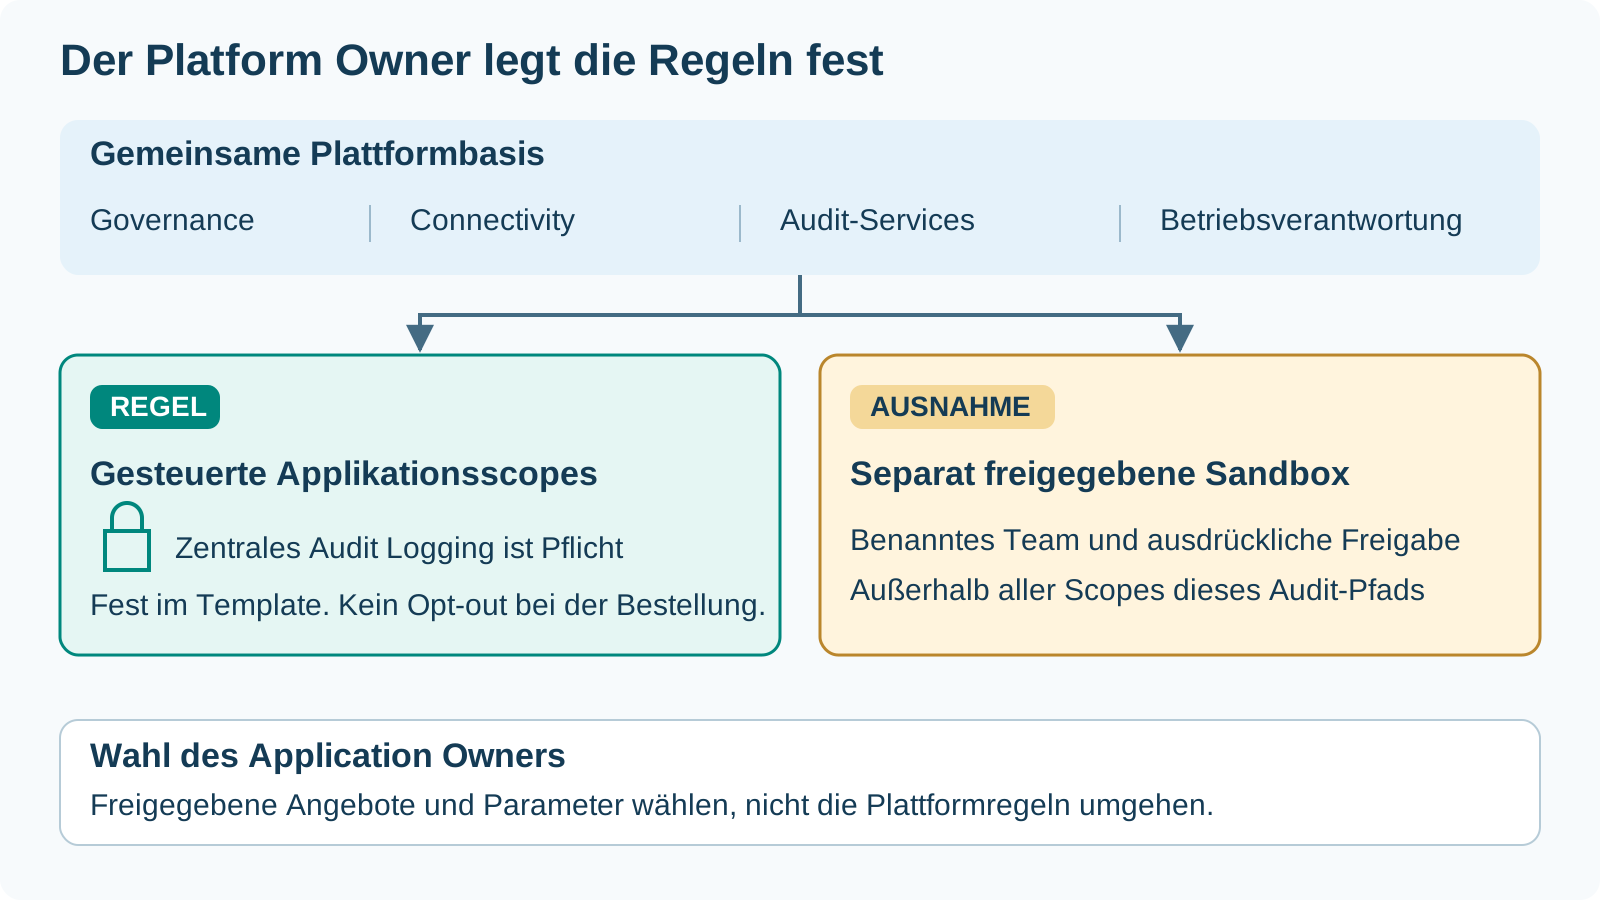
Platform Owner definiert gemeinsame Standards, verpflichtendes Audit Logging und separat freigegebene Sandbox; Application Owner wählen freigegebene Angebote und Parameter
STEP

Die Plattform im Configurator gestalten

Wählen Sie die Referenzkonfiguration im Editor und richten Sie Folder, Connectivity und gemeinsame Services an Applikationsdomäne und Sandbox-Grenze aus.
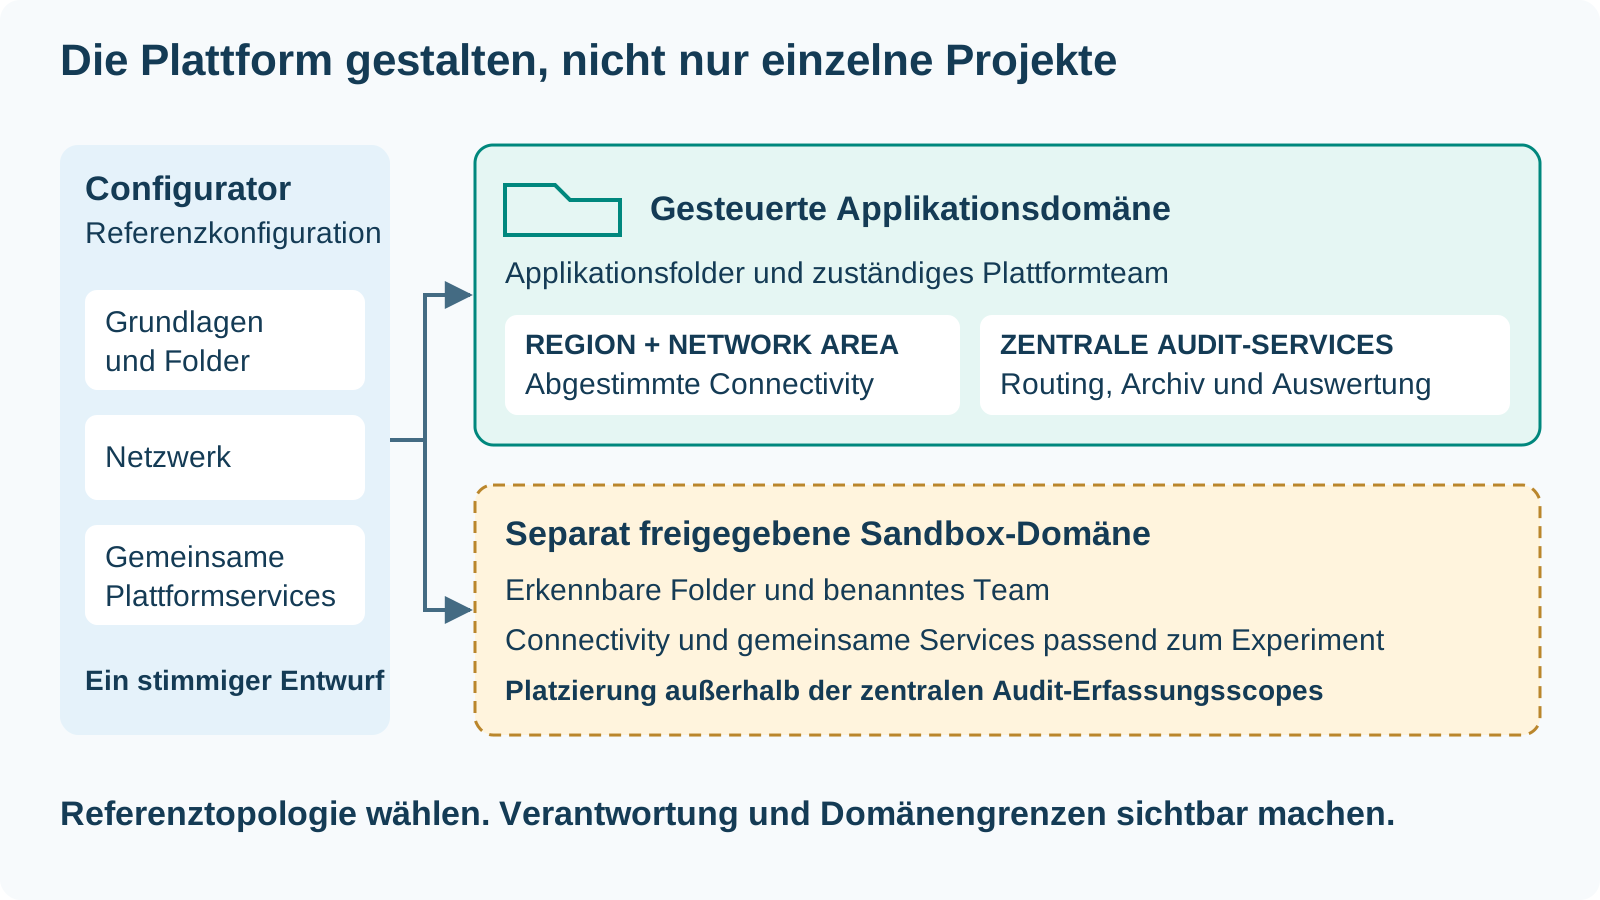
Folder, Netzwerke und Services im Configurator gestalten getrennte Applikations- und Sandbox-Domänen mit klarer Verantwortung und Audit-Grenze
SAFE

Audit Logging über das Projekt-Template vorgeben

Der Platform Owner veröffentlicht die Regel im Template. Der Application Owner wählt eine freigegebene Version und setzt angebotene Parameter, kann verpflichtendes Audit Logging aber nicht deaktivieren. Eine freigegebene Sandbox ist ein separates Angebot.
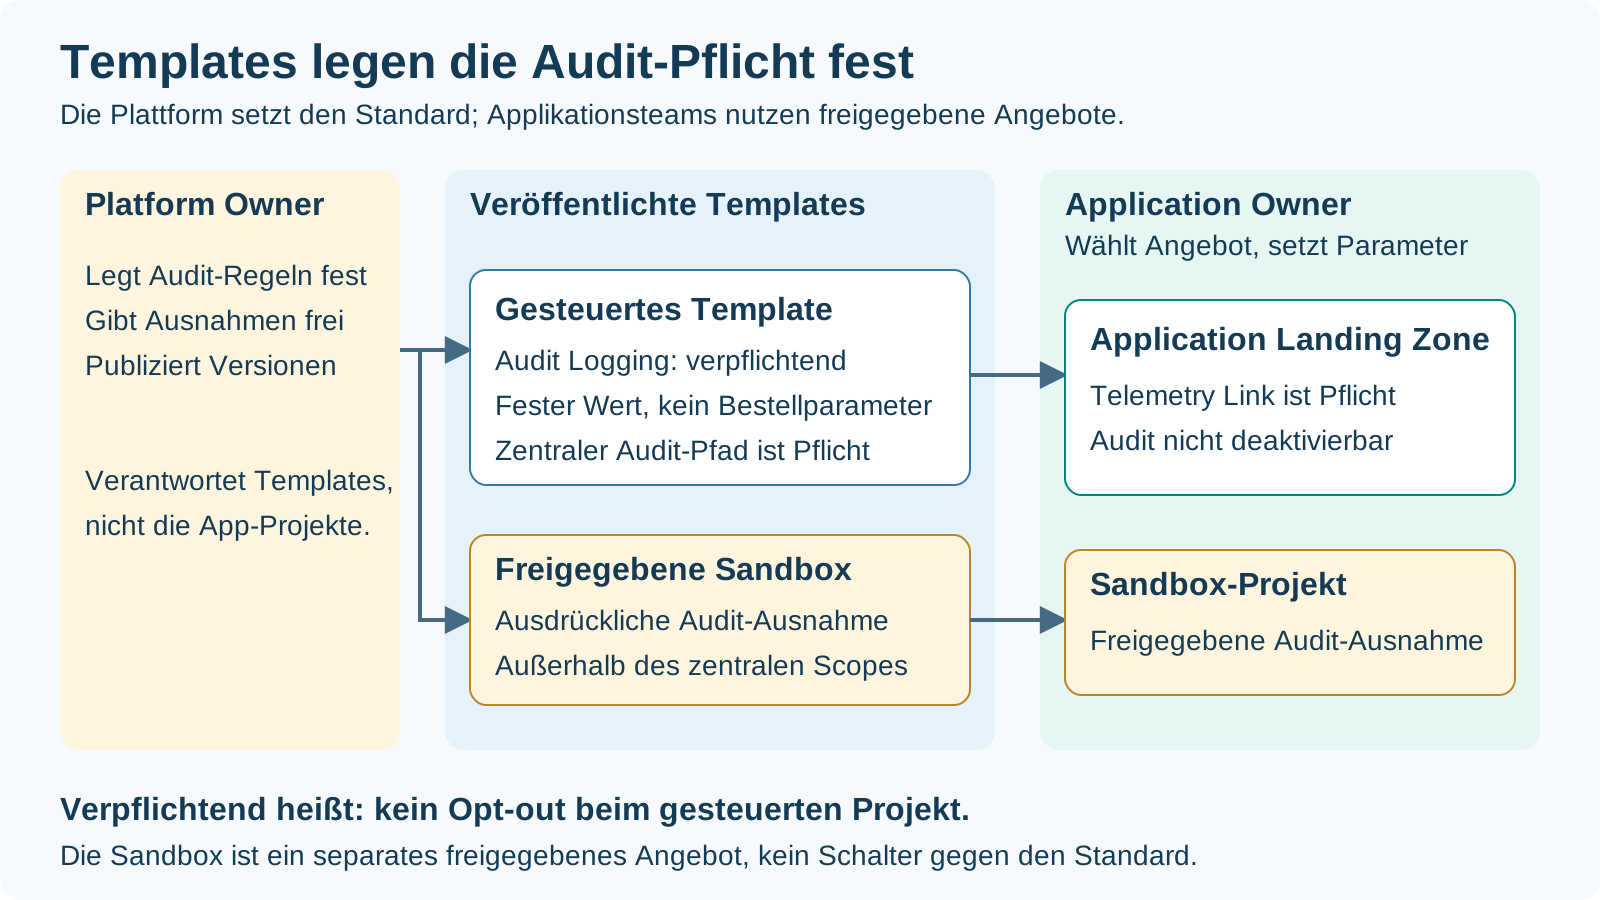
Platform Owner veröffentlicht gesteuerte Templates und freigegebene Sandbox-Templates; Application Owner nutzt sie mit verpflichtendem Telemetry Link oder ausdrücklich freigegebener Sandbox-Ausnahme
OPS

Zentrales Audit Logging

In diesem Audit-Beispiel liefert der Telemetry Link der Application Landing Zone an den zentralen Telemetry Router. Dieser schreibt direkt in Loki innerhalb von Observability und parallel ins S3-Archiv. Grafana macht die Ereignisse durchsuchbar.
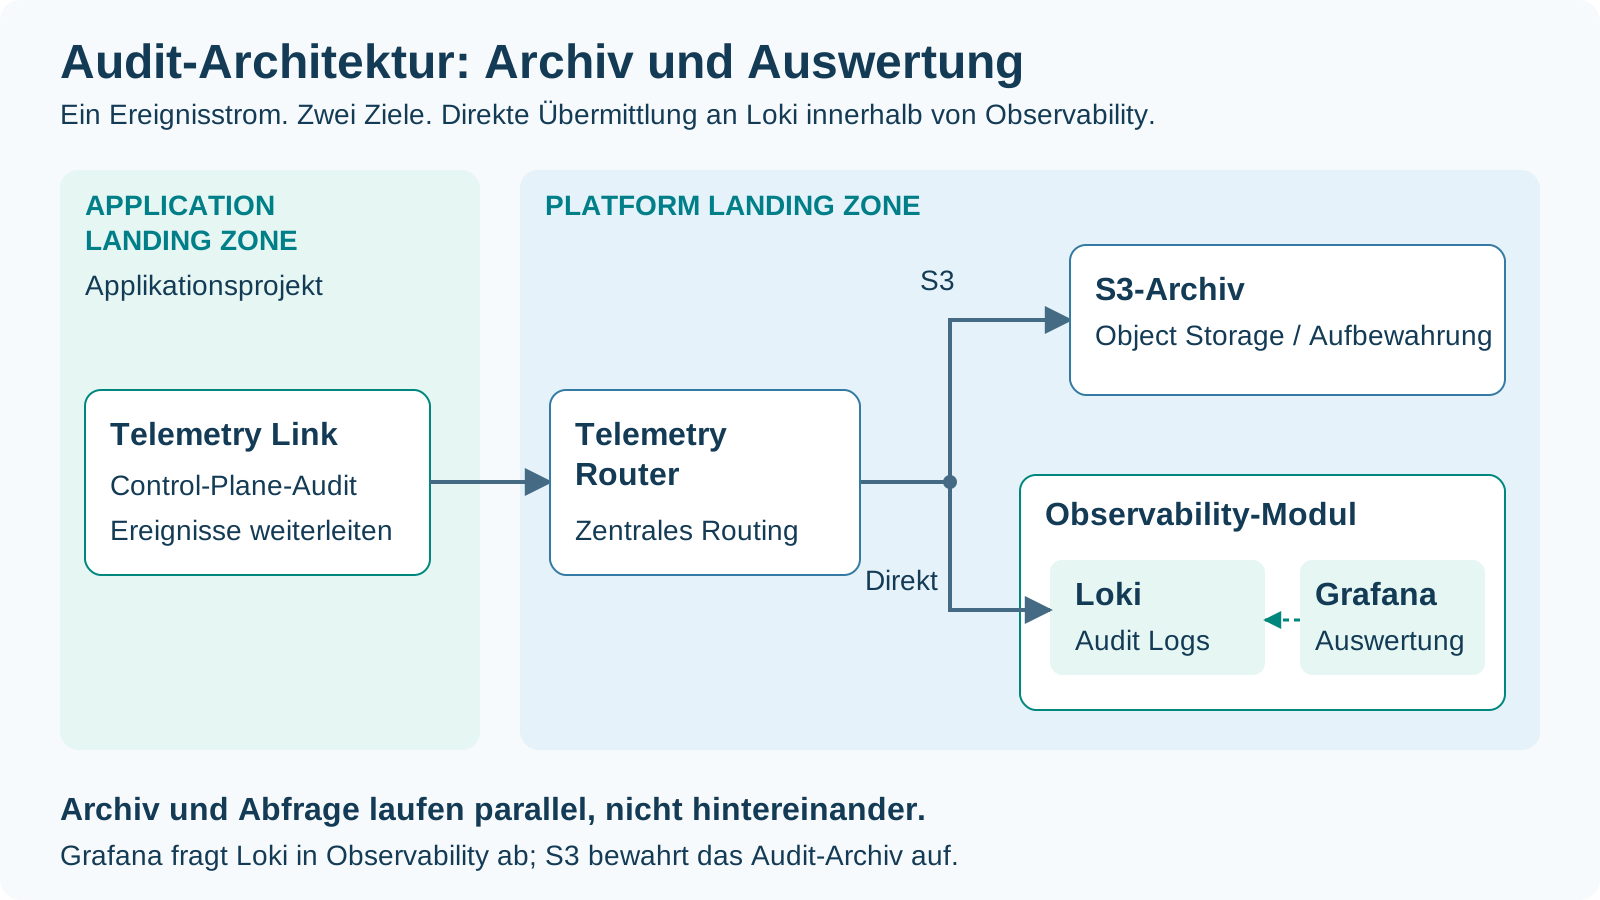
Telemetry Link im Applikationsprojekt liefert an den Plattform-Telemetry-Router; dieser schreibt parallel nach S3 und direkt in Loki innerhalb von Observability; Grafana fragt Loki ab
OPS

Die zentralen Audit Logs in Grafana sehen

Das Dashboard macht den gemeinsamen Audit-Pfad sichtbar: Ereignismenge, regionale Aktivität, HTTP-Methoden und API-Aktionen. Grenzen Sie die Ansicht über Filter ein und untersuchen Sie anschließend ein einzelnes Ereignis in der Rohdatenliste.
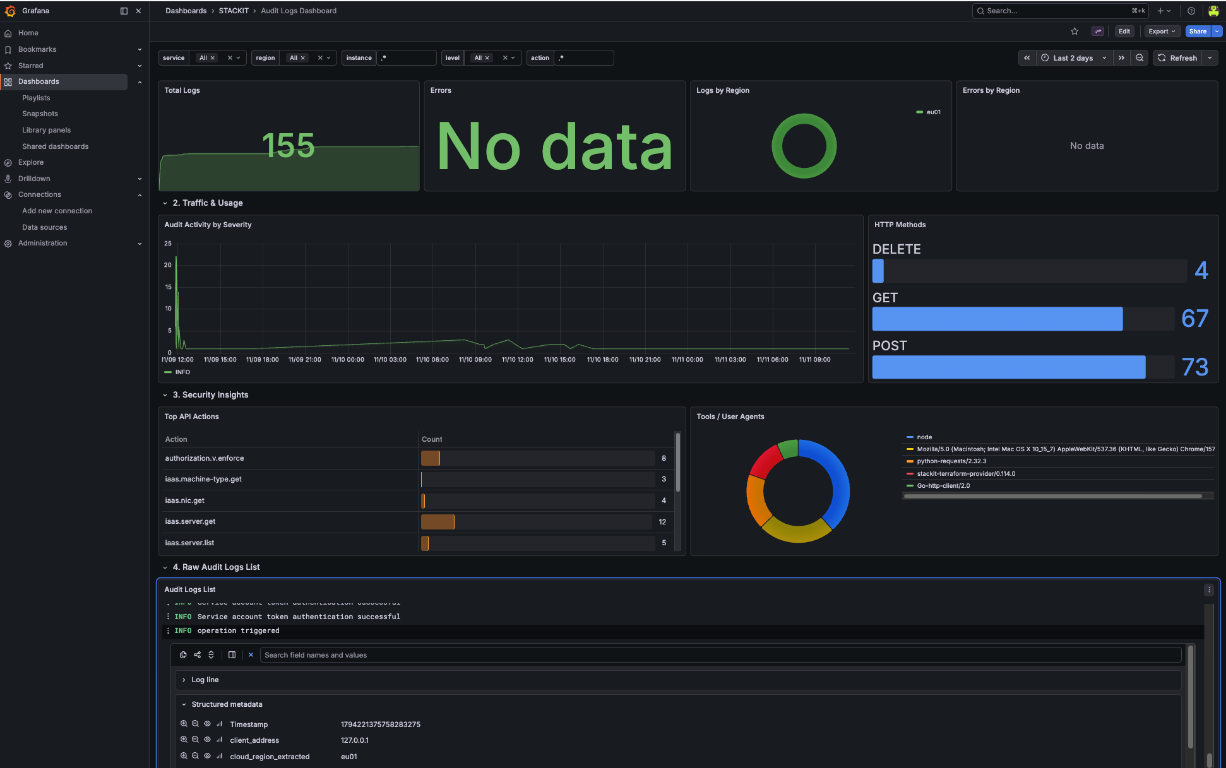
Grafana Audit Logs Dashboard mit 155 Ereignissen, regionaler Aktivität, HTTP-Methoden, API-Aktionen, User Agents und Audit-Rohdatenliste
OPS

Den Audit-Vorschlag mit dem Assistenten prüfen

Nutzen Sie den Assistenten, um die Regel des Platform Owners in einen prüfbaren Konfigurationsvorschlag zu übersetzen. Beginnen Sie mit abgestimmtem Scope und zentralen Services:

Bereite zentrales Audit Logging für unseren gesteuerten Applikationsscope vor, mit S3-Archiv und direkter Übermittlung an Loki in Observability. Halte die freigegebene Sandbox außerhalb dieses Erfassungsscopes. Frage mich nach Aufbewahrung, Leserechten und Object-Lock-Entscheidungen.

Prüfen Sie den Vorschlag gegen dieses Plattformdesign und den gewählten Scope. Kontrollieren Sie beide Router-Ziele, die Übermittlung an Observability/Loki und die Leserechte. Halten Sie die Audit-Pflicht im gesteuerten Projekt-Template fest; veröffentlichen Sie die freigegebene Sandbox als separates Angebot. Übernehmen, Speichern, Plan und Apply bleiben getrennte Aktionen.

LIVE

Plan prüfen und Plattform bereitstellen

Bereiten Sie den Plan aus der gespeicherten Revision vor, prüfen Sie gemeinsame Ressourcen und beide Audit-Ziele und autorisieren Sie Apply des geprüften gespeicherten Plans ausdrücklich.
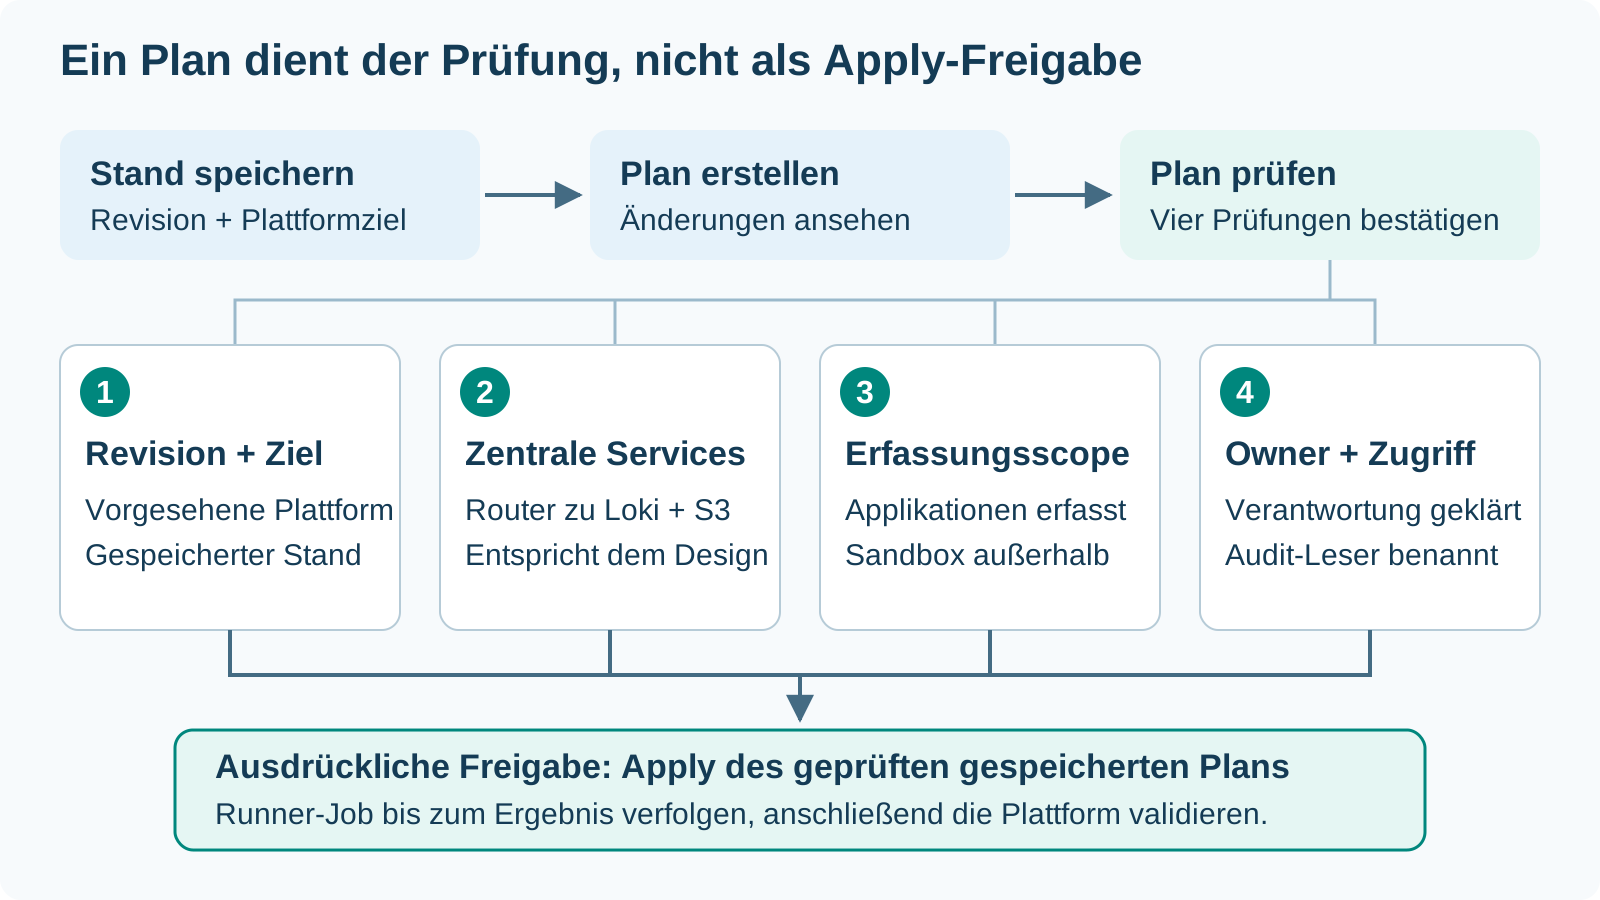
Speichern, Plan erstellen und Revision, zentrale Services, Erfassungsscope und Zugriff prüfen, dann Apply des geprüften gespeicherten Plans ausdrücklich freigeben
SAFE

Gesteuerten Pfad und Sandbox-Ausnahme demonstrieren

Finden Sie das Ereignis eines kontrollierten Projekts im Archiv und in der Loki-gestützten Auswertung. Bestätigen Sie die Sandbox-Grenze vor der Plattformabnahme.
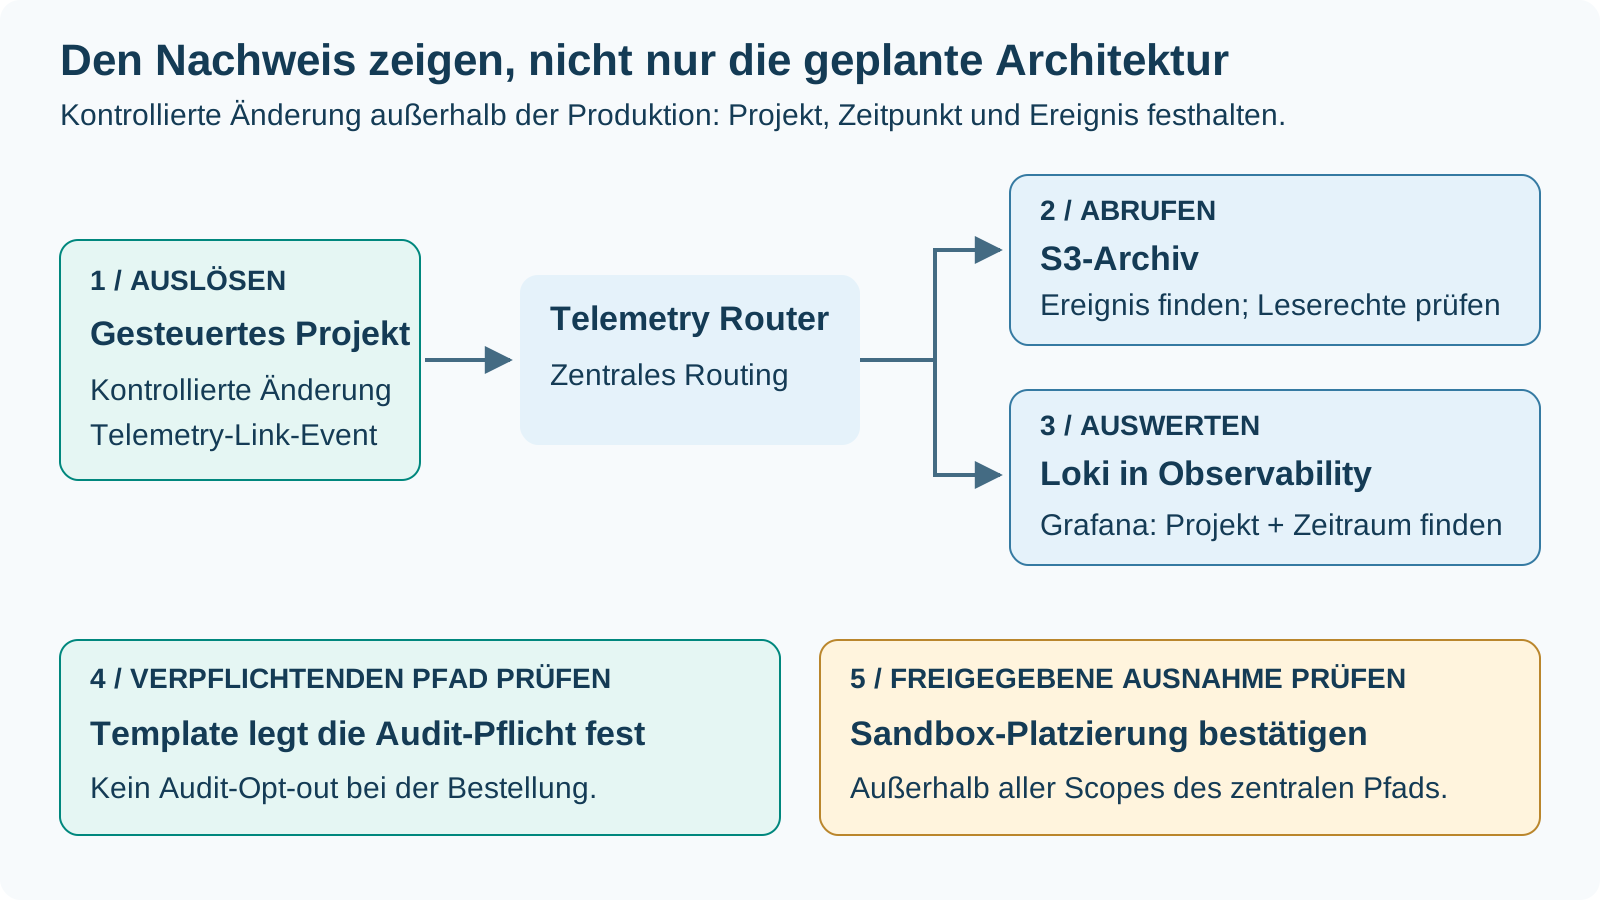
Kontrolliertes Projektereignis auslösen, aus S3 abrufen und über Grafana in Loki finden; Template-Pflicht und Sandbox-Ausnahme getrennt nachweisen
BASE

Die Plattform über ihren Vertrag nutzbar machen

Bereiten Sie den revisionierten, nicht geheimen Platform Contract mit begleitenden Service-/Regel-Referenzen für die Übergabe an die Applikationsbereitstellung vor.
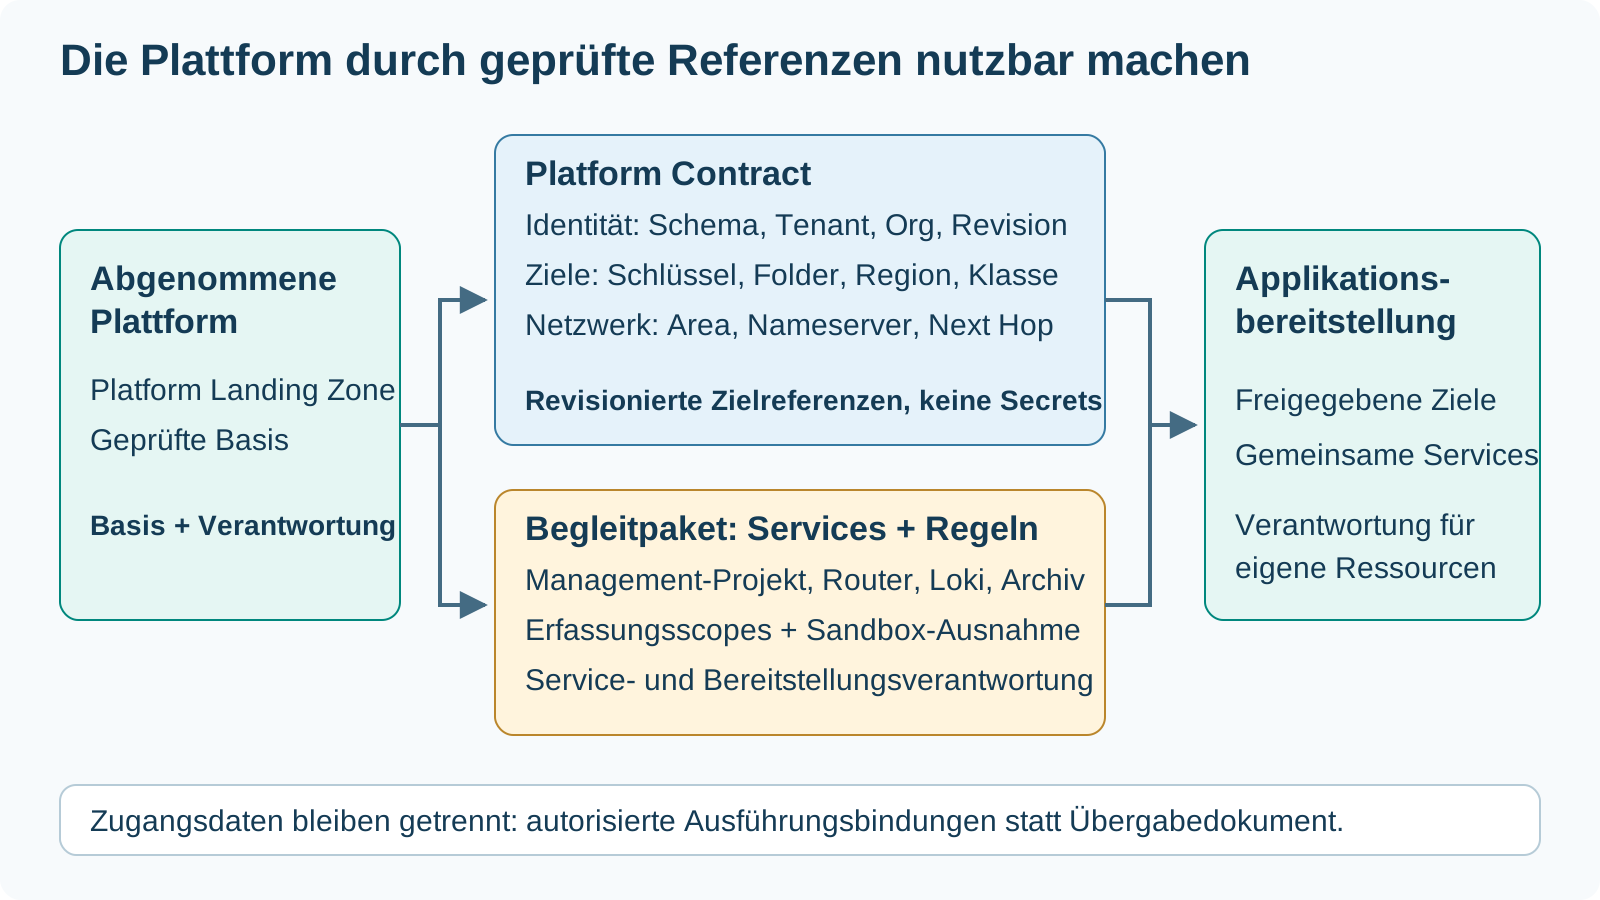
Abgenommene Platform Landing Zone übergibt revisionierte Ziel- und Netzwerkreferenzen sowie separates Audit-Service- und Regelpaket an die Applikationsbereitstellung; Zugangsdaten bleiben getrennt
AUTO

Application Owner: Self-Service in Kürze

Der Application Owner nutzt das Plattformangebot, statt die Plattform zu konfigurieren.

  • Wählen: Ein freigegebenes Projektangebot wählen und dessen Parameter angeben.
  • Prüfen: Projektziel und Plan bestätigen, dann autorisiertes Apply ausdrücklich starten.
  • Abnehmen: Umgebung und plattformdefinierten Audit-Pfad vor der Workload-Bereitstellung validieren.

Eine Sandbox ist eine separate freigegebene Wahl, kein Audit-Bypass-Schalter eines gesteuerten Projekts. Der detaillierte Applikationsablauf bleibt im eigenen Self-Service-Trail.

OPS

Landing Zone Configurator

Web UI und Configurator API führen durch Konfiguration und Prüfung. Der isolierte Runner führt den Accelerator mit OpenTofu gegen die Landing Zones des Kunden aus.
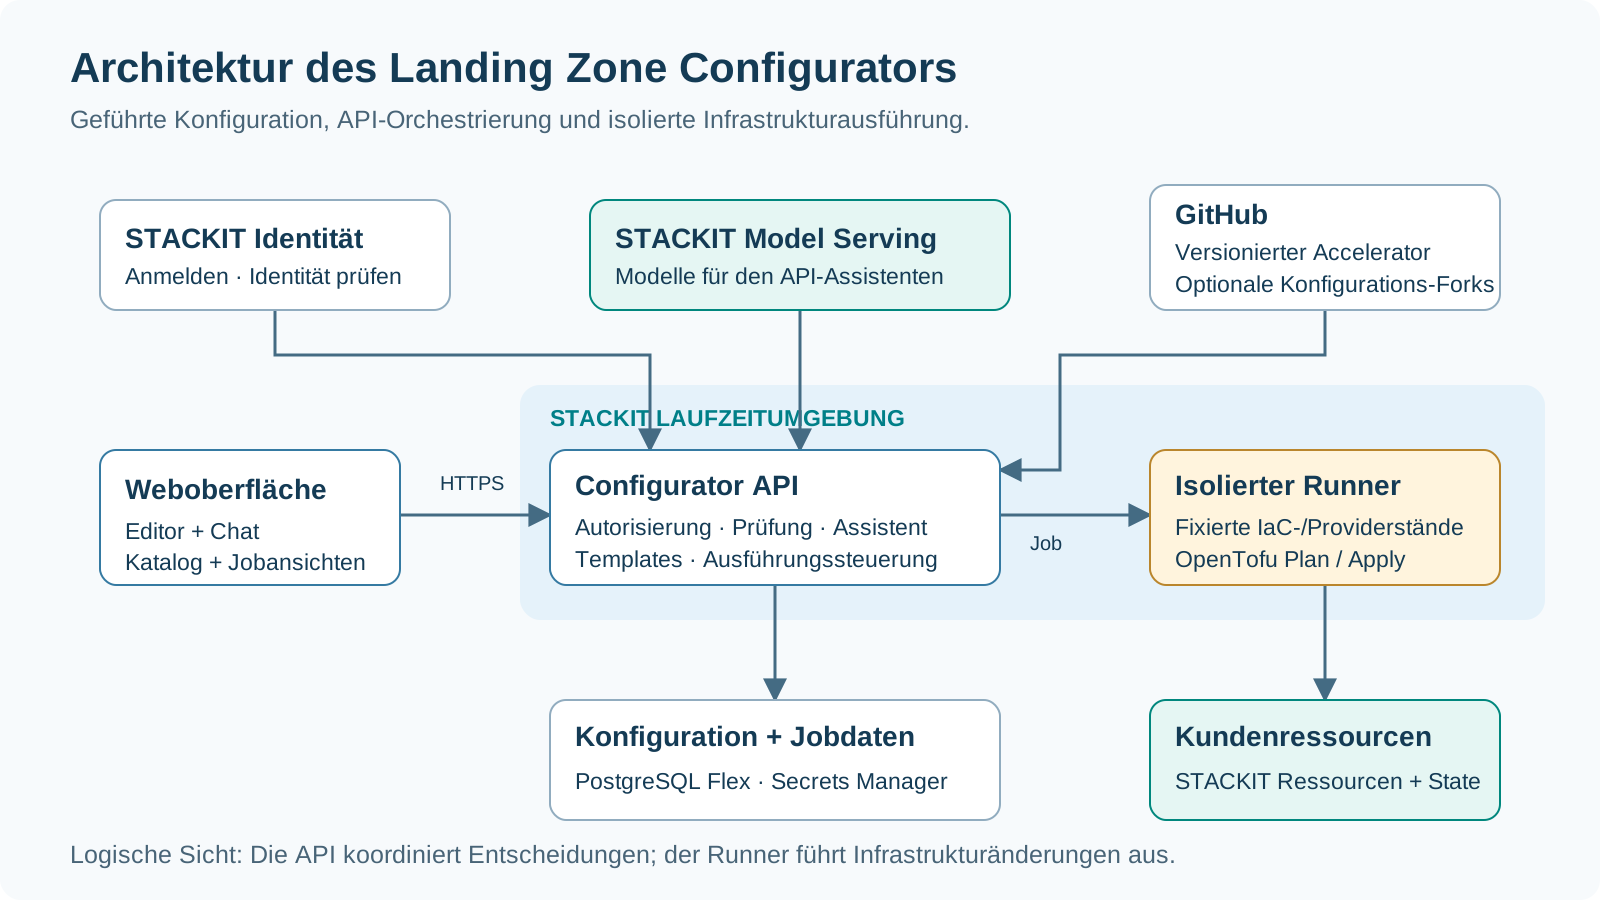
Configurator-Architektur von Web UI, API, Identität, Model Serving und Konfigurationsdaten zum isolierten OpenTofu-Runner und den Kundenressourcen
LIVE

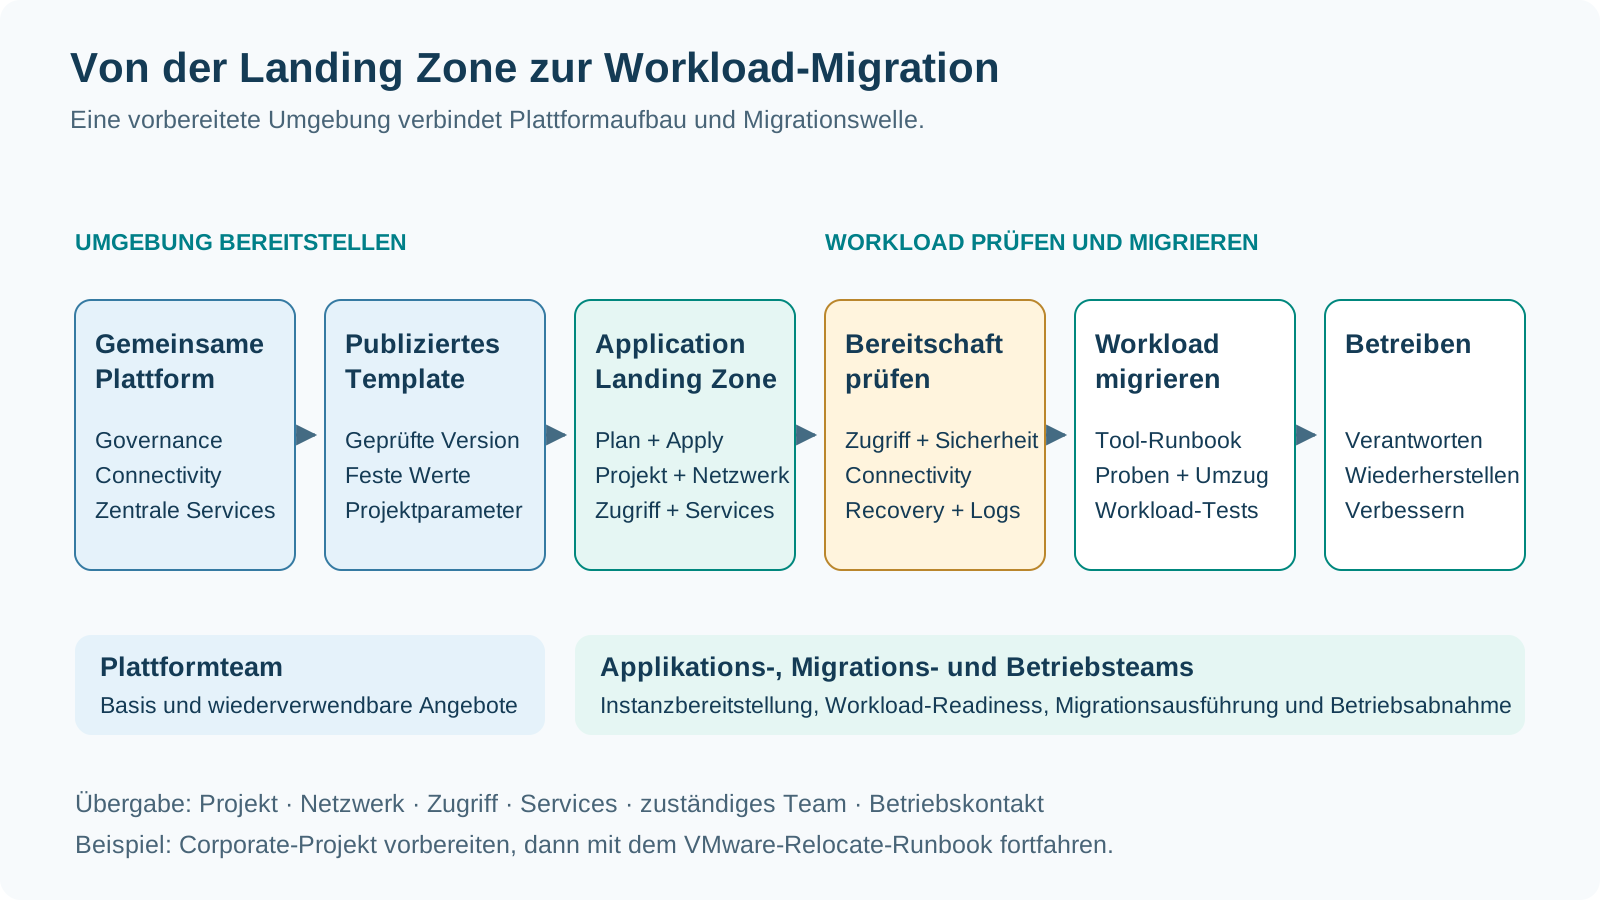
An die Workload-Migration übergeben

Plattformbereitstellung und Template-Veröffentlichung führen zum Applikationsprojekt, zur Readiness-Prüfung, zur Workload-Migration und zur Betriebsabnahme

Die Application Landing Zone ist die Zielumgebung für die nächste Bereitstellungsphase. Übernehmen Sie Projekt-, Netzwerk-, Identitäts- und Servicereferenzen ins Workload-Runbook. Prüfen Sie anwendungsspezifische Zugriffe, Connectivity, Observability und Wiederherstellungsverfahren mit dem Migrationsteam vor Beginn der Welle.

Verbinden Sie für VMware Relocate die vorbereitete Umgebung mit den bestehenden Runbooks für VM-Landing-Zones und Migrationstools. Nutzen Sie für andere Workloads die passende Zielarchitektur und den entsprechenden Bereitstellungsworkflow. Halten Sie Umgebungs- und Workload-Abnahme als erkennbare Meilensteine mit benannten Verantwortlichen fest.

VM Application Landing Zone für Relocate
GOAL

meshStack: Architektur und Self-Service

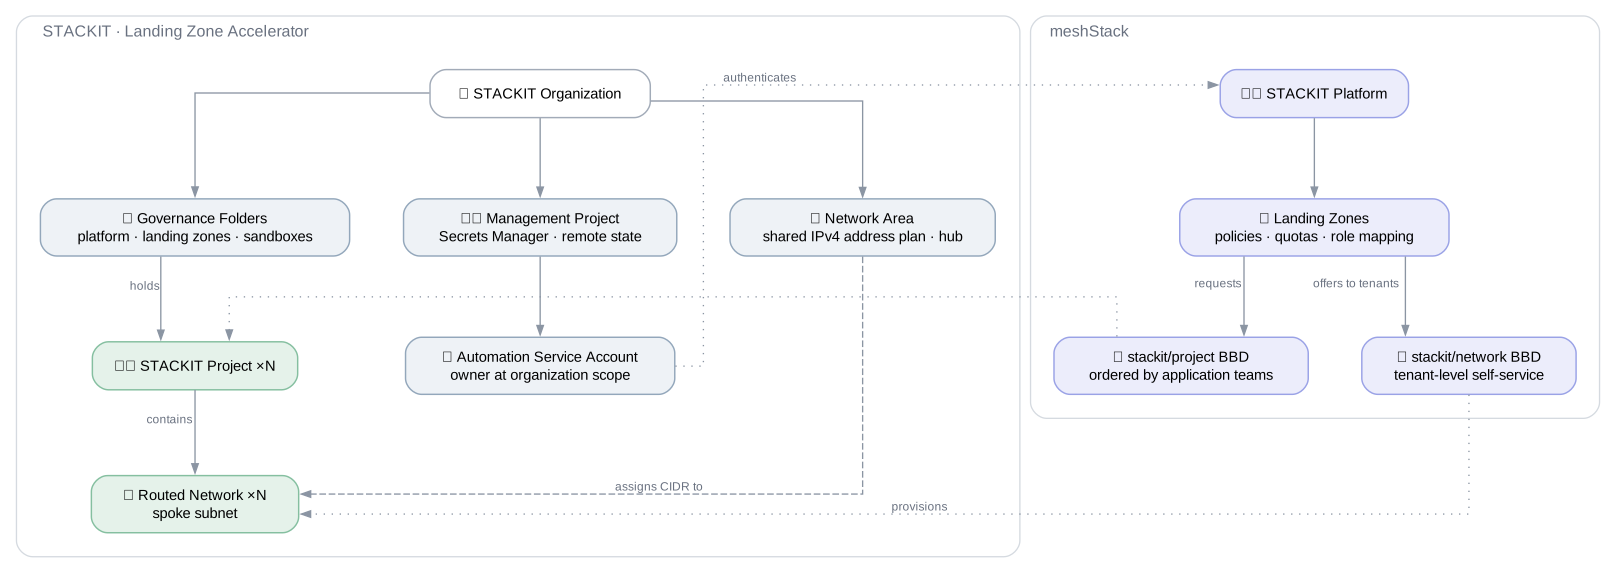
Der STACKIT Landing Zone Accelerator stellt die Plattform-Basis als Code bereit. Diese Referenzarchitektur ergänzt die Schicht darüber: meshStack registriert die STACKIT-Plattform, ihre Landing Zones und eine Reihe von Building Block Definitions. Applikationsteams bestellen STACKIT-Projekte und geroutete Netzwerke damit selbst, anstatt ein Ticket beim Plattformteam zu eröffnen.

Die Umsetzung erfolgt als OpenTofu im meshStack Hub und wird einmal pro Workspace ausgerollt.
GOAL

meshStack: Building Blocks und Verantwortlichkeiten

Das Management-Modul des Accelerators erzeugt einen Automatisierungs-Service-Account, weist ihm owner auf Organisationsebene zu und legt dessen Key im Secrets Manager ab. Genau dieses Credential benötigt die Referenzarchitektur: Sie erwartet einen STACKIT-Service-Account-Key mit resource-manager.admin auf der Organisation. Beide Teile bilden damit einen gemeinsamen Stack: Accelerator ausrollen, den Automatisierungs-Key aus dem Secrets Manager lesen und an die meshStack Landing Zone übergeben.

  • STACKIT-Plattform und Landing Zones: Die Plattform STACKIT Project wird in meshStack samt ihren Landing Zones registriert und mit dem Service Account verbunden, der die Projekte anlegt.
  • Projekt-Building-Block: Eine Building Block Definition stackit/project, über die Applikationsteams ein STACKIT-Projekt bestellen. meshStack-Rollen werden dabei auf STACKIT-Projektrollen abgebildet.
  • Optionales Hub-and-Spoke-Netzwerk: Eine gemeinsame Network Area mit dem IPv4-Adressplan sowie ein Building Block stackit/network auf Tenant-Ebene. Jede Bestellung bezieht ihr Subnetz aus dem gemeinsamen Plan, sodass sich zwei Teams nicht auf denselben CIDR-Bereichen überschneiden können.
  • Self-Service-Starterkit: Eine Definition STACKIT Project Starterkit, die die beiden Building Blocks darüber zu einer einzigen Bestellung zusammenfasst. Sie wird immer registriert, und zur Auswahl stehen genau die Landing Zones, die das Deployment angelegt hat.
  • Ressourcenhierarchie: Ein dedizierter Resourcemanager-Folder für die Tenant-Projekte und ein Foundation-Projekt für den Service Account der Landing Zone.

Ohne Netzwerkkonfiguration wird nur die Sandbox-Basis ausgerollt. Das ist der kleinste sinnvolle Einstieg.

  • Ein fertiges Projekt aus einer Bestellung: Das Starterkit legt das Projekt in der gewählten Landing Zone an und weist die Rollen zu. Niemand muss die Einzelteile nacheinander bestellen.
  • Ein Subnetz ohne Abstimmung: In der Landing Zone mit Netzwerk ergänzt dieselbe Bestellung ein geroutetes Netzwerk in diesem Projekt, dessen CIDR-Bereich aus dem gemeinsamen Adressplan zugewiesen wird.
  • Sichtbare Verantwortlichkeit: Jedes Projekt und jedes Netzwerk hat ein benanntes verantwortliches Team. Darauf setzen Kostenzuordnung und Richtlinien-Reporting auf.
  • Beratung und Zieldesign: Definition von Scope, Kontrollmodell und Rollout-Vorgehen.
  • Katalogbasierte Umsetzung: Strukturierter Aufbau entlang vordefinierter Fähigkeits- und Kontrollkataloge.
  • Technische Befähigung: Umsetzungsunterstützung mit OpenTofu, Terragrunt und Boilerplate-Mustern.
  • Betriebsübergabe: Übergabe in das Kunden-Betriebsmodell mit klar dokumentierten Verantwortlichkeiten.
  • Steuerbare Plattform-Basis: Pflichtkontrollen und Ownership-Grenzen sind wirksam umgesetzt.
  • Wiederverwendbarer Automatisierungs-Stack: IaC-Module und Konventionen sind standardisiert.
  • Schnellere Migrations-Readiness: Produktive Wellen können ohne zentrale Plattform-Blocker starten.
  • Reduziertes Umsetzungsrisiko: Plattform-, Security- und Applikationsteams arbeiten auf einem Modell.

Typischerweise erfolgt die Umsetzung in enger Zusammenarbeit mit Plattform-, Security- und Applikations-Stakeholdern. Der Service kann als fokussierte Setup-Initiative oder als Teil einer Migration Factory bereitgestellt werden.

LIVE

meshStack vereinfacht das Management von Landing Zones

Der STACKIT Landing Zone Accelerator stellt die Plattform-Basis als Code bereit. Diese Referenzarchitektur ergänzt die Schicht darüber: meshStack registriert die STACKIT-Plattform, ihre Landing Zones und eine Reihe von Building Block Definitions. Applikationsteams bestellen STACKIT-Projekte und geroutete Netzwerke damit selbst, anstatt ein Ticket beim Plattformteam zu eröffnen.

Die Umsetzung erfolgt als OpenTofu im meshStack Hub und wird einmal pro Workspace ausgerollt.

Gemeinsame STACKIT- und meshStack-Architektur: Der Landing Zone Accelerator stellt die Plattform-Basis bereit, meshStack ermöglicht gesteuerten Self-Service

Das Management-Modul des Accelerators erzeugt einen Automatisierungs-Service-Account, weist ihm owner auf Organisationsebene zu und legt dessen Key im Secrets Manager ab. Genau dieses Credential benötigt die Referenzarchitektur: Sie erwartet einen STACKIT-Service-Account-Key mit resource-manager.admin auf der Organisation. Beide Teile bilden damit einen gemeinsamen Stack: Accelerator ausrollen, den Automatisierungs-Key aus dem Secrets Manager lesen und an die meshStack Landing Zone übergeben.

GOAL

Projekte und Netzwerke über Self-Service bereitstellen

  • STACKIT-Plattform und Landing Zones: Die Plattform STACKIT Project wird in meshStack samt ihren Landing Zones registriert und mit dem Service Account verbunden, der die Projekte anlegt.
  • Projekt-Building-Block: Eine Building Block Definition stackit/project, über die Applikationsteams ein STACKIT-Projekt bestellen. meshStack-Rollen werden dabei auf STACKIT-Projektrollen abgebildet.
  • Optionales Hub-and-Spoke-Netzwerk: Eine gemeinsame Network Area mit dem IPv4-Adressplan sowie ein Building Block stackit/network auf Tenant-Ebene. Jede Bestellung bezieht ihr Subnetz aus dem gemeinsamen Plan, sodass sich zwei Teams nicht auf denselben CIDR-Bereichen überschneiden können.
  • Self-Service-Starterkit: Eine Definition STACKIT Project Starterkit, die die beiden Building Blocks darüber zu einer einzigen Bestellung zusammenfasst. Sie wird immer registriert, und zur Auswahl stehen genau die Landing Zones, die das Deployment angelegt hat.
  • Ressourcenhierarchie: Ein dedizierter Resourcemanager-Folder für die Tenant-Projekte und ein Foundation-Projekt für den Service Account der Landing Zone.

Ohne Netzwerkkonfiguration wird nur die Sandbox-Basis ausgerollt. Das ist der kleinste sinnvolle Einstieg.

  • Ein fertiges Projekt aus einer Bestellung: Das Starterkit legt das Projekt in der gewählten Landing Zone an und weist die Rollen zu. Niemand muss die Einzelteile nacheinander bestellen.
  • Ein Subnetz ohne Abstimmung: In der Landing Zone mit Netzwerk ergänzt dieselbe Bestellung ein geroutetes Netzwerk in diesem Projekt, dessen CIDR-Bereich aus dem gemeinsamen Adressplan zugewiesen wird.
  • Sichtbare Verantwortlichkeit: Jedes Projekt und jedes Netzwerk hat ein benanntes verantwortliches Team. Darauf setzen Kostenzuordnung und Richtlinien-Reporting auf.