Blueprint
Spring Boot auf SKE mit PostgreSQL Flex und Gateway API
STACKIT
Zuletzt aktualisiert am


Migrieren Sie Spring Boot und PostgreSQL auf SKE und PostgreSQL Flex: Quelle und Ziel vorbereiten, Datenübernahme proben, Cutover prüfen und Betrieb übergeben.
Bestätigen Sie die zwei bewussten Ersetzungen: Aus einem VM-Service wird ein Kubernetes-Deployment, aus VM-lokalem PostgreSQL wird PostgreSQL Flex. Behalten Sie Spring-Music-JAR und fachliches Verhalten bei; dies ist Replatform, kein VM-Rehost oder Anwendungs-Refactor.
Replatform behält das Kernverhalten der Anwendung bei, ändert aber ausgewählte Plattform-Komponenten, um betriebliche oder wirtschaftliche Vorteile zu erreichen. Der Ansatz liegt zwischen Rehost und Refactor.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Das Referenzrepository ist die maßgebliche Quelle für Terraform, Helm-Charts, fest versionierte
Artefakte, Migrationsskripte und Validierung. Verwenden Sie einen geprüften Stand mit den hier
beschriebenen Gateway-API- und scripts/migrate_postgres.py-Workflows. Ein älterer Stand mit
direktem Datenbank-Import-Job implementiert dieses Verfahren nicht.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Verwenden Sie eine isolierte Linux-Laborumgebung mit Git, Terraform, kubectl, curl, jq,
getent, Python ab Version 3.11 sowie PostgreSQL-Server- und Client-Werkzeugen. Die
Rehost-Beispielskripte benötigen außerdem runuser, sha256sum, ein Betriebssystemkonto
postgres und Root-Rechte, um eine temporäre lokale Datenbank zu erstellen und zu prüfen.
Führen Sie die Beispielbefehle in dieser vorbereiteten Laborumgebung aus, nicht auf einem
produktiven Datenbankhost. Die privaten Artefakte müssen für den Migrationsbediener lesbar
bleiben; machen Sie sie nicht für alle Benutzer lesbar.
Beziehen Sie geprüfte Commit-IDs beider Repositorys vom Referenz-Maintainer und exportieren
Sie diese vorab als REHOST_REVISION und REPLATFORM_REVISION. Der Replatform-Stand muss
Gateway API und den freigabegesteuerten Migrationsworkflow enthalten. Setzen Sie nicht voraus,
dass der Remote-Standardbranch bereits die lokal getestete Implementierung enthält. Ist der
freigegebene Stand nicht verfügbar, beschaffen Sie ihn vor dem Walkthrough.
Ersetzen Sie beide Platzhalter durch die freigegebenen vollständigen Commit-IDs mit jeweils 40 Zeichen und setzen Sie diese im selben Bash-Terminal:
export REHOST_REVISION="REPLACE_WITH_REVIEWED_REHOST_COMMIT_ID"export REPLATFORM_REVISION="REPLACE_WITH_REVIEWED_REPLATFORM_COMMIT_ID"Führen Sie den folgenden Block vollständig aus einem leeren Arbeitsverzeichnis aus.
Die if-Prüfung lehnt fehlende, leere oder falsch formatierte IDs einschließlich unveränderter
Platzhalter ab. Jedes && führt den nächsten Befehl nur nach Erfolg des vorherigen aus.
Git prüft die Verfügbarkeit der Commits; die Formatprüfung allein bestätigt weder Freigabe
noch Repository-Inhalt.
if [[ ! ${REHOST_REVISION:-} =~ ^[0-9a-fA-F]{40}$ || ! ${REPLATFORM_REVISION:-} =~ ^[0-9a-fA-F]{40}$ ]]; then printf '%s\n' "Set both revision variables to reviewed full 40-character commit IDs." >&2 falseelse umask 077 && git clone https://github.com/stackitcloud/stackit-cmf-Rehost-springboot.git && git clone https://github.com/stackitcloud/stackit-cmf-replatform-springboot-k8s.git && git -C stackit-cmf-Rehost-springboot checkout --detach "$REHOST_REVISION" && git -C stackit-cmf-replatform-springboot-k8s checkout --detach "$REPLATFORM_REVISION" && test -f stackit-cmf-replatform-springboot-k8s/scripts/migrate_postgres.py && test -f stackit-cmf-replatform-springboot-k8s/scripts/validate_gateway.sh && cd stackit-cmf-replatform-springboot-k8s && printf '%s\n' "Workspace ready. Continue from this Replatform checkout." || { printf '%s\n' "Preparation failed. Resolve the error before continuing." >&2 false }fiFahren Sie erst nach der Meldung Workspace ready fort. Bei Fehlern bleibt das Terminal
offen; weitere Vorbereitungsbefehle werden übersprungen. Vorhandene oder teilweise geklonte
Verzeichnisse werden weder entfernt noch überschrieben: Prüfen Sie diese und bewahren Sie
lokale Änderungen, bevor Sie es in einem neuen leeren Arbeitsverzeichnis erneut versuchen.
Nach Erfolg befindet sich das Terminal für die nächsten Schritte im Replatform-Checkout.
Nutzen Sie ein freigegebenes STACKIT Projekt, einen Service Account, DNS-Delegation, SKE-Kapazität und ein geschütztes Terraform-Backend. Beziehen Sie Zugangsdaten über den freigegebenen Secret-Kanal, niemals aus diesem Trail. Die folgenden Befehle setzen diese Verzeichnisstruktur und eine geprüfte Konfiguration voraus; sie belegen keinen validierten Greenfield-Produktionsaufbau.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Qualifizieren Sie einen konsistenten Quelldump und sein Manifest, bevor Daten in den Migrationsworkflow eingehen.
Die Rehost-Referenz liefert scripts/create_source_dump.sh und scripts/validate_source_dump.sh
für ihr reproduzierbares Beispiel. Führen Sie diese im Rehost-Repository aus. Dessen Verzeichnis
artifacts liefert source-postgresql.dump und source-postgresql.manifest an den
Replatform-Workflow. Das Manifest erfasst Version 1, table=public.album, row_count,
album_fingerprint und dump_sha256.
Führen Sie ausschließlich für das reproduzierbare Beispiel die folgenden Befehle vom Replatform-Checkout in der vorbereiteten Laborumgebung aus. Die Skripte erstellen aus dem versionierten Beispiel-SQL eine temporäre PostgreSQL-Instanz, exportieren sie und führen einen unabhängigen Test-Restore aus. Verwenden Sie ein frisches Artefaktverzeichnis; überschreiben Sie keine Nachweise einer bereits laufenden Migration.
umask 077pushd ../stackit-cmf-Rehost-springbootbash scripts/create_source_dump.shbash scripts/validate_source_dump.shpopdErwartet wird eine erfolgreiche Validierung von acht Zeilen mit passendem Fingerprint. Diese Befehle lesen keine Quell-VM aus. Verwenden Sie für Probe und Cutover genau diese Artefakte weiter.
Ersetzen Sie für eine reale Quelle den Beispielgenerator durch ein freigegebenes Exportverfahren: Frieren Sie alle Schreibzugriffe ein und leiten Sie Dump im Custom-Format und Manifest aus demselben konsistenten Quellsnapshot ab. Das generierte Beispiel mit acht Alben ist kein Export einer beliebigen laufenden VM. Prüfen Sie vor dem Export PostgreSQL-Kompatibilität, Erweiterungen, Eigentümerschaft und Schemaabhängigkeiten.
Stellen Sie nur vertrauenswürdige Dumps wieder her, da sie SQL ausführen. Diese Implementierung
migriert das Anwendungsschema public und prüft public.album; von Flex verwaltete Schemas
sind bewusst ausgeschlossen. Andere Workloads benötigen eigene Invarianten und einen angepassten Schemaumfang.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Diese Werte aktivieren den vollständigen Workload- und Datenbankpfad. Sie ergänzen die Angaben zu Projekt, Region, Node Pool und DNS im Repository-Beispiel, ersetzen sie aber nicht.
deploy_workload = truedns_enabled = trueenable_postgres_flex = truepostgres_flex_target_database = "springmusic"postgres_flex_target_app_acl_cidrs = []observability_enabled = truecreate_observability_instance = truecreate_grafana_dashboard = trueenable_springboot_hpa = falseenable_load_generator = falsedeploy_postgres_migration_job = falseLassen Sie HPA und Lastgenerierung während der Migration deaktiviert. Wählen Sie
Alarmeinstellungen bewusst; die Alarmzustellung wurde im End-to-End-Test nicht validiert.
springboot_image wählt die Java-Laufzeit, nicht ein beliebiges vorgefertigtes Anwendungsimage.
Der Init-Container lädt das auf einen Commit fixierte Rehost-JAR und prüft vor dem Start seinen
SHA-256-Wert. Spiegeln Sie unveränderliche Artefakte für die Produktion in freigegebene Artefakt- und Image-Dienste.
Führen Sie die Befehle im Replatform-Repository aus und prüfen Sie den gespeicherten Plan vor dem Apply:
umask 077terraform initterraform validateterraform plan -var-file=env.tfvars -out=tfplanterraform apply tfplanbash scripts/validate_gateway.shSTACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Stellen Sie das Ziel aus einem geprüften Plan mit expliziten Angaben zu Projekt, Kapazität, Zugriff und DNS bereit.
Verwenden Sie Terraform, kubectl, curl, jq, getent und Python ab Version 3.11 unter Linux.
Kopieren Sie env.tfvars.example nach env.tfvars und passen Sie die tatsächlichen Variablen
dieser Datei an. Behalten Sie die getestete Provider-Lockdatei und unveränderliche Image- und
JAR-Referenzen bei. Bestätigen Sie vor dem Plan die Verfügbarkeit der SKE-Version,
Node-Pool-Kapazität, Projektberechtigungen und DNS-Delegation.
Starting with Kubernetes v1.33, we remove minor versions on the patch day that precedes the upstream maintenance end-of-life (EOL) date. The following table below lists the upstream EOL date for each Kubernetes minor version and the corresponding expiration date in SKE:
| Kubernetes minor version | End-of-life date | Expiration in SKE |
|---|---|---|
| v1.35 | 2027-02-28 | 2027-02-10 |
| v1.36 | 2027-06-28 | 2027-06-09 |
| v1.37 | 2027-10-28 | 2027-10-13 |
Please refer to the official Kubernetes Release History for up-to-date announcements of new versions.
Dieser Abschnitt wird mehrmals am Tag automatisch aus der STACKIT-Doku übernommen. Hier lässt er sich nicht ändern. Änderungen gehören in die STACKIT-Doku.
Bevorzugen Sie ein freigegebenes Application-Landing-Zone-Projekt. Setzen Sie create_project = false
und geben Sie Projekt-ID und Pfad zum Service-Account-Schlüssel an. Die alternative Projekterstellung
setzt einen freigegebenen übergeordneten Container und Berechtigungen voraus; sie ersetzt keine
Landing-Zone-Governance. Zugangsdaten, State, gespeicherte Pläne und Migrationsnachweise gehören nie in die Versionsverwaltung.
Erstellen Sie für einen neuen Checkout die private Variablendatei, ohne eine vorhandene zu überschreiben:
umask 077test -e env.tfvars || cp env.tfvars.example env.tfvarschmod 600 env.tfvarsBearbeiten Sie diese Datei vor dem Plan: Tragen Sie freigegebenes Projekt und Service-Account-Pfad, Region, unterstützte SKE-Version, verfügbaren Node-Pool-Flavor samt Zone und delegierte DNS-Einstellungen aus dem Repository-Beispiel ein. Prüfen Sie Backend-Zugriff und Sperren, Quotas, Kosten sowie die Grenzen von HTTP und öffentlichen Metriken. Die folgenden Funktionsschalter bilden keine vollständige Umgebungskonfiguration.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Bei leeren Anwendungs-ACL-Eingaben verwendet Terraform die tatsächlichen Egress-CIDRs des
SKE-Clusters für PostgreSQL Flex. Explizite Anwendungs- oder ältere ACL-Werte überschreiben
diesen Standard und müssen geprüft werden. Erlauben Sie nicht 0.0.0.0/0.
Der temporäre PostgreSQL-Client läuft in SKE und erhält den Dump über kubectl. Er verbindet sich
nicht direkt mit der Quell-VM; weder Quell- noch Arbeitsplatz-CIDRs benötigen temporären
Flex-Zugriff. JDBC und Datenbankwerkzeuge verwenden sslmode=require: Das erzwingt
Verschlüsselung, bietet aber nicht die Hostnamenprüfung von verify-full. Schützen Sie
Zugangsdaten in Kubernetes Secrets und im Terraform-Backend und validieren Sie bei Bedarf eine stärkere Zertifikatsprüfung.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Exportieren Sie eine kurzlebige Kubeconfig mit privaten Berechtigungen und prüfen Sie den Standard-Namespace der Referenz:
umask 077mkdir -p .tmpterraform output -raw kubeconfig > .tmp/replatform.kubeconfigexport KUBECONFIG="$PWD/.tmp/replatform.kubeconfig"kubectl get deploy,svc,pods -n springbootkubectl get gateway,httproute -n springbootkubectl rollout status deployment/springboot -n springbootbash scripts/validate_gateway.shDer Gateway-Validator prüft Akzeptanz, aufgelöste Routenreferenzen, DNS und Anwendungsantwort. Entfernen Sie die lokale Kubeconfig nach Gebrauch und beziehen Sie nach Ablauf eine neue. Ein erfolgreicher Rollout allein ist keine Daten- oder fachliche Abnahme.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Terraform verwaltet den Grafana-Ordner SCF Replatform und das Dashboard mit acht Panels an
der vorhandenen Datenquelle Thanos. Öffnen Sie es über grafana_dashboard_url.
Cluster-CPU, Cluster-Speicher, laufende Pods, Anwendungsanfragen sowie PostgreSQL-Zustand und
-Auslastung unterstützen Abnahme und spätere Optimierung. Ein manueller Dashboard-Import ist nicht nötig.
Anwendungsmetriken stammen aus dem pod-lokalen Boot-2-Actuator über den Metrikadapter auf Port 9090; der PostgreSQL-Exporter nutzt Port 9187. Prüfen Sie beide tatsächlichen Scrape-Ergebnisse, nicht nur die Dashboard-Darstellung. Fehlende Telemetrie ist ein Untersuchungsgrund, niemals der Nachweis fehlender Last.
Stellen Sie den finalen Dump in der isolierten Probedatenbank wieder her und verlangen Sie passende Nachweise, die jünger als 24 Stunden sind.
Führen Sie nach dem Infrastruktur-Apply einen isolierten Restore in springmusic_rehearsal aus.
Passen Sie das Quellverzeichnis an die freigegebenen Artefakte an und halten Sie den Nachweispfad privat.
python3 scripts/migrate_postgres.py rehearse \ --artifacts ../stackit-cmf-Rehost-springboot/artifacts \ --evidence .tmp/migration-runDie Probe validiert Manifest, Dump-Prüfsumme, Zielidentität, Zeilenanzahl und Fingerprint, ohne die Anwendungsdatenbank zu ersetzen. Proben Sie nach dem Schreibstopp auf der Quelle erneut mit dem finalen Dump. Der Cutover verlangt passende Nachweise, die jünger als 24 Stunden sind. Eine erfolgreiche Probe mit einem älteren oder anderen Dump gibt die finale Eingabe nicht frei.
Bestätigen Sie Schreibkontrolle, pausierte Reconciliation, Verantwortlichkeiten, Abnahmekriterien und Rollback-Deadline.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
bash scripts/validate_gateway.sh ausführen und Workload-Rollout sowie PostgreSQL-Konnektivität prüfen.enable_springboot_hpa = false, enable_load_generator = false und deploy_postgres_migration_job = false setzen; diese Einstellungen vor dem Pausieren der Infrastrukturautomatisierung anwenden.python3 scripts/migrate_postgres.py rehearse \ --artifacts ../stackit-cmf-Rehost-springboot/artifacts \ --evidence .tmp/migration-runpython3 scripts/migrate_postgres.py cutover \ --artifacts ../stackit-cmf-Rehost-springboot/artifacts \ --evidence .tmp/migration-run \ --source-write-frozen --confirm-target springmusicNehmen Sie nur mit übereinstimmenden Datennachweisen, erfolgreichen Clientanfragen, gesunder Laufzeit und tatsächlicher Telemetrie ab.
| Freigabepunkt | Erforderlicher Nachweis |
|---|---|
| Datenintegrität | Prüfsumme des Quellmanifests, erwartete Anzahl und Fingerprint stimmen mit dem wiederhergestellten Ziel überein; das Migrationsjournal benennt das richtige Projekt und die Datenbank |
| Laufzeit | Ursprüngliche Replikazahl wiederhergestellt, gesunder Rollout, keine unerklärten Neustarts oder Verbindungsfehler |
| Netzwerkverkehr | Gateway akzeptiert, HTTPRoute-Referenzen aufgelöst, DNS entspricht dem Gateway, tatsächliche Clientanfragen erreichen das beabsichtigte Ziel |
| Fachliches Verhalten | Migrierte Alben sichtbar und freigegebene Benutzerabläufe erfolgreich; Schreibtests besitzen einen vereinbarten Bereinigungs- und Abgleichplan |
| Datenbanktransport | Anwendung und Migration verlangen TLS; ACL erlaubt nur freigegebenes SKE-Egress oder explizit genehmigte Ausnahmen |
| Observability | Beide Scrape-Jobs liefern tatsächliche up=1-Messwerte, der Exporter meldet Datenbankzustand und Dashboard-Werte entsprechen dem Workload |
| Recovery | Backup vor dem Cutover, Prüfsumme, ursprünglicher Fingerprint und Journal privat aufbewahrt und in geschützten dauerhaften Speicher kopiert |
| Konfiguration | Geprüfter Plan nach der Migration ohne unerklärte Ressourcendrift; Betriebszustände von Quelle und Ziel dokumentiert |
Ein erfolgreicher öffentlicher HTTP-Aufruf erfüllt allein keine produktive HTTPS-Anforderung. Das Beispiel-Dashboard ersetzt keine unabhängige fachliche, Latenzperzentil-, Fehlerraten- oder Recovery-Validierung.
Stellen Sie bei einem freigegebenen Auslöser das geschützte Ziel wieder her; gleichen Sie Schreibzugriffe nach dem Cutover ab und entscheiden Sie den Quell-Failback separat.
Treffen Sie die vereinbarte Entscheidung vor der Deadline, wenn Dateninvarianten verletzt sind, ein kritischer fachlicher Ablauf nicht im Fehlerbehebungsfenster wiederhergestellt werden kann, Zielinstabilität die Abnahmegrenzen überschreitet oder keine vertrauenswürdige Telemetrie festgestellt werden kann. Bewahren Sie Migrationsjournal und Logs auf.
python3 scripts/migrate_postgres.py rollback \ --evidence .tmp/migration-run --confirm-target springmusicDie Rückkehr der Benutzer zur VM ist eine separate Entscheidung: Quellintegrität bestätigen, angenommene Zielschreibzugriffe abgleichen, Client-Traffic nach dem freigegebenen Verfahren umleiten und genau einer Seite Schreibzugriffe erlauben. Der Restore des Ziels vor dem Cutover allein führt diese Schritte nicht aus.
Schlägt der Cutover fehl, bevor ein gültiges Backup dokumentiert ist, prüfen Sie Journal und
Datenbank gemeinsam mit den Datenbankverantwortlichen. Überschreiben Sie niemals das
Nachweisverzeichnis und starten Sie den Cutover nicht blind erneut. Prüfen Sie nach einem
beendeten Prozess verbliebene Pods mit Präfix springmusic-migration-* und das gestoppte
Deployment, bevor Sie fortfahren. Die lokale Migrationssperre koordiniert keine unterschiedlichen Ausführungshosts.
Übergeben Sie Konfiguration, Abnahmenachweise, Dashboards, Incident-Verantwortung und Entscheidungen zur Quellaufbewahrung.
Übergeben Sie den geprüften Konfigurationsstand, Workload- und Gateway-Inventar, Quellmanifest, Migrationsjournal, Backup-Orte, Abnahmeergebnisse, Dashboard-URL und Rollback-Entscheidung. Halten Sie Zugangsdaten aus dem Übergabedokument heraus und verweisen Sie auf den freigegebenen Secret-Speicher.
Vereinbaren Sie ein zum Workload passendes anfängliches Stabilisierungsfenster von 24 bis 72 Stunden. Benennen Sie Incident- und Datenbank-Recovery-Verantwortliche, bestätigen Sie Aufbewahrungs- und Restore-Verfahren und testen Sie Alarmzustellung, bevor Sie sich darauf verlassen. Flex-Backups ergänzen Migrationsdumps; ein verifizierter Dump-Rollback ist kein Nachweis für Managed-Service-Recovery.
Beenden Sie die Stabilisierung nur bei dauerhaft gesundem fachlichem Verhalten, vollständiger Telemetrie, ohne ungelöste kritische Probleme und mit Betriebsfreigabe. Nehmen Sie pausierte Automatisierung bewusst wieder auf. Bewahren Sie Quelldaten und geschützte Nachweise auf, bis die vereinbarten Aufbewahrungs- und Abgleichkriterien die Stilllegung erlauben. Beginnen Sie HPA- und Kapazitätsexperimente erst nach der Stabilisierung in einem separaten Änderungsfenster.
Trennen Sie Migrations-Rollback von Flex-Service-Recovery und bewahren Sie geschützte Nachweise außerhalb kurzlebiger Ausführungsumgebungen auf.
Die Flex-Aufbewahrung wird explizit konfiguriert; der Standard dieser Referenz beträgt 32 Tage. Managed-Datenbankbackups und der Migrationsdump vor dem Cutover dienen unterschiedlichen Zwecken. Die Probe mit Letzterem weist weder Managed-Service-Restore noch Point-in-Time-Recovery oder Disaster Recovery der Anwendung nach. Benennen Sie Recovery-Verantwortliche und testen Sie den benötigten Service-Recovery-Pfad separat.
Bewahren Sie geschützte Nachweise und Backups bis zum Ende des Rollback-Fensters außerhalb eines
kurzlebigen Dev Containers auf. Prüfen Sie nach einem abgebrochenen Migrationsprozess verbliebene
Pods mit Präfix springmusic-migration-*, bevor Sie fortfahren; starten Sie ein ungeprüftes Ziel nicht durch Terraform neu.
Dieses Asset zeigt, wie das Anwendungsverhalten beim Wechsel der Betriebsmodelle für Laufzeit und Datenbank erhalten bleibt:
Diese Nachweise bestätigen weder einen vollständigen Greenfield-Durchlauf noch eine Migration aus einer produktiven Live-Quelle, unterbrechungsfreien Betrieb, Hochverfügbarkeit, öffentliches Gateway-TLS, interaktiven IDP-Login, Alarmzustellung oder Managed-Flex-Recovery. Der getestete Ein-Worker-Aufbau mit HTTP stellt Metriken ohne Authentifizierung bereit; erfüllen Sie die Produktionsanforderungen vor der Verwendung sensibler Daten. Aktualisieren Sie die Beispielanwendung und validieren Sie eine geeignete unterstützte Kubernetes-Version als separate kontrollierte Änderungen.
Referenzkonfiguration, Skripte und Validierungsnachweise Das Repository-README und die versionierte Implementierung liefern genaue Voraussetzungen, Variablen, Befehle und Recovery-Grenzen. Repository öffnenKehren Sie zum Optimize-Zyklus des Migration Framework zurück: repräsentative Betriebsnachweise sammeln, begrenzende Ebene identifizieren, eine kontrollierte Änderung umsetzen und Zuverlässigkeit, Performance sowie Kosten vor dem Beibehalten validieren.
Optimize startet, sobald Workloads auf STACKIT laufen und reale Daten aus dem Betrieb vorliegen. Das Modul überführt Beobachtungen aus dem Betrieb in messbare Verbesserungen für Performance, Stabilität und Wirtschaftlichkeit.
Optimize ist keine einmalige Aufgabe, sondern ein iterativer Zyklus, der sich mit früher Stabilisierung und Unterstützung direkt nach dem Cutover überschneiden kann.
Viele Entscheidungen zu Rightsizing und Tuning sind erst unter echter Last belastbar. Nach dem Cutover lassen sich Annahmen mit Daten aus dem Betrieb validieren und präzisieren.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Führen Sie dieselbe Terraform-, Helm-, Spring-Music-JAR-, PostgreSQL-Flex- und Observability-Implementierung fort, die für Bereitstellung, Probe, Cutover und Rollback genutzt wurde. Führen Sie kein zweites Beispiel ein und keine Kapazitätsexperimente im Migrationsfenster durch.
Spring Boot Kubernetes Replatform Referenz Dieselben versionierten Variablen, Deployment-Ressourcen und Dashboards wie im Migrations- und Stabilisierungsworkflow verwenden. Repository öffnenÖffnen Sie grafana_dashboard_url oder den Ordner SCF Replatform. Terraform verwaltet acht Panels.
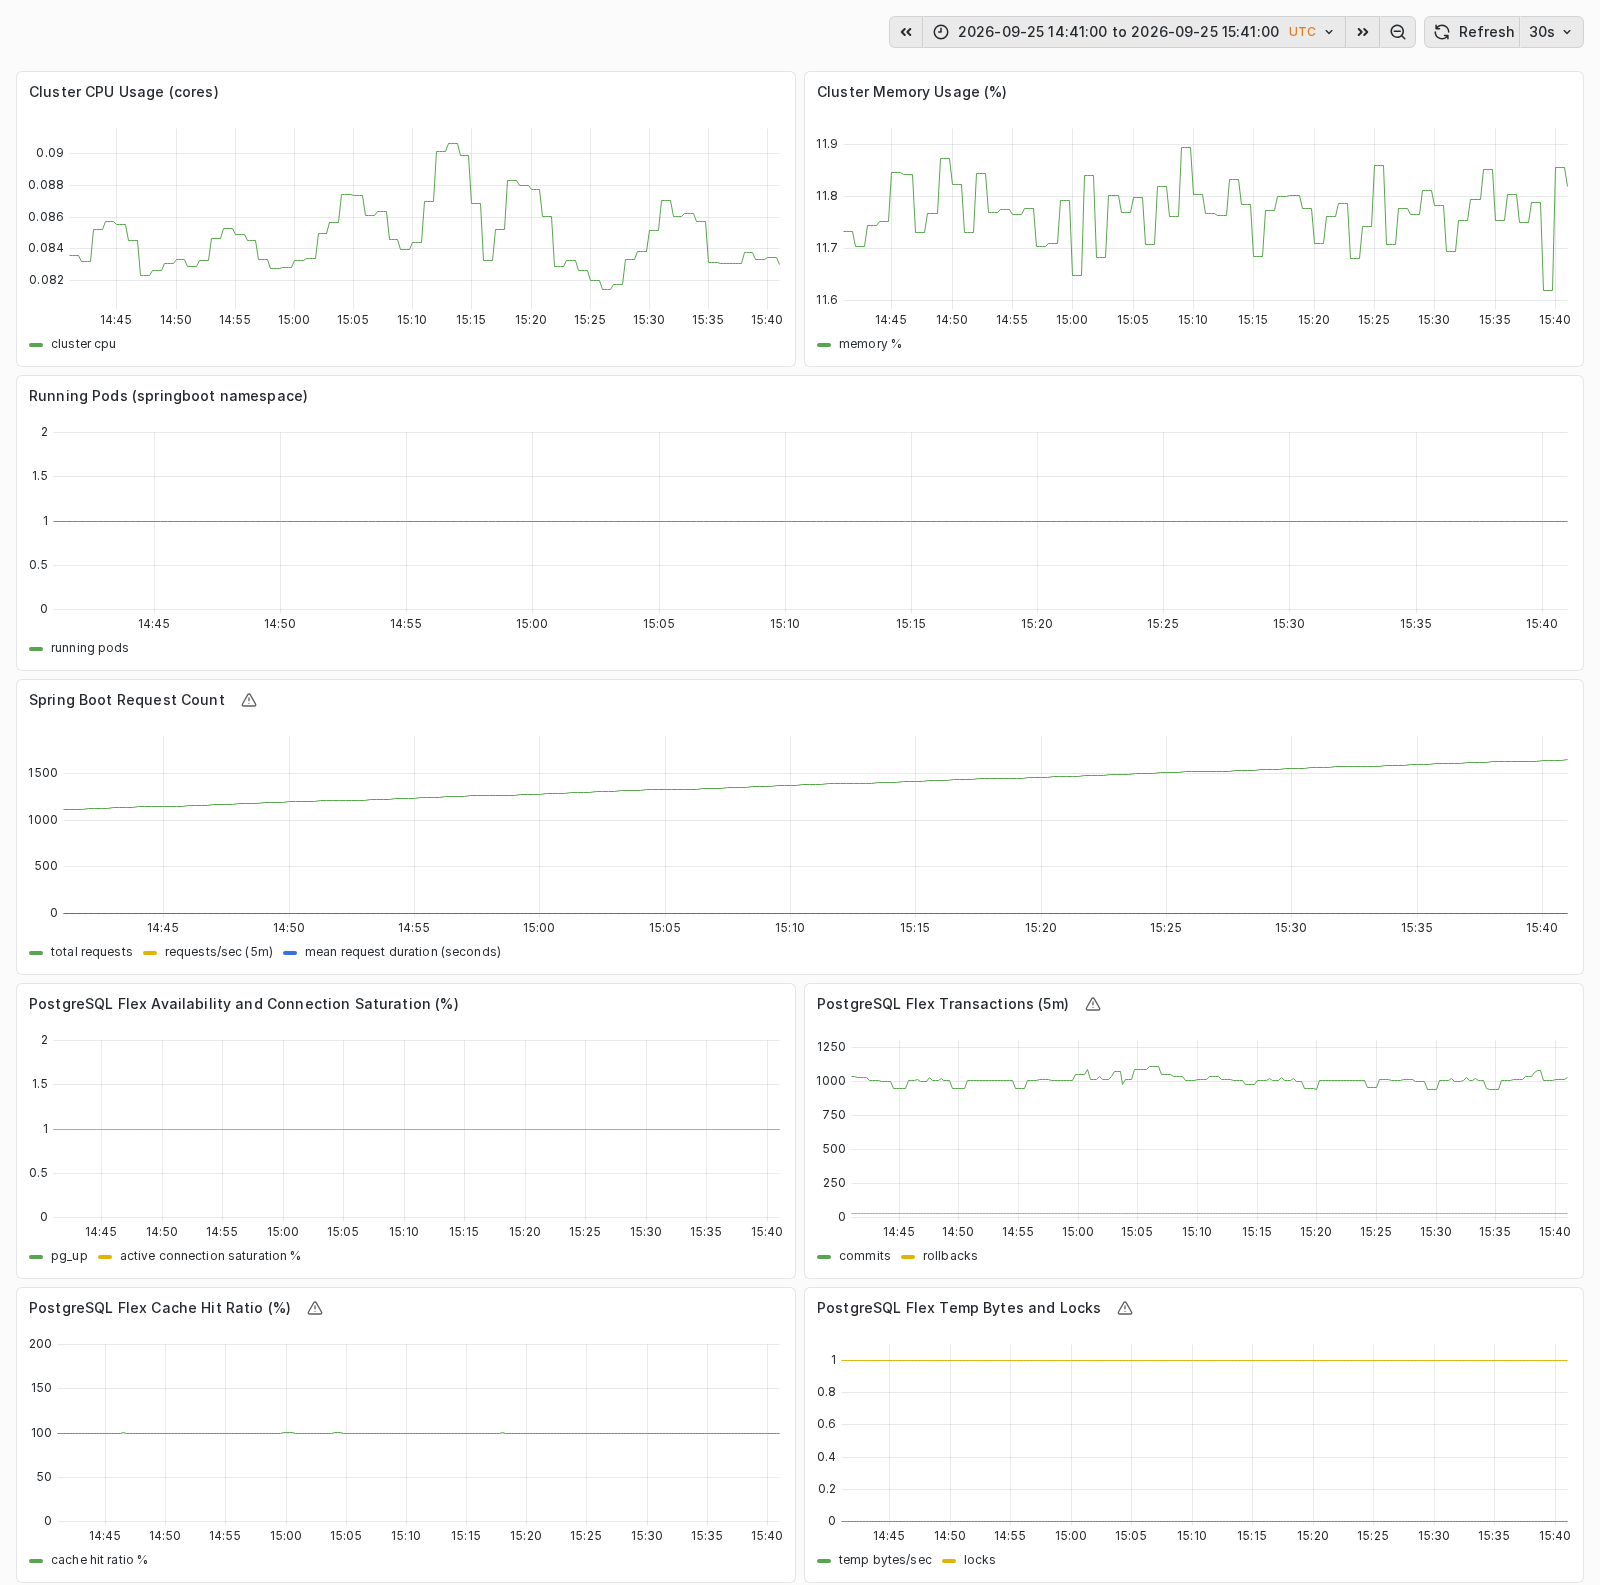
Aufnahme der Referenzbereitstellung vom 25. September 2026, 14:41 bis 15:41 UTC. Sie zeigt eine Stunde Testbetrieb mit geringer Last, keine repräsentative Basis für Produktions-Sizing. Bewerten Sie Anwendungsaktivität gemeinsam mit Datenbankverfügbarkeit und -auslastung, bevor Sie einen Optimierungskandidaten auswählen. Die folgende Tabelle erläutert die Grenzen dieser Signale.
| Panelgruppe | Unterstützte Entscheidung | Interpretationsgrenze |
|---|---|---|
| Cluster-CPU und -Speicher | Worker-Auslastung und Gesamtkapazität | Die CPU-Abfrage zeigt belegte Kerne, keinen Auslastungsprozentsatz; Cluster-Summen identifizieren keinen einzelnen Pod-Engpass |
| Laufende Pods | Vorhandensein des Workloads | Ein Scrape-Ersatzwert beweist nicht, dass alle Replikas gesund sind; Kubernetes-Rollout und Soll-Replikazahl prüfen |
| Anwendungsanfragen | Anfragerate und mittlere Dauer | Der Boot-2-Adapter liefert keine Latenzperzentile und kein vollständiges Fehlerraten-SLO |
| PostgreSQL-Verfügbarkeit und -Verbindungen | Datenbankerreichbarkeit und Verbindungsdruck | pg_up und tatsächlichen Scrape-Zustand unabhängig prüfen |
| PostgreSQL-Transaktionen | Commit- und Rollback-Trends | Veränderungen mit Anfragelast und Anwendungsverhalten korrelieren |
| PostgreSQL-Cache-Treffer | Verhalten des Lesecaches | Geringe Anfragelast und fehlende Zeitreihen begründen keinen Kapazitätsbedarf |
| Temporäre PostgreSQL-Bytes und Sperren | Untersuchung von Abfragen oder Konkurrenz | Mehr Rechenleistung behebt Abfrage- oder Sperrprobleme nicht automatisch |
Prüfen Sie vor der Interpretation echte up=1-Messwerte für beide Scrape-Jobs. Einige
Cluster-Panels enthalten Ersatzwerte; eine dargestellte Null belegt daher keinen Nullverbrauch.
Begrenzen Sie Abfragen auf den gewünschten Cluster und die Datenbank, wenn eine Datenquelle
mehrere Workloads enthält. Nutzen Sie zusätzliche Telemetrie und fachliche Tests für
Latenzperzentile, Fehler und Recovery-Ziele.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Die Referenz stellt postgres_flex_cpu, postgres_flex_ram, postgres_flex_replicas,
postgres_flex_storage_class und postgres_flex_storage_size bereit. CPU, RAM und die Auswahl
Single oder Replica bestimmen einen Flavor aus dem aktuellen Projektkatalog. Wählen Sie
eine angebotene Kombination; setzen Sie weder beliebige Werte noch einen Wechsel ohne Neuerstellung voraus.
Prüfen Sie Plan und Service-Einschränkungen vor der Freigabe. Behandeln Sie einen Datenbankaustausch als neue Migration mit verifizierter Recovery, nicht als Routine-Resize. Speicherwachstum und Service-Plan-Wechsel lassen sich möglicherweise nicht durch alte Variablenwerte zurücknehmen. Bestätigen Sie Recovery-Pfad und Wartungsfenster vor der Änderung.
Der getestete Migrations-Rollback stellt Anwendungsdaten wieder her; er macht weder Infrastruktur-Resizing rückgängig noch weist er Managed-Flex-Restore nach. Validieren Sie das erforderliche Recovery-Verfahren separat.
PostgreSQL-Flex-Flavors und Performance-Klassen Dokumentation öffnen| Beschreibung | ID | CPU | Memory | max_connections | shared_buffers | work_mem | maintenance_work_mem | effective_cache_size |
|---|---|---|---|---|---|---|---|---|
| Small, Compute optimized | 2.4 | 2 | 4 GB | 95 | 950 MB | 14 MB | 380 MB | 2660 MB |
| Small, Memory optimized | 2.16 | 2 | 16 GB | 385 | 3950 MB | 14 MB | 1580 MB | 11060 MB |
| Medium, Compute optimized | 4.8 | 4 | 8 GB | 195 | 1950 MB | 14 MB | 780 MB | 5460 MB |
| Medium, Memory optimized | 4.32 | 4 | 32 GB | 785 | 7950 MB | 14 MB | 3180 MB | 22260 MB |
| Large, Processor optimized | 8.16 | 8 | 16 GB | 385 | 3950 MB | 14 MB | 1580 MB | 11060 MB |
| X-Large, Compute optimized | 16.32 | 16 | 32 GB | 785 | 7950 MB | 14 MB | 3180 MB | 22260 MB |
| X-Large, Memory optimized | 16.128 | 16 | 128 GB | 3170 | 31950 MB | 14 MB | 12780 MB | 89460 MB |
max_connections angerechnet.Dieser Abschnitt wird mehrmals am Tag automatisch aus der STACKIT-Doku übernommen. Hier lässt er sich nicht ändern. Änderungen gehören in die STACKIT-Doku.
| Beschreibung | ID | Max. IOPS | Max. Durchsatz (MB/s) |
|---|---|---|---|
| Leistungsklasse 2 | premium-perf2-stackit | 1000 | 100 |
| Leistungsklasse 4 | premium-perf4-stackit | 2000 | 150 |
| Leistungsklasse 6 | premium-perf6-stackit | 5000 | 200 |
| Leistungsklasse 8 | premium-perf8-stackit | 10000 | 250 |
| Leistungsklasse 10 | premium-perf10-stackit | 15000 | 300 |
| Leistungsklasse 12 | premium-perf12-stackit | 20000 | 350 |
Aktuell bieten wir drei Typen von Instanzen an. Für jeden Typ ist ein anderer Satz an Flavor verfügbar.
Dieser Abschnitt wird mehrmals am Tag automatisch aus der STACKIT-Doku übernommen. Hier lässt er sich nicht ändern. Änderungen gehören in die STACKIT-Doku.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Die Referenz definiert Ressourcen im Spring-Boot-Deployment in main.tf, nicht über eigene
CPU- oder Speichervariablen. Java fordert 100m CPU und 512Mi Speicher an; die Limits liegen
bei 500m und 1Gi. JAVA_TOOL_OPTIONS setzt den initialen Heap auf 128 MiB und den maximalen
Heap auf 512 MiB. Beide Exporter-Sidecars besitzen jeweils ein eigenes Ressourcenbudget.
Vergleichen Sie tatsächlichen Working Set, Heap, Nicht-Heap-Speicher, Throttling, Startverhalten
und Sidecar-Verbrauch, bevor Sie das Deployment ändern. Lassen Sie neben dem Java-Heap Raum
für Threads und nativen Speicher. Ressourcenänderungen können Pods neu ausrollen und einen
Workload mit einer Replika unterbrechen; planen und validieren Sie entsprechend. Erfinden Sie
keine nicht unterstützten springboot_cpu- oder Speichervariablen.
Qualifizieren Sie Metriken, Replikaverantwortung, Anwendungssicherheit und Telemetrie pro Pod vor einem begrenzten HPA-Experiment.
HPA vergleicht die beobachtete Pod-CPU-Auslastung mit dem konfigurierten Ziel und passt die Replikazahl innerhalb von Mindest- und Höchstgrenzen an. Die Ressourcenmetrik setzt realistische Requests und eine verfügbare Kubernetes Metrics API voraus; erfolgreiches Grafana-Scraping beweist deren Funktion nicht. Die Ressourcenauslastung umfasst auch die Sidecar-Budgets. HPA allein kann keine Worker-Kapazität erzeugen.
Prüfen Sie vor einem Experiment mit mehreren Replikas Sitzungszustand, gemeinsame Schreibzugriffe, Initialisierung und Datenbankverbindungslimits. Das aktuelle Anwendungs-/Exporter-Scraping nutzt einen lastverteilten Service-Endpunkt; Replikas können wechselnd statt als getrennte Zeitreihen erfasst werden. Etablieren Sie Anwendungsscraping pro Pod und vermeiden Sie doppelte Datenbankaggregation, bevor Sie skalierten Anfrageraten oder Summen vertrauen. Diese Erweiterungen gehören nicht zum validierten Ein-Replika-Pfad.
Stellen Sie genügend Worker-Reserve bereit und berücksichtigen Sie Pool-Kapazität, Zonengrenzen und Rollout-Unterbrechungen.
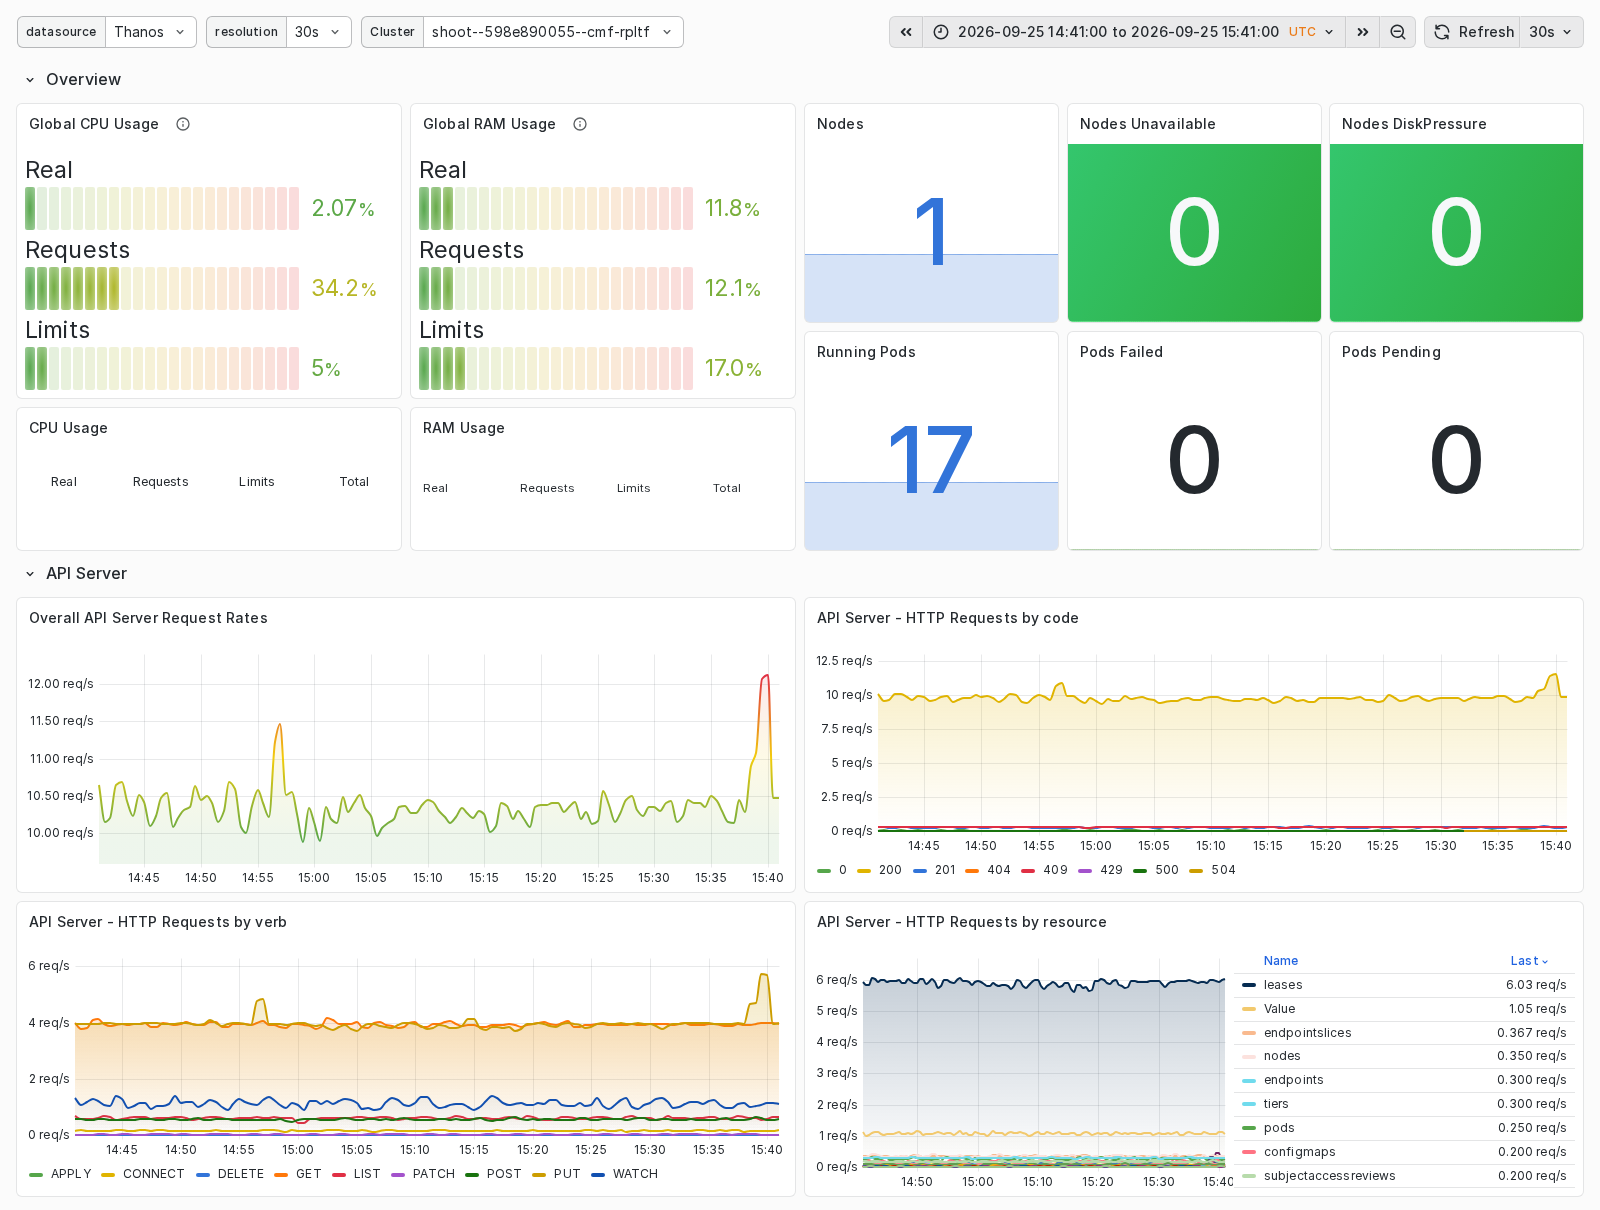
Das SKE-Dashboard zeigt dasselbe Intervall von 14:41 bis 15:41 UTC am 25. September 2026. Die tatsächliche CPU-Nutzung beträgt etwa 2 %, während CPU-Requests etwa 34 % der Cluster-Kapazität reservieren. Das verdeutlicht, warum Scheduling-Reservierungen und gemessener Verbrauch gemeinsam zu bewerten sind. Die 17 laufenden Pods umfassen Plattformkomponenten, nicht 17 Spring-Boot-Replikas; das Workload-Dashboard oben zeigt den einzelnen Anwendungspod. Keine fehlgeschlagenen oder wartenden Pods zu diesem Zeitpunkt sind ein nützliches Zustandssignal, kein Beweis für Spitzenlast- oder Ausfalltoleranz.
Passen Sie node_pool_minimum, node_pool_maximum und node_pool_machine_type anhand
aggregierter Requests, beobachteter Nachfrage, System-Overhead und Rollout-Reserve an.
Gleiche Mindest- und Höchstwerte fixieren die Pool-Größe; ein höheres HPA-Maximum kann diese
Kapazitätsgrenze nicht überwinden.
Die Referenz konfiguriert einen Node Pool. Weitere Pools und Zonenplatzierung erfordern eine explizite Architekturerweiterung. Die Availability Zone eines Node Pools kann nicht ohne Neuerstellung geändert werden; eine andere Zone benötigt einen neuen Pool-Namen und einen geprüften Migrationsplan. Prüfen Sie tatsächliche SKE-Kapazität und geplanten Worker-Austausch vor einer Flavor- oder Topologieänderung.
SKE Node Pools verwalten Dokumentation öffnenDer implementierte Einstiegspunkt ist Envoy Gateway mit HTTPRoutes, kein älterer Ingress. Vergleichen Sie Gateway- und Service-Verhalten mit Anwendungs- und Datenbanklatenz vor einer Worker-Größenänderung. Der optionale clusterinterne Lastgenerator umgeht öffentliches Gateway, DNS und TLS; ergänzen Sie einen freigegebenen externen End-to-End-Test. Dieses Asset behauptet keine gemessene öffentliche Durchsatzgrenze.
Spring Music speichert seine maßgeblichen Daten in Flex. In dieser Basis gibt es kein
Anwendungs-PersistentVolume für Rightsizing. node_pool_volume_size betrifft Worker-Speicher,
nicht Datenbankkapazität. Nutzen Sie die Flex-Speichereinstellungen für Albumdaten und bewerten
Sie Wachstum, Abfrage-I/O, Aufbewahrung und Recovery gemeinsam. Ergänzen Sie Kubernetes-Speicher
nur für einen separat entworfenen Persistenzbedarf.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Testen Sie begrenztes HPA erst nach Abschluss von Migration und Rollback-Arbeiten in einem separat freigegebenen Experiment. Diese beispielhaften Grenzen sind keine Sizing-Empfehlungen für die Produktion:
enable_springboot_hpa = truespringboot_hpa_min_replicas = 1springboot_hpa_max_replicas = 3springboot_hpa_target_cpu_utilization_percentage = 70Das Deployment definiert außerdem springboot_replicas in Terraform. Prüfen Sie spätere Pläne
auf konkurrierende Replikaänderungen und legen Sie vor unbeaufsichtigtem HPA-Betrieb eine
explizite Zuständigkeit fest. Das Migrationsskript lehnt HPA-verwaltete Ziele ab; deaktivieren
Sie HPA vor jeder späteren Migration und jedem Rollback.
Prüfen Sie den Plan und beobachten Sie anschließend HPA mit der konfigurierten Kubeconfig:
terraform plan -var-file=env.tfvars -out=tfplan.optimizeterraform apply tfplan.optimizekubectl get hpa,pods -n springbootkubectl describe hpa springboot -n springbootkubectl top pods -n springboot --containersSTACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Stellen Sie bei reversiblen Konfigurationsänderungen die zuvor geprüften Werte wieder her und prüfen Sie vor dem Apply einen neuen Plan. Setzen Sie nicht voraus, dass eine kleinere Datenbank oder die Rückkehr zur alten Speicherklasse unterstützt wird. War HPA das Experiment, deaktivieren Sie es und stellen Sie die gewünschte Replikazahl über die geprüfte Konfiguration wieder her; bestätigen Sie danach ein stabiles Deployment.
Dokumentieren Sie Vorher-/Nachher-Nachweise, Konfigurationsstand, fachliche Ergebnisse und Kostenwirkung. Ein Datenbank-Migrations-Rollback ersetzt nicht die Rücknahme einer Optimierungsänderung.