Replatform Spring Boot auf Kubernetes mit Rightsizing und Pod-Skalierung optimieren
In 2 TrailsZuletzt aktualisiert am
Szenario
Abschnitt betitelt „Szenario“Wählen Sie nach Migrationsabnahme und Stabilisierung anhand des gemessenen Workload-Verhaltens jeweils eine Optimierung. Dieses Asset behandelt Pod-Ressourcen, Worker-Kapazität, optionales HPA und PostgreSQL Flex. Es behauptet nicht, dass diese Änderungen im Migrationstest erprobt wurden.
Referenzimplementierung fortführen
Abschnitt betitelt „Referenzimplementierung fortführen“Führen Sie dieselbe Terraform-, Helm-, Spring-Music-JAR-, PostgreSQL-Flex- und Observability-Implementierung fort, die für Bereitstellung, Probe, Cutover und Rollback genutzt wurde. Führen Sie kein zweites Beispiel ein und keine Kapazitätsexperimente im Migrationsfenster durch.
Spring Boot Kubernetes Replatform Referenz Dieselben versionierten Variablen, Deployment-Ressourcen und Dashboards wie im Migrations- und Stabilisierungsworkflow verwenden. Repository öffnenObservability-Dashboard für Entscheidungen
Abschnitt betitelt „Observability-Dashboard für Entscheidungen“Öffnen Sie grafana_dashboard_url oder den Ordner SCF Replatform. Terraform verwaltet acht Panels.
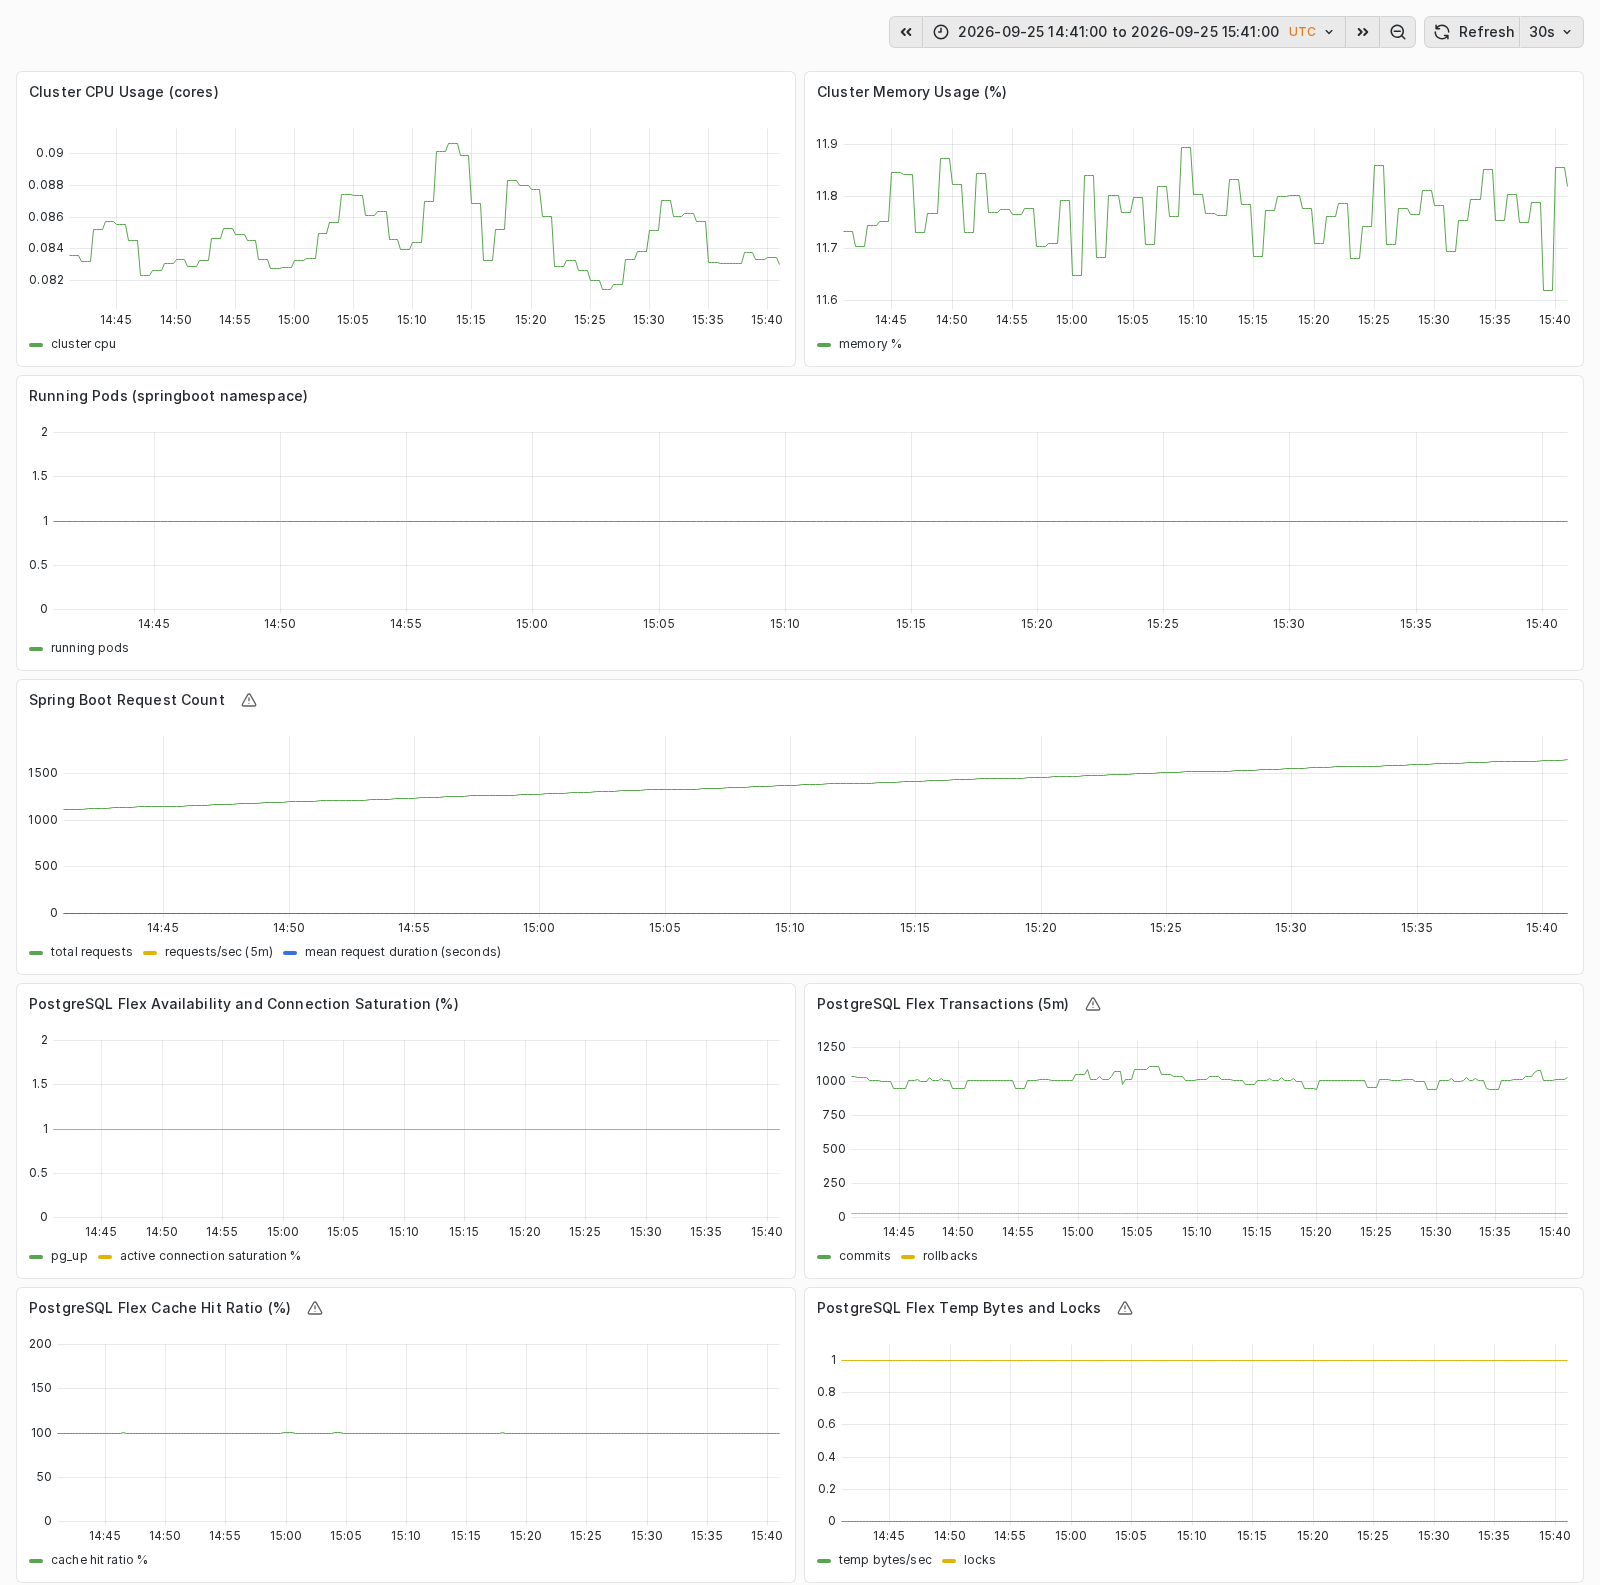
Aufnahme der Referenzbereitstellung vom 25. September 2026, 14:41 bis 15:41 UTC. Sie zeigt eine Stunde Testbetrieb mit geringer Last, keine repräsentative Basis für Produktions-Sizing. Bewerten Sie Anwendungsaktivität gemeinsam mit Datenbankverfügbarkeit und -auslastung, bevor Sie einen Optimierungskandidaten auswählen. Die folgende Tabelle erläutert die Grenzen dieser Signale.
| Panelgruppe | Unterstützte Entscheidung | Interpretationsgrenze |
|---|---|---|
| Cluster-CPU und -Speicher | Worker-Auslastung und Gesamtkapazität | Die CPU-Abfrage zeigt belegte Kerne, keinen Auslastungsprozentsatz; Cluster-Summen identifizieren keinen einzelnen Pod-Engpass |
| Laufende Pods | Vorhandensein des Workloads | Ein Scrape-Ersatzwert beweist nicht, dass alle Replikas gesund sind; Kubernetes-Rollout und Soll-Replikazahl prüfen |
| Anwendungsanfragen | Anfragerate und mittlere Dauer | Der Boot-2-Adapter liefert keine Latenzperzentile und kein vollständiges Fehlerraten-SLO |
| PostgreSQL-Verfügbarkeit und -Verbindungen | Datenbankerreichbarkeit und Verbindungsdruck | pg_up und tatsächlichen Scrape-Zustand unabhängig prüfen |
| PostgreSQL-Transaktionen | Commit- und Rollback-Trends | Veränderungen mit Anfragelast und Anwendungsverhalten korrelieren |
| PostgreSQL-Cache-Treffer | Verhalten des Lesecaches | Geringe Anfragelast und fehlende Zeitreihen begründen keinen Kapazitätsbedarf |
| Temporäre PostgreSQL-Bytes und Sperren | Untersuchung von Abfragen oder Konkurrenz | Mehr Rechenleistung behebt Abfrage- oder Sperrprobleme nicht automatisch |
Prüfen Sie vor der Interpretation echte up=1-Messwerte für beide Scrape-Jobs. Einige
Cluster-Panels enthalten Ersatzwerte; eine dargestellte Null belegt daher keinen Nullverbrauch.
Begrenzen Sie Abfragen auf den gewünschten Cluster und die Datenbank, wenn eine Datenquelle
mehrere Workloads enthält. Nutzen Sie zusätzliche Telemetrie und fachliche Tests für
Latenzperzentile, Fehler und Recovery-Ziele.
Optimierungssignale und Leitplanken
Abschnitt betitelt „Optimierungssignale und Leitplanken“Erfassen Sie eine repräsentative Baseline einschließlich Spitzenzeiten, geplanter Arbeit, JVM-Aufwärmphase und Datenbankwartung. Vereinbaren Sie Beobachtungsfenster, fachliche SLOs, Kapazitätsreserve und Kostenziel vor der Änderung. Vierzehn Tage können ein Ausgangspunkt für die Beobachtung sein, sind aber keine feste Regel.
- Pod-Ressourcenkandidat: Throttling, Neustarts, Heap- oder Working-Set-Druck sind auf Anwendung oder Sidecar begrenzt.
- Worker-Kapazitätskandidat: Pods warten auf Scheduling, zuweisbare Ressourcen fehlen oder die Rollout-Reserve im Pool reicht nicht aus.
- Datenbankkandidat: Verbindungs-, Transaktions-, Sperr-, Speicher- oder Abfragedruck korreliert mit fachlicher Latenz.
- Scale-in-Kandidat: Dauerhafte Reserven nach Berücksichtigung von Spitzen, Rollout und Recovery, ohne ungelöste kritische Incidents.
Bewahren Sie Baseline, vorherige Konfiguration, Rollback-Plan und Entscheidungsschwellen auf. Fehlende Metriken, fehlgeschlagene Alarmzustellung oder ausschließlich synthetischer Traffic reichen als Nachweis für eine produktive Verkleinerung nicht aus.
Metriken aus PostgreSQL Flex für Optimize
Abschnitt betitelt „Metriken aus PostgreSQL Flex für Optimize“Bewerten Sie Datenbank- und Anwendungssignale gemeinsam. Mehr Pods erhöhen den Verbindungsbedarf und können den Engpass zu Flex verlagern. Trennen Sie Connection-Pool-Grenzen, teure Abfragen, Sperrkonflikte und Speicherdruck von tatsächlichen CPU- oder RAM-Engpässen.
Nutzen Sie die Anleitung zum PostgreSQL-Flex-Monitoring , um Service-Metriken zusammen mit dem Anwendungsverhalten zu interpretieren.
PostgreSQL Flex für Rightsizing und Tuning
Abschnitt betitelt „PostgreSQL Flex für Rightsizing und Tuning“Die Referenz stellt postgres_flex_cpu, postgres_flex_ram, postgres_flex_replicas,
postgres_flex_storage_class und postgres_flex_storage_size bereit. CPU, RAM und die Auswahl
Single oder Replica bestimmen einen Flavor aus dem aktuellen Projektkatalog. Wählen Sie
eine angebotene Kombination; setzen Sie weder beliebige Werte noch einen Wechsel ohne Neuerstellung voraus.
Prüfen Sie Plan und Service-Einschränkungen vor der Freigabe. Behandeln Sie einen Datenbankaustausch als neue Migration mit verifizierter Recovery, nicht als Routine-Resize. Speicherwachstum und Service-Plan-Wechsel lassen sich möglicherweise nicht durch alte Variablenwerte zurücknehmen. Bestätigen Sie Recovery-Pfad und Wartungsfenster vor der Änderung.
Der getestete Migrations-Rollback stellt Anwendungsdaten wieder her; er macht weder Infrastruktur-Resizing rückgängig noch weist er Managed-Flex-Restore nach. Validieren Sie das erforderliche Recovery-Verfahren separat.
PostgreSQL-Flex-Flavors und Performance-Klassen Dokumentation öffnen| Beschreibung | ID | CPU | Memory | max_connections | shared_buffers | work_mem | maintenance_work_mem | effective_cache_size |
|---|---|---|---|---|---|---|---|---|
| Small, Compute optimized | 2.4 | 2 | 4 GB | 95 | 950 MB | 14 MB | 380 MB | 2660 MB |
| Small, Memory optimized | 2.16 | 2 | 16 GB | 385 | 3950 MB | 14 MB | 1580 MB | 11060 MB |
| Medium, Compute optimized | 4.8 | 4 | 8 GB | 195 | 1950 MB | 14 MB | 780 MB | 5460 MB |
| Medium, Memory optimized | 4.32 | 4 | 32 GB | 785 | 7950 MB | 14 MB | 3180 MB | 22260 MB |
| Large, Processor optimized | 8.16 | 8 | 16 GB | 385 | 3950 MB | 14 MB | 1580 MB | 11060 MB |
| X-Large, Compute optimized | 16.32 | 16 | 32 GB | 785 | 7950 MB | 14 MB | 3180 MB | 22260 MB |
| X-Large, Memory optimized | 16.128 | 16 | 128 GB | 3170 | 31950 MB | 14 MB | 12780 MB | 89460 MB |
Hinweise
- CPU und Arbeitsspeicher gelten immer pro Knoten.
- Das System nutzt bis zu 15 Verbindungen für interne essenzielle Prozesse wie Backup, Monitoring usw. Diese Verbindungen werden auf das Limit von
max_connectionsangerechnet.
Was ist das?
Dieser Abschnitt wird mehrmals am Tag automatisch aus der STACKIT-Doku übernommen. Hier lässt er sich nicht ändern. Änderungen gehören in die STACKIT-Doku.
| Beschreibung | ID | Max. IOPS | Max. Durchsatz (MB/s) |
|---|---|---|---|
| Leistungsklasse 2 | premium-perf2-stackit | 1000 | 100 |
| Leistungsklasse 4 | premium-perf4-stackit | 2000 | 150 |
| Leistungsklasse 6 | premium-perf6-stackit | 5000 | 200 |
| Leistungsklasse 8 | premium-perf8-stackit | 10000 | 250 |
| Leistungsklasse 10 | premium-perf10-stackit | 15000 | 300 |
| Leistungsklasse 12 | premium-perf12-stackit | 20000 | 350 |
Aktuell bieten wir drei Typen von Instanzen an. Für jeden Typ ist ein anderer Satz an Flavor verfügbar.
Was ist das?
Dieser Abschnitt wird mehrmals am Tag automatisch aus der STACKIT-Doku übernommen. Hier lässt er sich nicht ändern. Änderungen gehören in die STACKIT-Doku.
Pod-Ressourcen und JVM-Budget
Abschnitt betitelt „Pod-Ressourcen und JVM-Budget“Die Referenz definiert Ressourcen im Spring-Boot-Deployment in main.tf, nicht über eigene
CPU- oder Speichervariablen. Java fordert 100m CPU und 512Mi Speicher an; die Limits liegen
bei 500m und 1Gi. JAVA_TOOL_OPTIONS setzt den initialen Heap auf 128 MiB und den maximalen
Heap auf 512 MiB. Beide Exporter-Sidecars besitzen jeweils ein eigenes Ressourcenbudget.
Vergleichen Sie tatsächlichen Working Set, Heap, Nicht-Heap-Speicher, Throttling, Startverhalten
und Sidecar-Verbrauch, bevor Sie das Deployment ändern. Lassen Sie neben dem Java-Heap Raum
für Threads und nativen Speicher. Ressourcenänderungen können Pods neu ausrollen und einen
Workload mit einer Replika unterbrechen; planen und validieren Sie entsprechend. Erfinden Sie
keine nicht unterstützten springboot_cpu- oder Speichervariablen.
Regelkreis für Pod-Autoscaling
Abschnitt betitelt „Regelkreis für Pod-Autoscaling“Qualifizieren Sie Metriken, Replikaverantwortung, Anwendungssicherheit und Telemetrie pro Pod vor einem begrenzten HPA-Experiment.
HPA vergleicht die beobachtete Pod-CPU-Auslastung mit dem konfigurierten Ziel und passt die Replikazahl innerhalb von Mindest- und Höchstgrenzen an. Die Ressourcenmetrik setzt realistische Requests und eine verfügbare Kubernetes Metrics API voraus; erfolgreiches Grafana-Scraping beweist deren Funktion nicht. Die Ressourcenauslastung umfasst auch die Sidecar-Budgets. HPA allein kann keine Worker-Kapazität erzeugen.
Prüfen Sie vor einem Experiment mit mehreren Replikas Sitzungszustand, gemeinsame Schreibzugriffe, Initialisierung und Datenbankverbindungslimits. Das aktuelle Anwendungs-/Exporter-Scraping nutzt einen lastverteilten Service-Endpunkt; Replikas können wechselnd statt als getrennte Zeitreihen erfasst werden. Etablieren Sie Anwendungsscraping pro Pod und vermeiden Sie doppelte Datenbankaggregation, bevor Sie skalierten Anfrageraten oder Summen vertrauen. Diese Erweiterungen gehören nicht zum validierten Ein-Replika-Pfad.
Konfiguration für Pod-Autoscaling
Abschnitt betitelt „Konfiguration für Pod-Autoscaling“Testen Sie begrenztes HPA erst nach Abschluss von Migration und Rollback-Arbeiten in einem separat freigegebenen Experiment. Diese beispielhaften Grenzen sind keine Sizing-Empfehlungen für die Produktion:
enable_springboot_hpa = truespringboot_hpa_min_replicas = 1springboot_hpa_max_replicas = 3springboot_hpa_target_cpu_utilization_percentage = 70Das Deployment definiert außerdem springboot_replicas in Terraform. Prüfen Sie spätere Pläne
auf konkurrierende Replikaänderungen und legen Sie vor unbeaufsichtigtem HPA-Betrieb eine
explizite Zuständigkeit fest. Das Migrationsskript lehnt HPA-verwaltete Ziele ab; deaktivieren
Sie HPA vor jeder späteren Migration und jedem Rollback.
Prüfen Sie den Plan und beobachten Sie anschließend HPA mit der konfigurierten Kubeconfig:
terraform plan -var-file=env.tfvars -out=tfplan.optimizeterraform apply tfplan.optimizekubectl get hpa,pods -n springbootkubectl describe hpa springboot -n springbootkubectl top pods -n springboot --containersCluster- und Plattform-Rightsizing
Abschnitt betitelt „Cluster- und Plattform-Rightsizing“Stellen Sie genügend Worker-Reserve bereit und berücksichtigen Sie Pool-Kapazität, Zonengrenzen und Rollout-Unterbrechungen.
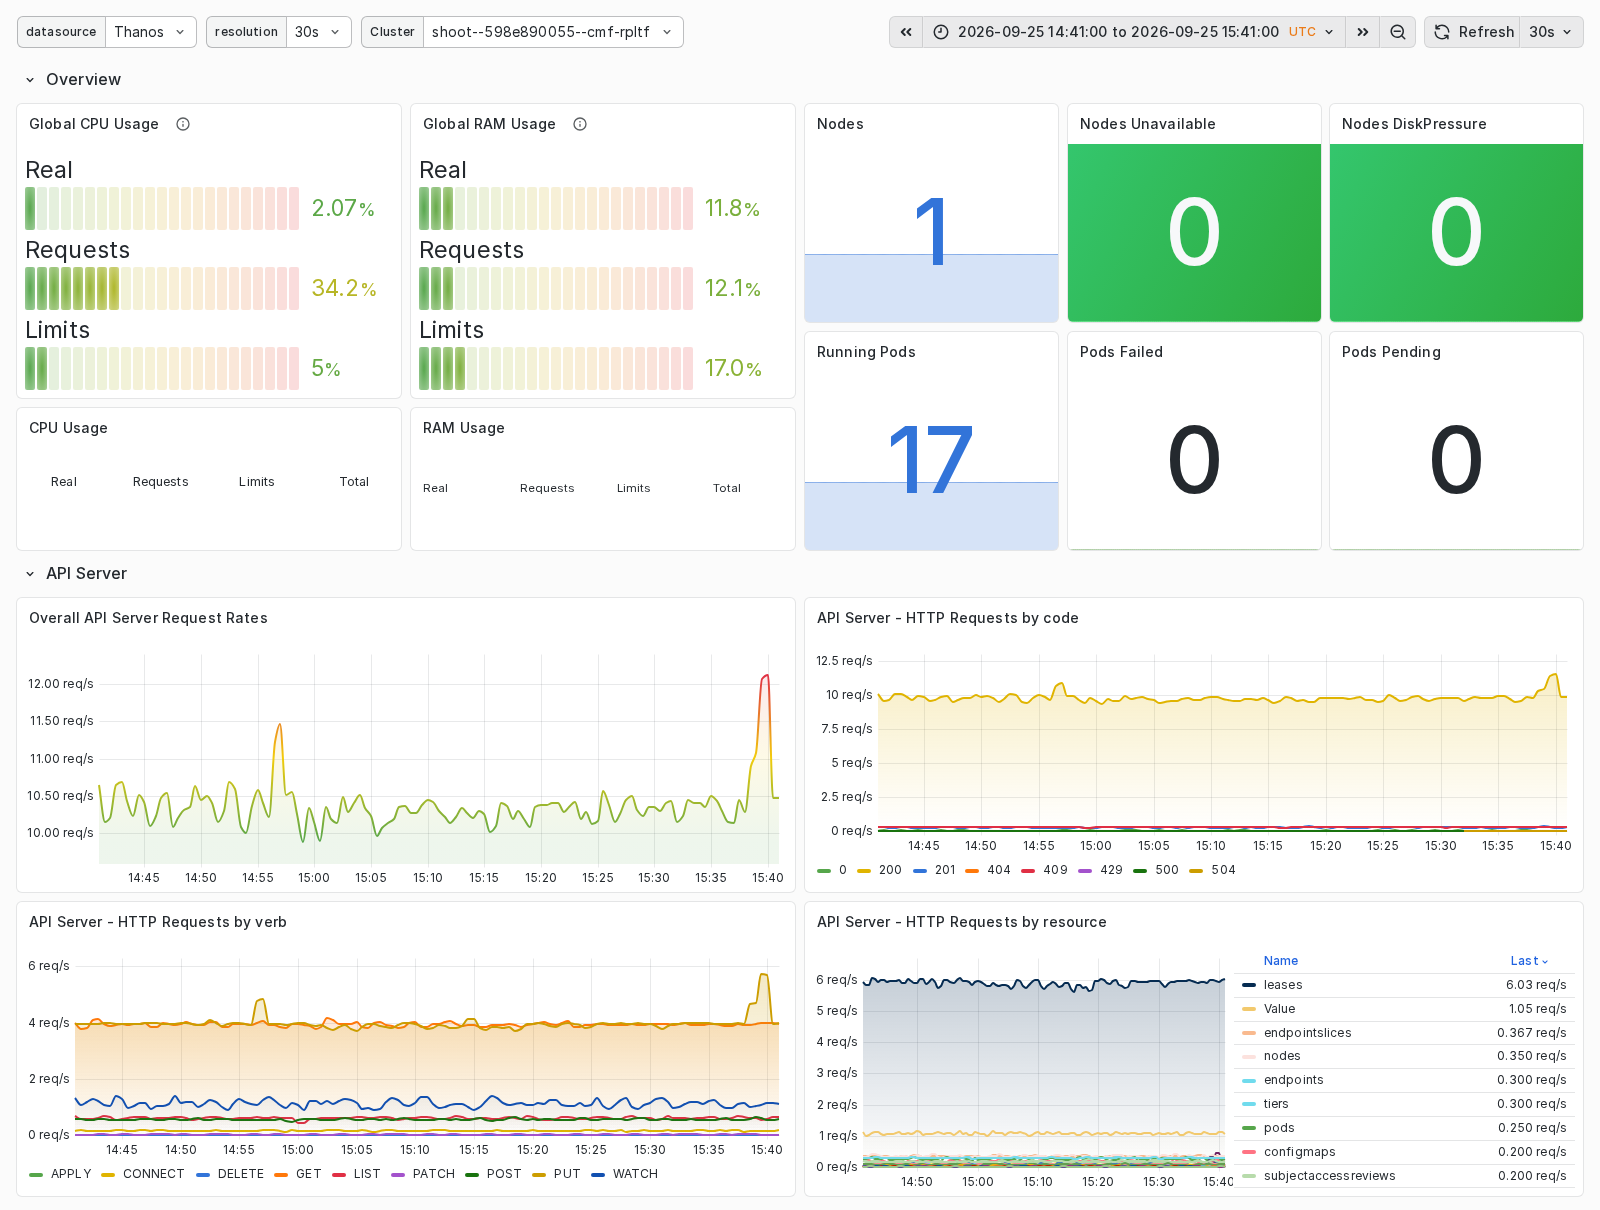
Das SKE-Dashboard zeigt dasselbe Intervall von 14:41 bis 15:41 UTC am 25. September 2026. Die tatsächliche CPU-Nutzung beträgt etwa 2 %, während CPU-Requests etwa 34 % der Cluster-Kapazität reservieren. Das verdeutlicht, warum Scheduling-Reservierungen und gemessener Verbrauch gemeinsam zu bewerten sind. Die 17 laufenden Pods umfassen Plattformkomponenten, nicht 17 Spring-Boot-Replikas; das Workload-Dashboard oben zeigt den einzelnen Anwendungspod. Keine fehlgeschlagenen oder wartenden Pods zu diesem Zeitpunkt sind ein nützliches Zustandssignal, kein Beweis für Spitzenlast- oder Ausfalltoleranz.
Passen Sie node_pool_minimum, node_pool_maximum und node_pool_machine_type anhand
aggregierter Requests, beobachteter Nachfrage, System-Overhead und Rollout-Reserve an.
Gleiche Mindest- und Höchstwerte fixieren die Pool-Größe; ein höheres HPA-Maximum kann diese
Kapazitätsgrenze nicht überwinden.
Die Referenz konfiguriert einen Node Pool. Weitere Pools und Zonenplatzierung erfordern eine explizite Architekturerweiterung. Die Availability Zone eines Node Pools kann nicht ohne Neuerstellung geändert werden; eine andere Zone benötigt einen neuen Pool-Namen und einen geprüften Migrationsplan. Prüfen Sie tatsächliche SKE-Kapazität und geplanten Worker-Austausch vor einer Flavor- oder Topologieänderung.
SKE Node Pools verwalten Dokumentation öffnenIngress-Ebene (Durchsatz)
Abschnitt betitelt „Ingress-Ebene (Durchsatz)“Der implementierte Einstiegspunkt ist Envoy Gateway mit HTTPRoutes, kein älterer Ingress. Vergleichen Sie Gateway- und Service-Verhalten mit Anwendungs- und Datenbanklatenz vor einer Worker-Größenänderung. Der optionale clusterinterne Lastgenerator umgeht öffentliches Gateway, DNS und TLS; ergänzen Sie einen freigegebenen externen End-to-End-Test. Dieses Asset behauptet keine gemessene öffentliche Durchsatzgrenze.
Storage-Ebene (Performance persistenter Volumes)
Abschnitt betitelt „Storage-Ebene (Performance persistenter Volumes)“Spring Music speichert seine maßgeblichen Daten in Flex. In dieser Basis gibt es kein
Anwendungs-PersistentVolume für Rightsizing. node_pool_volume_size betrifft Worker-Speicher,
nicht Datenbankkapazität. Nutzen Sie die Flex-Speichereinstellungen für Albumdaten und bewerten
Sie Wachstum, Abfrage-I/O, Aufbewahrung und Recovery gemeinsam. Ergänzen Sie Kubernetes-Speicher
nur für einen separat entworfenen Persistenzbedarf.
Optimize-Workflow für Replatform-Workloads
Abschnitt betitelt „Optimize-Workflow für Replatform-Workloads“- Repräsentative Metriken, fachliche Abnahmegrenzen, aktuelle Konfiguration und Kosten erfassen.
- Eine Hypothese auswählen: Pod-Budget, Worker-Kapazität, Gateway oder Datenbankdruck.
- Erwartete Verbesserung und Rollback-Schwelle festlegen; erforderliche Backups und Recovery prüfen.
- Einen gespeicherten Terraform-Plan prüfen, fachfremde Änderungen ablehnen und im freigegebenen Fenster anwenden.
- Rollout, Gateway, Albumdaten, tatsächliche Scrapes, Latenz, Fehler, Kapazität und Kosten gegen die Baseline validieren.
- Die Änderung nur beibehalten, wenn das vereinbarte Beobachtungsfenster die Abnahme erfüllt; andernfalls dem vorab freigegebenen Rücknahme- oder Recovery-Verfahren folgen.
Rollback und Abnahme
Abschnitt betitelt „Rollback und Abnahme“Stellen Sie bei reversiblen Konfigurationsänderungen die zuvor geprüften Werte wieder her und prüfen Sie vor dem Apply einen neuen Plan. Setzen Sie nicht voraus, dass eine kleinere Datenbank oder die Rückkehr zur alten Speicherklasse unterstützt wird. War HPA das Experiment, deaktivieren Sie es und stellen Sie die gewünschte Replikazahl über die geprüfte Konfiguration wieder her; bestätigen Sie danach ein stabiles Deployment.
Dokumentieren Sie Vorher-/Nachher-Nachweise, Konfigurationsstand, fachliche Ergebnisse und Kostenwirkung. Ein Datenbank-Migrations-Rollback ersetzt nicht die Rücknahme einer Optimierungsänderung.
Hinweise
Abschnitt betitelt „Hinweise“Der Live-Referenztest bestätigte den Workload mit einer Replika, Datenmigration und Rollback sowie den Dashboard-/Scrape-Pfad. Er wies weder Autoscaling-Verhalten noch optimales Sizing, Produktionslastkapazität oder Hochverfügbarkeit nach. Erheben Sie für jede dieser Entscheidungen neue Nachweise.
Kubernetes Horizontal Pod Autoscaler Regelkreis, Metrikvoraussetzungen und Skalierungsgrenzen der Kubernetes-Referenz vor der Aktivierung von Autoscaling prüfen. Externe Seite öffnen Führt von der Route weg