Blueprint
Spring Boot auf SKE mit PostgreSQL Flex und Gateway API
STACKIT
Zuletzt aktualisiert am


Planen Sie den Plattformwechsel von Spring Boot zu SKE und PostgreSQL Flex: Discovery, Architektur, Landing Zone, Migrationsfreigaben, Übergabe und Optimierung.
Ordnen Sie den Plattformwechsel in das vollständige Migration Framework ein: Workload bewerten, SKE und PostgreSQL Flex entwerfen, Landing Zone vorbereiten, mit expliziten Datenfreigaben migrieren und vor der Optimierung stabilisieren. Das Anwendungs-JAR bleibt gleich; die Betriebsmodelle für Laufzeit und Datenbank ändern sich.
Erstellen Sie eine erste Workload-Baseline für Spring-Boot-VM, PostgreSQL-Daten, Abhängigkeiten und Kapazität. Qualifizieren Sie die Migrationsabsicht und identifizieren Sie die Unbekannten, die eine detaillierte Discovery vor der Plattformentscheidung klären muss.
Rapid Discovery liefert in kurzer Zeit eine schnelle, automatisierte Ausgangsbasis über bestehende Umgebungen in On-Premises- und Cloud-Landschaften. Der Fokus liegt auf der quantitativen Erfassung des IT-Portfolios, damit frühe Migrations- und kommerzielle Entscheidungen fundiert getroffen werden können.
In dieser Phase sind Mengen und Verteilung wichtiger als die detaillierten Abhängigkeiten einzelner Anwendungen.
Bestätigen Sie Java- und PostgreSQL-Kompatibilität, Zustandshaltung, geplante Schreibzugriffe, Schemaabhängigkeiten, Datenmenge und Änderungsrate, Ausfallzeittoleranz, Recovery-Ziele und repräsentativen Bedarf. Validieren Sie diese Eingaben mit den Anwendungs- und Datenbankverantwortlichen vor der Zielauswahl.
Discovery ist eines der ersten und wichtigsten Module in der Phase Design and Mobilize. Es verfeinert die Ergebnisse aus Rapid Discovery und liefert die notwendige Tiefe, um Entscheidungen zur Architektur und die Reihenfolge der Migration belastbar zu planen.
Das primäre Ziel ist ein realistisches, auf Fakten gestütztes Verständnis der bestehenden IT-Landschaft, der Business-Prioritäten und der organisatorischen Bereitschaft, bevor Zielbild und Migrationsplan im Detail festgelegt werden.
Bestätigen Sie die zwei bewussten Ersetzungen: Aus einem VM-Service wird ein Kubernetes-Deployment, aus VM-lokalem PostgreSQL wird PostgreSQL Flex. Behalten Sie Spring-Music-JAR und fachliches Verhalten bei; dies ist Replatform, kein VM-Rehost oder Anwendungs-Refactor.
Replatform behält das Kernverhalten der Anwendung bei, ändert aber ausgewählte Plattform-Komponenten, um betriebliche oder wirtschaftliche Vorteile zu erreichen. Der Ansatz liegt zwischen Rehost und Refactor.
Nutzen Sie versioniertes Terraform für Infrastruktur und Kubernetes-Ressourcen, Helm für Envoy Gateway und Routen sowie ein separates freigegebenes Skript für die Datenmigration. Halten Sie Bereitstellung und Datenaustausch unabhängig prüfbar; dieses Ziel benötigt keine Ansible-Hostkonfiguration.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Entwerfen Sie den Datenbankumzug unabhängig von der Laufzeitbereitstellung. Definieren Sie Quellschreibstopp, konsistenten Dump mit Manifest, isolierte Probe, nachgewiesenes Zielbackup, transaktionalen Restore und Rollback-Deadline. Traffic-Umschaltung und Quell-Failback bleiben explizite Betreiberentscheidungen.
Für zustandsbehaftete Workloads müssen Verantwortlichkeiten in Quelle und Ziel der Datenplattform vor dem Runtime-Cutover eindeutig festgelegt werden.
Etablieren Sie Governance, Identität, Sicherheit, Netzwerk, Kostenkontrollen und Automatisierung, bevor das Ziel davon abhängt. Bestätigen Sie Projektberechtigungen, Betreiberzugriff, DNS-Delegation, SKE-Kapazität, Datenbankzugriffsgrenzen und geschützten Terraform-State.
Eine Landing Zone ist die strukturierte Cloud-Grundlage, die festlegt, wie Ihre Organisation auf STACKIT von Anfang an betrieben wird. Sie verbindet Governance, Identität, Security, Netzwerkarchitektur, Kostensteuerung und Automatisierung zu einem belastbaren Rahmen.
Ohne diese Grundlage stocken Migrationswellen typischerweise durch fehlende Freigaben, inkonsistente Kontrollen und wiederkehrende Plattformentscheidungen.
Nutzen Sie bei Bedarf den Landing Zone Accelerator für die gesteuerte Projekt- und Plattformbasis. Halten Sie Verantwortlichkeiten getrennt: Das Anwendungsteam verantwortet SKE-Workload, Datenmigration, Gateway, Telemetrie und Workload-Recovery.
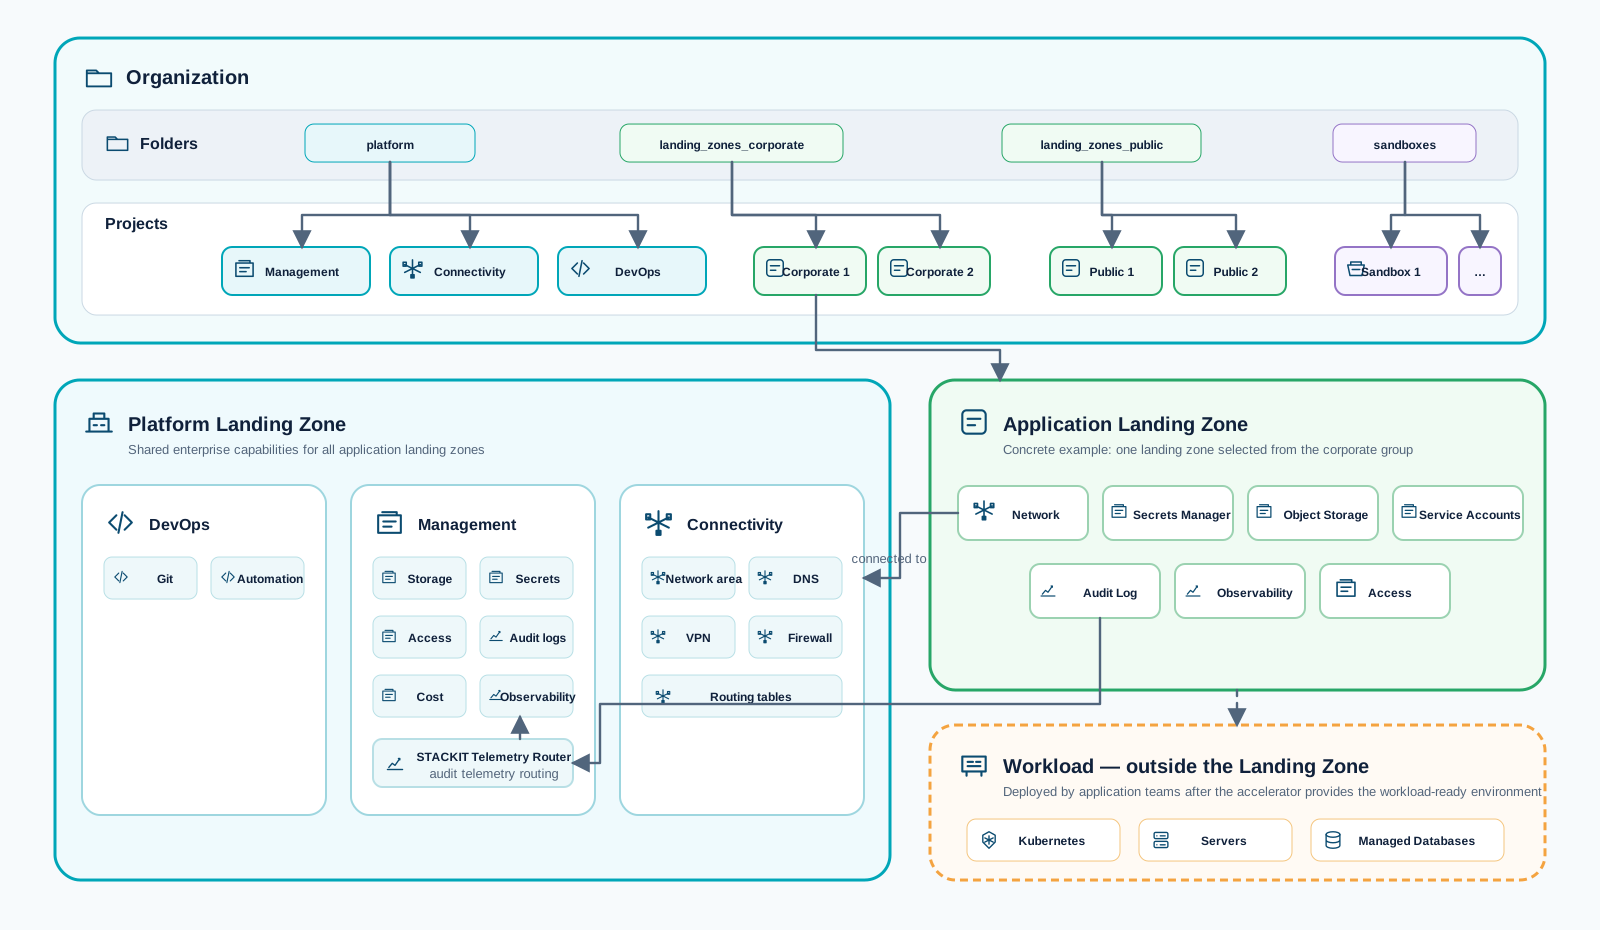
Starten Sie die Migrationswelle mit freigegebenem Zieldesign, bereiter Application Landing Zone, getestetem Runbook und benannten Entscheidungsverantwortlichen. Führen Sie Bereitschaft, Migration, Cutover, Validierung, Stabilisierung und Übergabe als einen kontrollierten Ablauf aus.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Diese Freigabepunkte erläutern das Kontrollmodell. Die folgenden Abschnitte liefern das ausführbare Verfahren und die Nachweisanforderungen für den technischen Walkthrough.
STACKIT
Der souveräne europäische Cloud-Anbieter hinter dem Framework, mit IaaS und PaaS aus eigenen Rechenzentren in Deutschland und Österreich.
Übergeben Sie Konfiguration, Abnahmenachweise, Dashboards, Incident-Verantwortung und Entscheidungen zur Quellaufbewahrung.
Übergeben Sie den geprüften Konfigurationsstand, Workload- und Gateway-Inventar, Quellmanifest, Migrationsjournal, Backup-Orte, Abnahmeergebnisse, Dashboard-URL und Rollback-Entscheidung. Halten Sie Zugangsdaten aus dem Übergabedokument heraus und verweisen Sie auf den freigegebenen Secret-Speicher.
Vereinbaren Sie ein zum Workload passendes anfängliches Stabilisierungsfenster von 24 bis 72 Stunden. Benennen Sie Incident- und Datenbank-Recovery-Verantwortliche, bestätigen Sie Aufbewahrungs- und Restore-Verfahren und testen Sie Alarmzustellung, bevor Sie sich darauf verlassen. Flex-Backups ergänzen Migrationsdumps; ein verifizierter Dump-Rollback ist kein Nachweis für Managed-Service-Recovery.
Beenden Sie die Stabilisierung nur bei dauerhaft gesundem fachlichem Verhalten, vollständiger Telemetrie, ohne ungelöste kritische Probleme und mit Betriebsfreigabe. Nehmen Sie pausierte Automatisierung bewusst wieder auf. Bewahren Sie Quelldaten und geschützte Nachweise auf, bis die vereinbarten Aufbewahrungs- und Abgleichkriterien die Stilllegung erlauben. Beginnen Sie HPA- und Kapazitätsexperimente erst nach der Stabilisierung in einem separaten Änderungsfenster.
Kehren Sie zum Optimize-Zyklus des Migration Framework zurück: repräsentative Betriebsnachweise sammeln, begrenzende Ebene identifizieren, eine kontrollierte Änderung umsetzen und Zuverlässigkeit, Performance sowie Kosten vor dem Beibehalten validieren.
Optimize startet, sobald Workloads auf STACKIT laufen und reale Daten aus dem Betrieb vorliegen. Das Modul überführt Beobachtungen aus dem Betrieb in messbare Verbesserungen für Performance, Stabilität und Wirtschaftlichkeit.
Optimize ist keine einmalige Aufgabe, sondern ein iterativer Zyklus, der sich mit früher Stabilisierung und Unterstützung direkt nach dem Cutover überschneiden kann.
Viele Entscheidungen zu Rightsizing und Tuning sind erst unter echter Last belastbar. Nach dem Cutover lassen sich Annahmen mit Daten aus dem Betrieb validieren und präzisieren.
Öffnen Sie grafana_dashboard_url oder den Ordner SCF Replatform. Terraform verwaltet acht Panels.
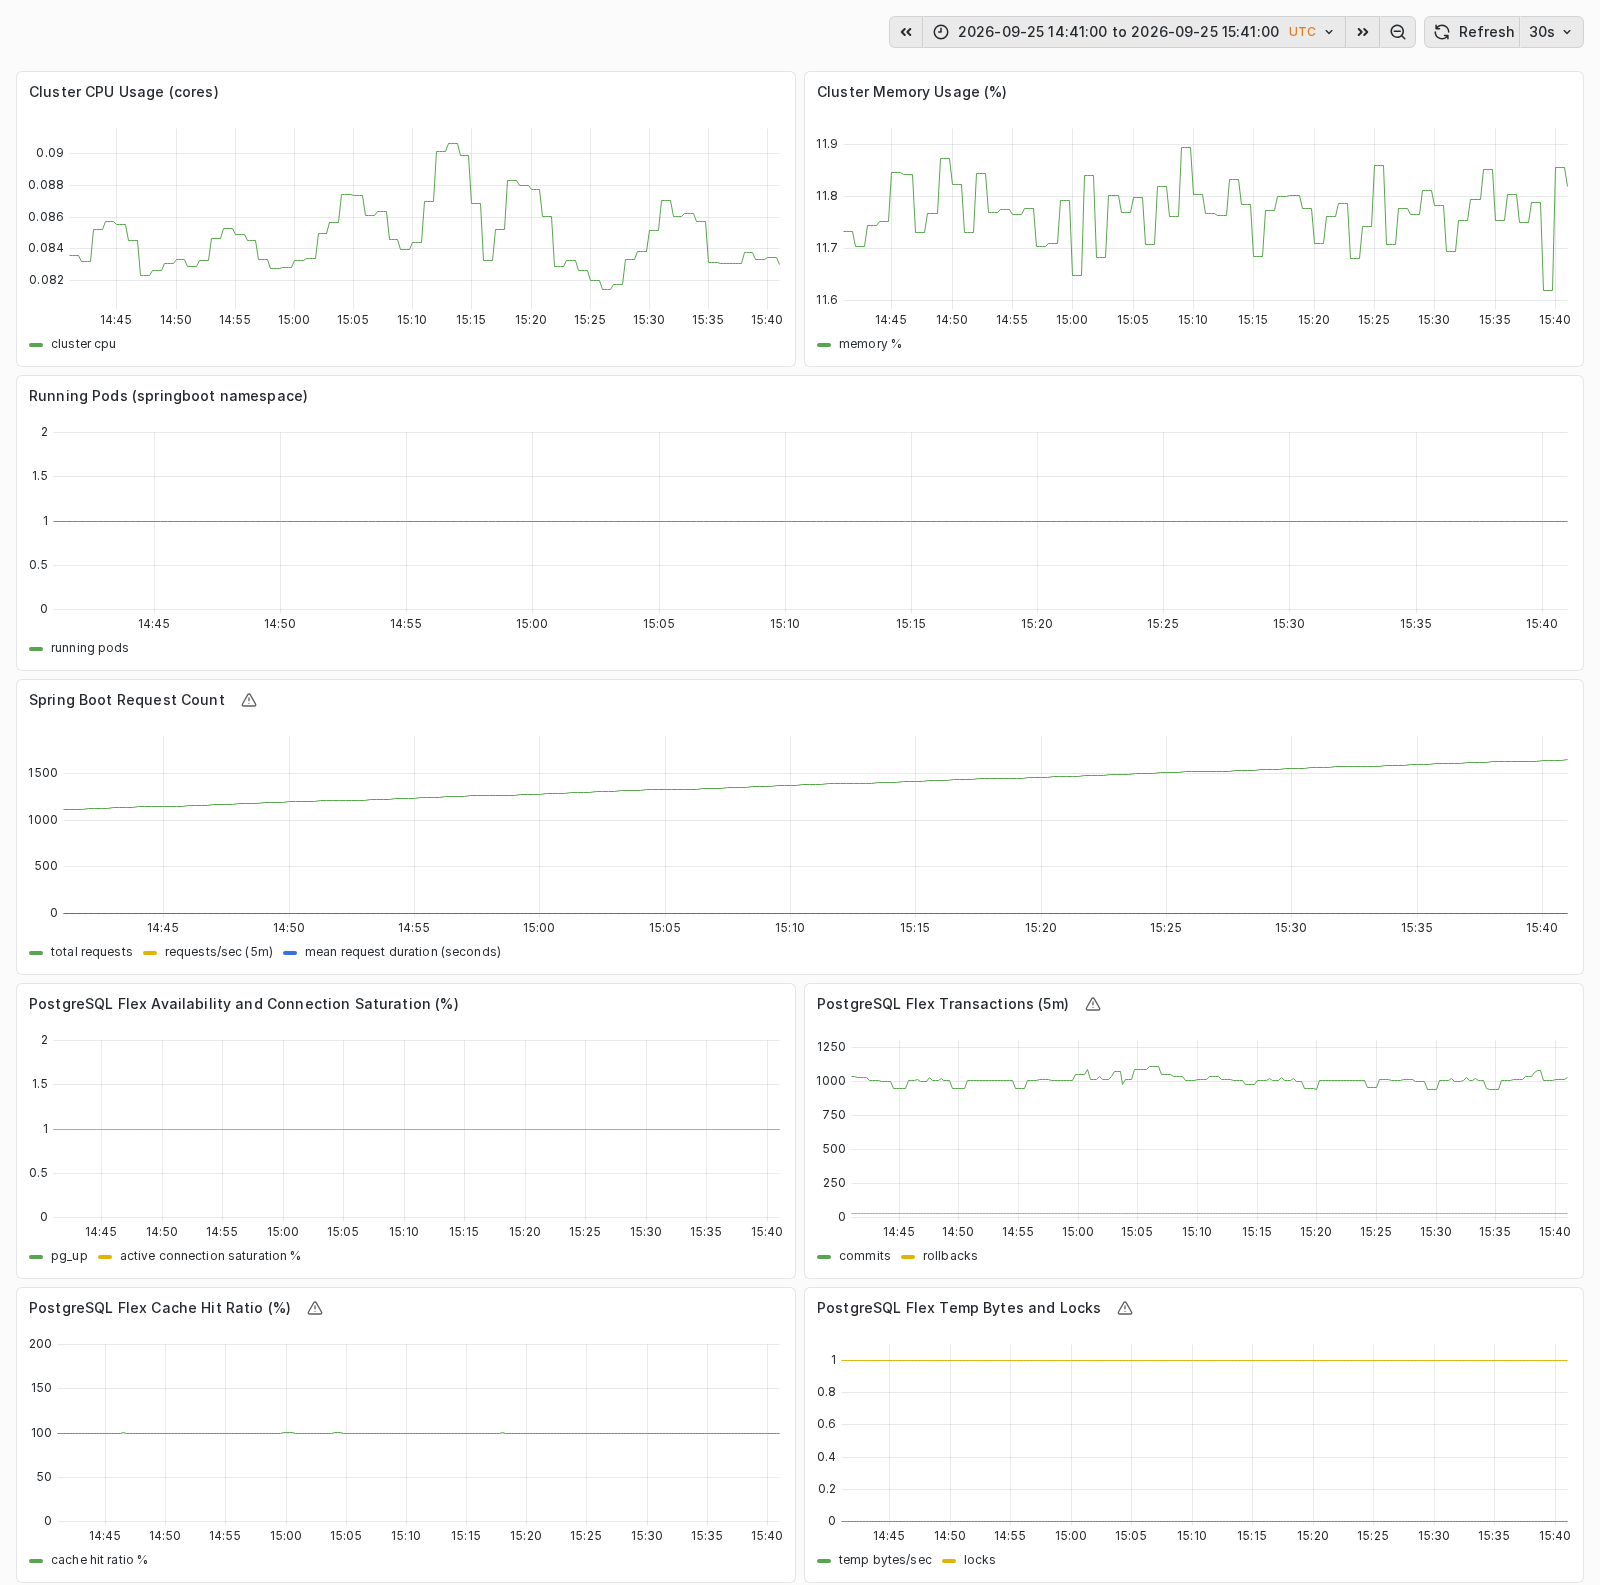
Aufnahme der Referenzbereitstellung vom 25. September 2026, 14:41 bis 15:41 UTC. Sie zeigt eine Stunde Testbetrieb mit geringer Last, keine repräsentative Basis für Produktions-Sizing. Bewerten Sie Anwendungsaktivität gemeinsam mit Datenbankverfügbarkeit und -auslastung, bevor Sie einen Optimierungskandidaten auswählen. Die folgende Tabelle erläutert die Grenzen dieser Signale.
| Panelgruppe | Unterstützte Entscheidung | Interpretationsgrenze |
|---|---|---|
| Cluster-CPU und -Speicher | Worker-Auslastung und Gesamtkapazität | Die CPU-Abfrage zeigt belegte Kerne, keinen Auslastungsprozentsatz; Cluster-Summen identifizieren keinen einzelnen Pod-Engpass |
| Laufende Pods | Vorhandensein des Workloads | Ein Scrape-Ersatzwert beweist nicht, dass alle Replikas gesund sind; Kubernetes-Rollout und Soll-Replikazahl prüfen |
| Anwendungsanfragen | Anfragerate und mittlere Dauer | Der Boot-2-Adapter liefert keine Latenzperzentile und kein vollständiges Fehlerraten-SLO |
| PostgreSQL-Verfügbarkeit und -Verbindungen | Datenbankerreichbarkeit und Verbindungsdruck | pg_up und tatsächlichen Scrape-Zustand unabhängig prüfen |
| PostgreSQL-Transaktionen | Commit- und Rollback-Trends | Veränderungen mit Anfragelast und Anwendungsverhalten korrelieren |
| PostgreSQL-Cache-Treffer | Verhalten des Lesecaches | Geringe Anfragelast und fehlende Zeitreihen begründen keinen Kapazitätsbedarf |
| Temporäre PostgreSQL-Bytes und Sperren | Untersuchung von Abfragen oder Konkurrenz | Mehr Rechenleistung behebt Abfrage- oder Sperrprobleme nicht automatisch |
Prüfen Sie vor der Interpretation echte up=1-Messwerte für beide Scrape-Jobs. Einige
Cluster-Panels enthalten Ersatzwerte; eine dargestellte Null belegt daher keinen Nullverbrauch.
Begrenzen Sie Abfragen auf den gewünschten Cluster und die Datenbank, wenn eine Datenquelle
mehrere Workloads enthält. Nutzen Sie zusätzliche Telemetrie und fachliche Tests für
Latenzperzentile, Fehler und Recovery-Ziele.