Zum Inhalt springen
Beta

Relocate to STACKIT: Überblick zur VMware-Migration

Zuletzt aktualisiert am

Stackit LogoStackit Logo
STACKIT

Relocate to STACKIT: Überblick zur VMware-Migration

Planen Sie VMware Relocate nach STACKIT: Discovery, Zieldesign, Landing-Zone-Bereitschaft, Migrationswellen, kontrollierter Cutover, Validierung und Optimierung.

PLAN

Rapid Discovery

Starten Sie in Assess mit einer schnellen Inventarisierung von VMware-Compute, Storage, Betriebssystemen und ersten Kapazitätsannahmen. Halten Sie Unsicherheiten für die vertiefte Discovery sichtbar, statt provisionierte Kapazität als Ziel-Sizing zu behandeln.

AssessRapid DiscoveryÜbersicht In 4 Trails

Das folgende Diagramm zeigt den Kern von Rapid Discovery: Rohdaten aus Quellsystemen werden durch Tooling in eine entscheidungsreife Baseline überführt, die frühe Preisindikationen und erste Sizing-Annahmen ermöglicht.

Seitlich wischen, um das ganze Diagramm zu sehen
Rapid-Discovery-Prozess Eingabedaten werden mit Rapid-Discovery-Tooling verarbeitet und in entscheidungsrelevante Ergebnisse für frühe Migrationsentscheidungen überführt. EingabedatenCMDB- und Inventar-ExporteAsset-Listen, Hosts und Plattform-BasisdatenHypervisor- und Cloud-ReportsNutzung, Footprint und AuslastungssignalePlattform-ListenKubernetes-, Datenbank- und OS-BaselinesRapid-Discovery-ToolingDatensätze aufnehmen und normalisierenQuellen in ein einheitliches Schema überführenAssets klassifizieren und aggregierenNach Technologie und Menge konsolidierenAnnahmen anwendenKonfidenzniveaus und WachstumsfaktorenOutput-InformationenKonsolidierte Asset-BaselineFaktenbasis für Umfang und PlanungInitiales STACKIT-SizingErste KapazitätsannahmenPreisindikation und TCO-KorridorFrühe Kostenorientierung für Entscheidungen
STEP

Discovery

Erweitern Sie die Basislinie des Bestands um Abhängigkeiten, Anwendungskritikalität, Betriebsgrenzen und repräsentative CPU-, Memory-, Storage- und Netzwerk-Messwerte, die für Relocate-Design und Wellenbildung benötigt werden.

Design and mobilizeDiscoveryÜbersicht In 4 Trails
Discovery von Quelle zur Entscheidung Discovery trennt technische und menschliche Eingaben, führt technische und menschlich angereicherte Analysen aus und übergibt beide Ergebnisströme an nachgelagerte Module. Discovery-EingabenTechnisches und automatisiertes DiscoveryInfrastruktur-InventarCMDB, VM, Datenbanken, Middleware, StorageLaufzeit- und NutzungsdatenCPU, RAM, I/O, Netzwerk und SaisonalitätIntegrations- und Fluss-SignaleNetzwerkpfade, APIs, Identität, DatenflüsseAssessment-getriebene menschliche EingabenSecurity- und Compliance-KontextDatenklassen, Kontrollen, Audit-AnforderungenOwner- und Business-InputKritikalität, Release-Fenster, Lifecycle-PläneDiscovery-Analyse-ToolingTechnikbasierte AnalysenNormalisieren und korrelierenDatensätze und technische Identitäten zusammenführenAbhängigkeiten abbildenKommunikation und Kopplung ableitenNutzungs- und Sizing-AnalyseBelastbare Lastkorridore ableitenVorläufige SegmentierungNach Stack und Umgebung gruppierenHuman-driven Analysen (Application-Owner-Input)Kritikalität und Risiko kalibrierenBusiness-Impact und Restriktionen validierenWellenfähigkeit und ReihenfolgeAbhängigkeiten mit Release-Fenstern abstimmenAnnahmen- und Gap-RegisterOffene Punkte und Reifegrad dokumentierenÜbergabe-ErgebnisseTool-basierte ErgebnisseDesignOptionen für Zielarchitektur und belastbare Sizing-DatenLanding ZonePlattform-Guidelines und Anforderungen an Account-StrukturenMigrationsplanWellen-Backlog, Reihenfolge und Cutover-FensterAssessment-validierte ErgebnisseSecurity und ComplianceControl-Bedarfe, Datenklassen und Remediation-PunkteOperating ModelRollenbild, Ownership-Grenzen und ProzessauswirkungenBusiness CaseValue-/Risikoprofil und Modernisierungsprioritäten
Discovery-Analysefluss, der technische Nachweise und Input von Application Ownern in Migrationsentscheidungen zusammenführt

Inventarisierung

Vollständige Erfassung von Servern, virtuellen Maschinen, Datenbanken, Middleware und Anwendungen.

Abhängigkeitsanalyse

Abbildung von Kommunikationspfaden und Laufzeitabhängigkeiten zwischen Systemen und Anwendungen.

Ressourcennutzung

Analyse von CPU-, RAM-, Storage- und I/O-Verhalten über einen repräsentativen Zeitraum.

Betriebskontext

Erhebung von Anforderungen zu Backup, Patch, SLA, Compliance und betrieblichen Randbedingungen.

Input der Application Owner

Strukturierte Fragebögen und Interviews zur Validierung von Annahmen und zum Schließen von Datenlücken.

STACKIT LogoSTACKIT Logo
VMware Relocate Source Readiness STACKIT · Runbook Open asset ↗

Dokumentieren Sie das Ergebnis für jede VM und bewahren Sie die verwendete Evidenz auf.

  • Gastkompatibilität: Bestanden bei unterstütztem Betriebssystem, Boot-Modus, Disk-Layout und Konvertierungspfad. Blockiert bei nicht unterstütztem Gerät, Verschlüsselungsverfahren, Architektur oder Boot-Pfad.
  • Quellintegrität: Bestanden bei gesunder VM, getestetem Recovery Point und sicherem Snapshot-Zustand. Blockiert bei Konsolidierungsfehlern, fehlgeschlagenem Backup oder unzureichender Datastore-Kapazität.
  • Performance-Baseline: Bestanden mit repräsentativen Messungen für CPU, Arbeitsspeicher, Storage und Wachstum. Blockiert, wenn nur provisionierte Kapazität oder unvollständige Peak-Daten vorliegen.
  • Zugriff: Bestanden mit getesteten Endpoint-Zugangsdaten nach Least-Privilege-Prinzip und Zertifikatsvertrauen. Blockiert bei fehlenden API-Berechtigungen oder unverwalteten Shared Credentials.
  • Transferpfad: Bestanden mit gemessener Kapazität und validierten Routen, Ports, DNS, NTP und MTU. Blockiert bei Firewall-Lücken, instabilen Verbindungen oder einer Kopierdauer außerhalb des Wellenplans.
  • Cutover-Eingaben: Bestanden mit Ziel-Mappings, Validierungstests, Rollback-Trigger und Quellaufbewahrung. Blockiert bei undefinierter Verkehrsumstellung oder nicht testbarem Rollback-Pfad.

Geben Sie eine VM erst für die Replikation frei, wenn jeder Blocker einen Owner und ein Lösungsdatum hat. Bedingte Punkte benötigen einen ausführbaren Behebungsschritt im Wellen-Runbook; Beobachtungen ohne Auswirkungen können im Evidenznachweis verbleiben.

LIFT

Design

Bestätigen Sie, dass der Workload VM-basiert bleiben soll und eine Verlagerung seiner Runtime-Platzierung mit minimalem Redesign besser passt als ein Rehost-Rebuild oder ein Plattformwechsel.

Design and mobilizeDesignRelocate In 1 Trail
R-Strategie-Migrationsmethode Entscheidungsfluss von Discovery bis Produktion mit den sieben R-Strategien: Relocate, Rehost, Replatform, Repurchase, Refactor, Retain und Retire. R-Strategie-MigrationsmethodeFrom discovery and path selection through the seven R-strategies to validation, transition, and production.DiscoveryDiscoveryAssess / prioritizeAssess / prioritizeDetermine migration pathDetermine migration pathValidationValidationTransitionTransitionProductionProductionRelocateRelocate(move VM)Define Landing ZoneDefine Landing ZoneUse migration toolsUse migration toolsAUTOMATEMANUALInstallInstallConfigConfigDeployDeployValidation & handoverRehostingRehosting(move application)Define Landing ZoneDefine Landing ZoneUse migration toolsUse migration toolsAUTOMATEMANUALInstallInstallConfigConfigDeployDeployReplatformingReplatforming(lift and reshape)Define Landing ZoneDefine Landing ZoneMap Target PlatformMap Target PlatformAdapt Platform StackAdapt Platform StackRepurchasingRepurchasing(replace, drop and shop)Purchase COTS/SaaS and licensingPurchase COTS/SaaS and licensingMigrate business processMigrate business processRefactoringRefactoring(re-architecting applications)Redesign application/ infrastructure architectureRedesign application/ infrastructure architectureApp code developmentApp code developmentFull ALM/SDLCFull ALM/SDLCIntegrationIntegrationRetain/moveRetain/movekeep for now or move laterRetire/decommissionRetire/decommissionLanding zone foundationLanding zone foundationShared platform base for all paths
R-Strategie-Methode mit sieben Migrationspfaden und Relocate als Bewegungspfad für VM-Landschaften

Relocate verschiebt Workloads mit minimalen Architektur-Änderungen in ein STACKIT-kompatibles Zielsetup. Im Fokus steht eine schnelle und risikoarme Überführung, nicht die sofortige cloud-native Modernisierung.

Konkret bedeutet Relocate: Das bestehende VM-Betriebsmuster bleibt weitgehend erhalten. Geändert wird vor allem der Zielstandort inklusive Plattformkontrollen, nicht das Laufzeitmodell der Workloads.

Bei Relocate ist die Datenmigration oft implizit gelöst, weil die gesamte VM inklusive Storage verschoben wird. Trotzdem sollten bei großen Datenmengen explizite Design-Entscheidungen getroffen werden:
  • Anbindung im Netzwerk: End-to-End-Durchsatz, Latenz und Stabilität des Pfads für den Transfer im Fenster der Migration verifizieren.
  • Storage-Klasse: Quell- und Ziel-Storage-Klassen vor dem Cutover auf erforderliche IOPS-/Throughput-Profile abstimmen.
  • Pre-Seeding: Daten möglichst vor dem Cutover übertragen.
  • Delta-Synchronisation: Im finalen Fenster nur die letzten Änderungen nachziehen.
  • Integritätsprüfung: Prüfsummen und Stichproben-Reads für migrierte Volumes definieren.
  • Rollback-Checkpoints: Quell-Snapshots bis zur Abnahme im Ziel vorhalten.
Abgesicherter VMware-zu-STACKIT-Transferpfad
OPS

Zielkapazität abbilden

Erstellen Sie pro VM und Volume jeweils eine versionierte Mapping-Zeile.

  • Quell-VM und Workload: Stabile Inventar-ID und Applikationszuordnung.
  • Zielregion und Platzierung: Region, Availability-Zone- oder Metro-Anforderung und Quota-Ergebnis.
  • Machine Type: Exakter Typ, CPU- und RAM-Anforderung, bestimmende Dimension, Headroom und Overprovisioning-Entscheidung.
  • Root-Volume: Kapazität, Performance-Klasse, Boot-Annahmen und Recovery-Annahmen.
  • Daten-Volumes: Source-to-Target-Disk-Mapping, Kapazität, Performance-Klasse und Konsistenzgruppe.
  • Netzwerk: Zielnetzwerk, Adressen, Security Groups, DNS und erwartete Bandbreite.
  • Validierungsschwellen: CPU, Memory, Latenz, IOPS, Throughput, Anwendungs-SLO und Beobachtungsfenster.
  • Anpassungsoptionen: Freigegebener größerer und kleinerer Typ, Storage-Alternative, Änderungsmethode und Rollback-Bedingung.

Geben Sie das Mapping erst frei, wenn Zielprofil, erwartete Kosten, Quotas, Tool-Mapping und Akzeptanzschwellen vollständig bekannt sind. Übergeben Sie das exakte Mapping in die Coriolis- oder Acura-Testmigration, statt Zielressourcen erst während des Cutover auszuwählen.

BASE

Landing Zone

Errichten Sie das durch Governance abgesicherte Cloud-Fundament, bevor Migrationswellen davon abhängen. Trennen Sie gemeinsame Platform-Landing-Zone-Fähigkeiten von workload-spezifischen Application Landing Zones und leiten Sie beide aus Enterprise Controls und Discovery-Nachweisen ab.
Design and mobilizeLanding ZonesÜbersicht In 6 Trails
Schichten aus Platform und Application Landing Zone

Eine Landing Zone ist die strukturierte Cloud-Grundlage, die festlegt, wie Ihre Organisation auf STACKIT von Anfang an betrieben wird. Sie verbindet Governance, Identität, Security, Netzwerkarchitektur, Kostensteuerung und Automatisierung zu einem belastbaren Rahmen.

Ohne diese Grundlage stocken Migrationswellen typischerweise durch fehlende Freigaben, inkonsistente Kontrollen und wiederkehrende Plattformentscheidungen.

Die folgende Visualisierung zeigt die zentralen Komponenten für eine belastbare Plattform-Basis.

Landing-Zone-Kernkomponenten Sechs Bausteine einer sicheren Landing Zone. Landing-Zone-KernkomponentenDie sechs Bausteine einer sicheren Plattformbasis auf STACKIT.Account GovernanceAccount GovernanceWie strukturiere ich meine Projekte?Identity & Access ManagementIdentity & Access ManagementWer darf was tun auf der Plattform?Security und ComplianceSecurity und ComplianceWie überwache ich die Plattform sicher?NetzwerkarchitekturNetzwerkarchitekturWie sind Komponenten sicher verbunden?Kostensteuerung und KontrolleKostensteuerung und KontrolleWie behalte ich Ausgaben im Blick?Automatisierung (IaC)Automatisierung (IaC)Wie wird alles bereitgestellt?
  • Kontrolle und Risikoreduktion: Security- und Compliance-Kontrollen werden konsistent umgesetzt.
  • Skalierbare Delivery-Basis: Wiederverwendbare Muster beschleunigen mehrere Migrationswellen.
  • Klare Verantwortlichkeiten: Zuständigkeiten zwischen Plattform-, Security- und Applikationsteams sind klar.
  • Höhere Umsetzungsgeschwindigkeit: Grundlegende Kontrollen müssen nicht je Applikation neu entworfen werden.

Starten Sie den Landing-Zone-Stream so früh wie möglich parallel zum Discovery.

  • Zu spät: Produktive Migrationen werden blockiert, weil Pflichtkontrollen noch fehlen.
  • Zu früh ohne Discovery-Feedback: Relevante Applikationsrandbedingungen fehlen und führen zu Nacharbeit.

Bewährt hat sich ein zweigleisiges Vorgehen: Die Plattform-Basis früh etablieren und Application-Landing-Zone-Templates iterativ mit Discovery-Erkenntnissen verfeinern.

Zwei Ebenen: Platform und Application Landing Zone

Abschnitt betitelt „Zwei Ebenen: Platform und Application Landing Zone“

Platform Landing Zone

Unternehmensweite Grundlage für Governance, Identität, Security, Netzwerk, Kostensteuerung und Automatisierung.

Zur Platform Landing Zone

Application Landing Zone

Workload-spezifische Umsetzungsprofile, abgeleitet aus Plattform-Basis und Discovery-Ergebnissen.

Zur Application Landing Zone
STACKIT LogoSTACKIT Logo
STACKIT Landing Zone Accelerator STACKIT · Blueprint Open asset ↗

Dieses Asset liefert eine wiederverwendbare Grundlage für die Umsetzung einer STACKIT Platform Landing Zone. Es ist für Enterprise-Umgebungen ausgelegt, die eine strukturierte Basis für Governance, Security, Netzwerk, Kostensteuerung und Automatisierung benötigen.

Repository:
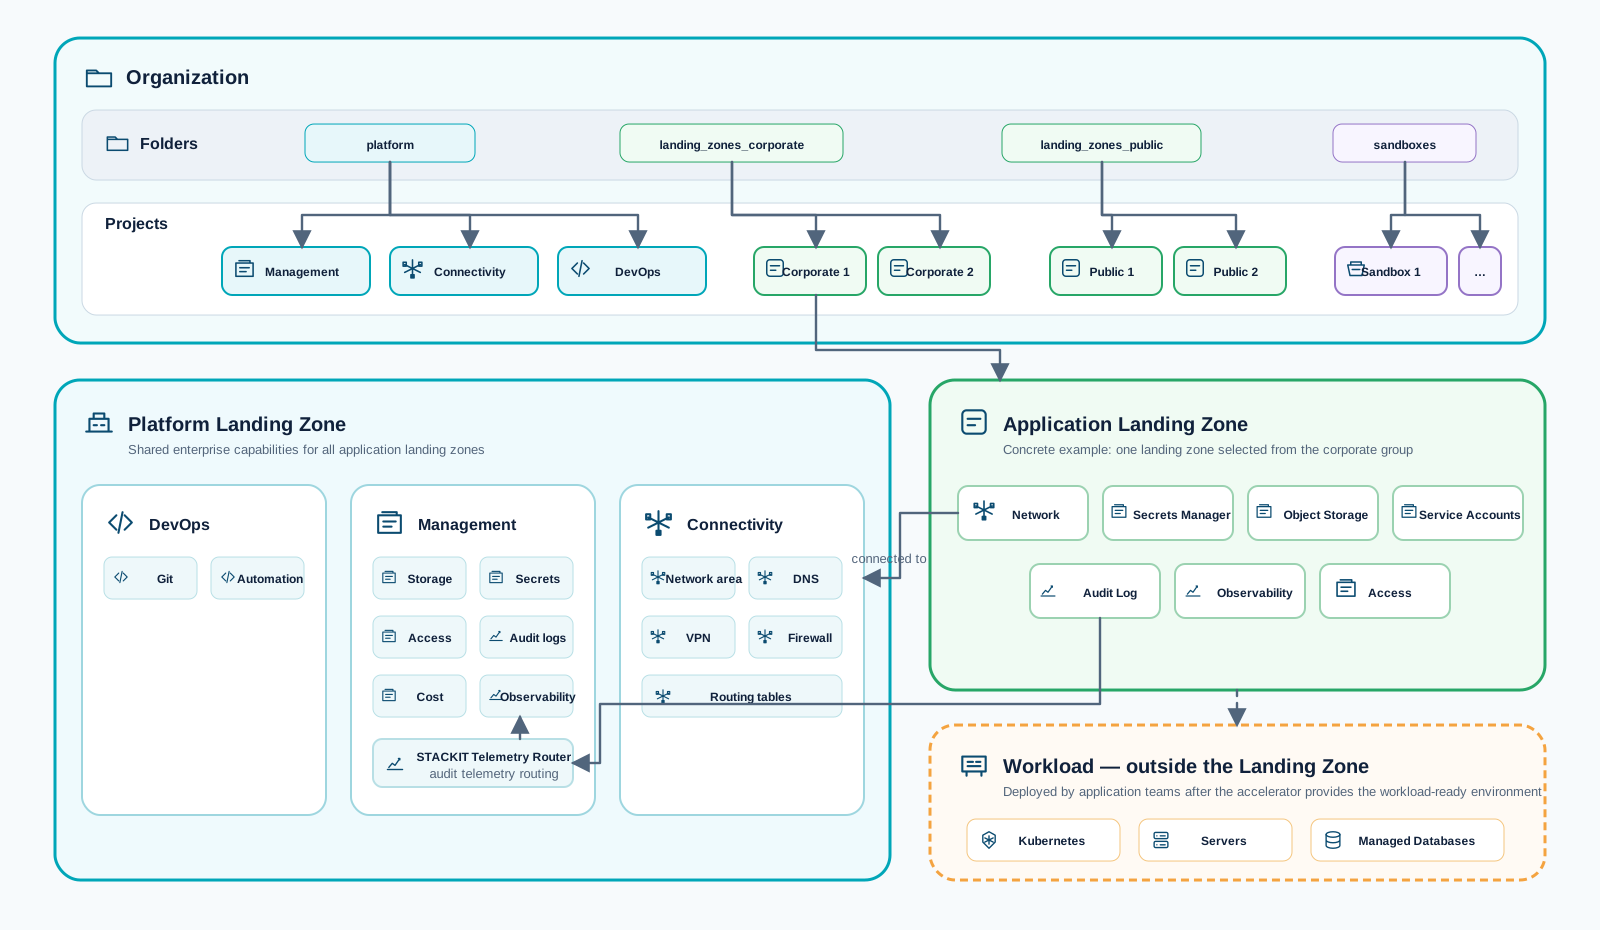
STACKIT-Landing-Zone-Accelerator-Architektur vom Bootstrap über Platform-Fähigkeiten bis zu Application Landing Zones
STACKIT LogoSTACKIT Logo
VM Application Landing Zone für Relocate STACKIT · Blueprint Open asset ↗

Die Platform Landing Zone stellt organisationsweite Governance-, Connectivity-, Identity-, Audit- und Automatisierungsfähigkeiten bereit. Der STACKIT Landing Zone Accelerator erstellt danach ein Application-Landing-Zone-Projekt pro Workload und Umgebung. Security Groups bilden ein explizites manuelles Freigabegate, bevor Migrationstooling oder VMs in dieses Projekt gelangen.

Platform Landing ZoneVM Application Landing ZoneTool and workload contentGovernance and IAMShared connectivity and DNSAudit and automation baselineAccelerator baselineManual gateCoriolis or Hystax AcuraMigrated VMs and volumesGuest metrics, logs, and backupSTACKIT project and RBACRouted network and DNS zoneSecrets Manager and automation identityObject Storage and state bucketObservability endpointSecurity GroupsRule review and approval baseline readyinherit shared route policyinherit guardrailsapproved ingress and egress

Diese Grenze ist bewusst gesetzt:

  • Landing-Zone-Verantwortung: Projekt, Rollen, geroutetes Netzwerk, DNS-Zone, Secrets Manager, Object Storage, Automatisierungsidentität, optionale Observability-Instanz, Labels und Shared Routing.
  • Manuelle Security-Verantwortung: Security Groups und deren workloadspezifische Ingress- und Egress-Regeln werden vor Tool-Deployment geprüft und erstellt.
  • Workload-Verantwortung: Migration-Appliances, migrierte Server und Volumes, Guest-Konfiguration, Anwendungsabhängigkeiten, Backup-Policies und Telemetrie-Agenten.
STACKIT LogoSTACKIT Logo
VM Application Landing Zone für Relocate STACKIT · Blueprint Open asset ↗
  1. Bestätigen Sie die Voraussetzungen der Platform Landing Zone: Governance-Folder, IAM-Modell, Network Area, gemeinsame DNS, Routing- und Firewall-Policy, Audit-Pfad und Ownership der Automatisierung.
  2. Leiten Sie aus Discovery eine VM-Application-Landing-Zone-Spezifikation ab: Umgebung, Project Owner, Abhängigkeitsgrenzen, Adressbedarf, DNS-Namen, Datenklassifizierung, Verfügbarkeit, Recovery-Ziele und Telemetrieanforderungen.
  3. Fügen Sie die Workload-Umgebung der Accelerator-landing_zones-Map hinzu und aktivieren Sie Corporate Networking, Secrets Manager und Observability nach Bedarf.
  4. Wenden Sie den Accelerator an und verifizieren Sie Projekt, Role Assignments, geroutetes Netzwerk, Route Policy, DNS-Zone, Secrets-Grenze, State Storage, Automatisierungsidentität und Observability-Outputs.
  5. Erstellen und genehmigen Sie die Security Groups manuell aus der Abhängigkeitsmatrix und den gewählten Control- und Transfer-Pfaden des Migrationstools.
  6. Übergeben Sie die freigegebene Projekt-ID, Netzwerk, DNS, Secrets Manager, Observability-Endpunkte, Security Groups, Quotas und Ziel-Mappings an das Coriolis- oder Acura-Runbook.
  7. Lassen Sie das gewählte Tool nur seine erforderlichen Appliance-, Worker-, Server-, Volume-, Image- und Migrationsinhalte in die Application Landing Zone deployen.
  8. Verbinden Sie VM-Guest-Metriken und Logs mit dem bereitgestellten Observability-Endpunkt, wenden Sie Backup- und Recovery-Policies an und validieren Sie alle Kontrollen in einer isolierten Testmigration.

Übergeben Sie das Projekt nicht an ein Migrationstool, bevor die Schritte 1 bis 5 bestanden sind. Das Tool nutzt die Landing Zone; es definiert oder ersetzt sie nicht.

STACKIT LogoSTACKIT Logo
VM Application Landing Zone für Relocate STACKIT · Blueprint Open asset ↗

Stellen Sie beiden Tools denselben freigegebenen Landing-Zone-Vertrag bereit und halten Sie ihre Implementierungen getrennt.

  • Gemeinsame Inputs: STACKIT-Projekt und Region, Zielnetzwerk und Adressen, Security Groups, DNS, Machine- und Volume-Mappings, Secrets-Manager-Nutzung, Observability-Endpunkte, Quotas und Rollback-Grenzen.
  • Coriolis-Inhalte: Coriolis-Appliance-Komponenten, STACKIT-Endpunkt, Minion-Pools, Transfers, Deployments und die daraus entstehenden VM- und Volume-Ressourcen.
  • Hystax-Acura-Inhalte: Acura-Control-Komponenten, Replikationsintegration, Cloud-Site-Einstellungen, Orchestrierungspläne, Ziel-Snapshots oder Volumes und die daraus entstehenden VM-Ressourcen.
  • Gemeinsamer Abschlussnachweis: Security-Rule-Test, Abhängigkeitstest, Guest-Telemetrie, Backup- und Restore-Nachweis, Anwendungsabnahme und Entfernungsplan für temporären Migrationszugriff.
OPS

Migrationsplan

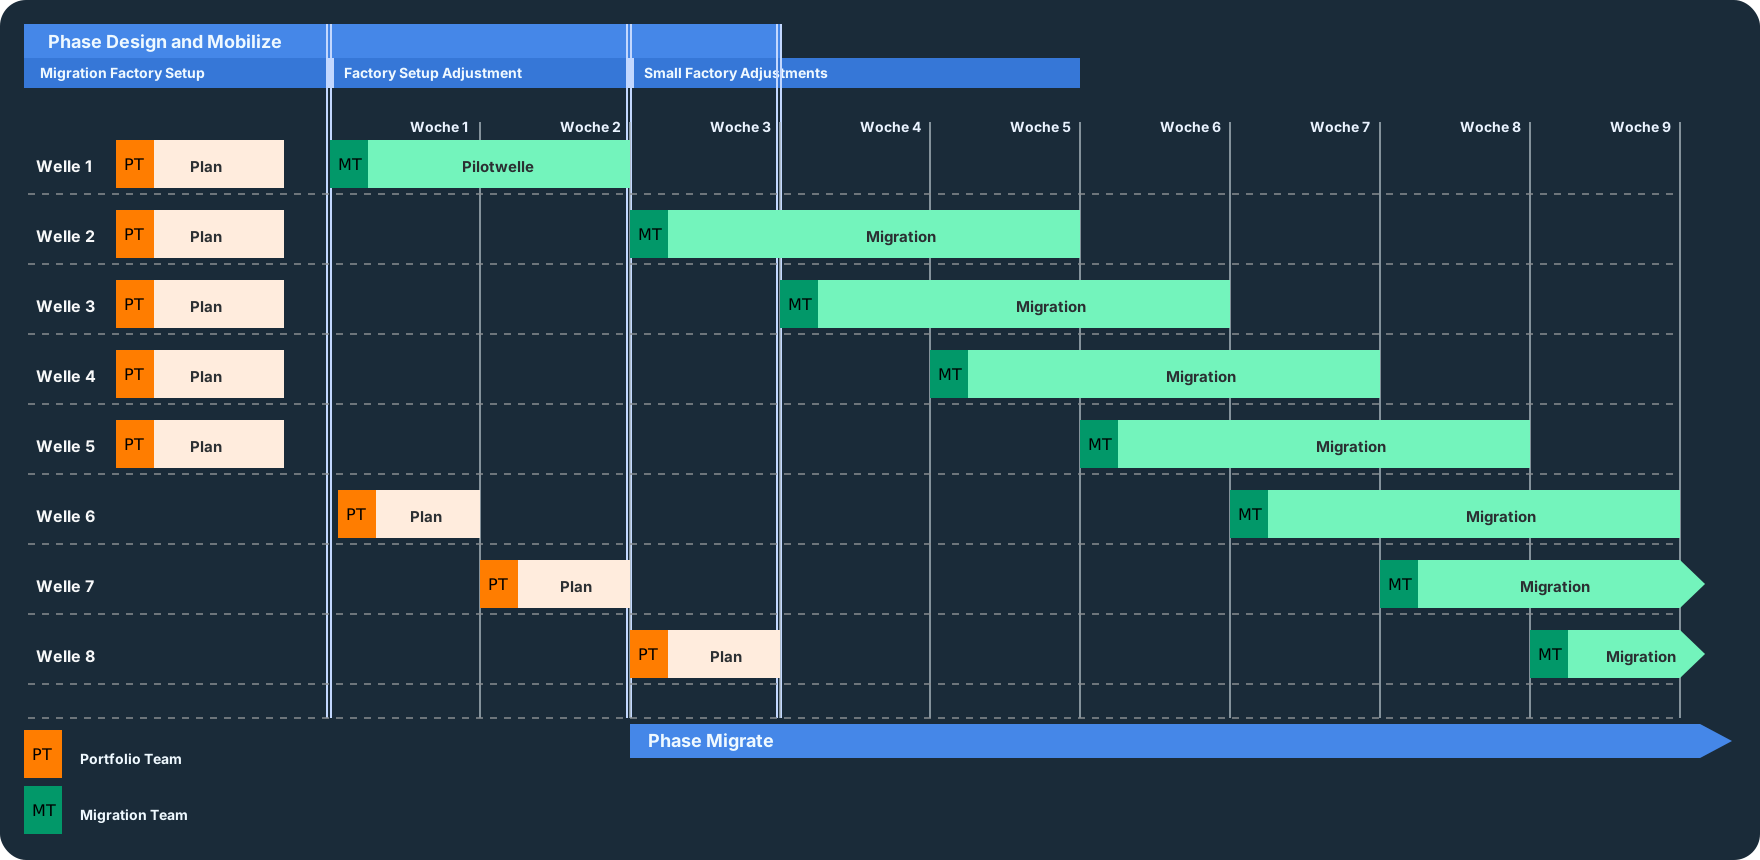
Gruppieren Sie VMs nach verifizierten Abhängigkeiten und technischen Randbedingungen, beginnen Sie mit einem repräsentativen risikoarmen Piloten und definieren Sie geordnete Runbooks, Wartungsfenster, Cutover-Gates und Rollback-Grenzen.
Design and mobilizeMigrationsplanÜbersicht In 2 Trails
Migrationsplan-Modell, das Portfolio-Nachweise, Wellen-Governance, Runbooks und kontrollierte Ausführung verbindet

Wellenbasierte Planung

Anwendungen in logische Migrationswellen gruppieren, basierend auf Abhängigkeiten, Geschäftskritikalität und technischer Komplexität.

Migrations-Runbooks

Detaillierte Schritt-für-Schritt-Runbooks je Welle oder Anwendung erstellen, inklusive Vorbereitung, Ausführung, Cutover, Rollback und Validierung.

Ressourcenplanung

Nötige Teams, Fähigkeiten, Werkzeuge und Experten je Welle festlegen, einschließlich Enablement- und Schulungsplanung.

Umsetzungs-Governance

Verbindliche Governance-Prozesse, Verantwortlichkeiten, Kommunikationsroutinen und Cutover-Kontrollen für die Wellenumsetzung etablieren.

STACKIT LogoSTACKIT Logo
Ausführung einer VMware-Relocate-Welle STACKIT · Runbook Open asset ↗

Starten Sie die Replikation erst, wenn alle Eingangskriterien erfüllt sind:

  • Der Wellenumfang und die Abhängigkeitsgruppen sind eingefroren und jede VM hat eine stabile Quellkennung.
  • Die VMware-Quellbereitschaft, tool-spezifische Voraussetzungen und Wiederherstellungspunkte sind verifiziert.
  • Ziel-Maschinentypen, Volumes, Performance-Klassen, Netzwerke, Adressen, Security Groups und Platzierung sind freigegeben und innerhalb der Quoten verfügbar.
  • Anwendungsseitige Konsistenz, Testfälle, Wartungsfenster, erwartete Downtime und maximale Cutover-Dauer sind dokumentiert.
  • Source Freeze, Traffic Switch, Monitoring-Aktivierung und Rollback-Aktionen haben benannte technische Owner.
  • Der Quellaufbewahrungszeitraum und die Befugnis zum Löschen der Quell-VMs sind vor dem Cutover definiert.
LIVE

Migrate

Starten Sie Migrate nur mit freigegebenen Source- und Target-Zuständen. Bewahren Sie Topologie-Annahmen, synchronisieren Sie den Zustand, steuern Sie den Traffic-Cutover und fordern Sie objektive Nachweise für Kontinuität und Telemetrie.

MigrateMigrateÜbersicht In 4 Trails
End-to-End-Ablauf einer Migrationswelle Vier aufeinanderfolgende Phasen führen von der Wellenfreigabe über Vorbereitung und Cutover zur Stabilisierung und Übergabe. Jede Welle durchläuft denselben kontrollierten Factory-Ablauf. Scope und Baseline sichern, die Migration ausführen, Akzeptanz belegen und stabil an den Betrieb übergeben. 1 FREIGEBEN Scope und Baseline Fenster, Rollback und Verantwortung Versionen und Abhängigkeiten einfrieren 2 VORBEREITEN Readiness und R-Pfad Quelle und Ziel technisch prüfen Runbook je Archetyp ausführen 3 UMSCHALTEN Cutover und Akzeptanz Traffic kontrolliert auf STACKIT führen Technik, Funktion und Betrieb validieren 4 STABILISIEREN Lernen und übergeben Befunde in kurzen Schleifen beheben An Optimize und Operate übergeben Nachweisbarer Wellenabschluss: akzeptiert, stabilisiert und mit vollständigem Handover
Kontrollierter Migrationswellen-Flow von Readiness über Synchronisation, Cutover und Validierung bis zur Übergabe
  1. Platzierung im Ziel auf STACKIT mit äquivalenten Annahmen zur Topologie herstellen.
  2. Daten und Zustände mit Konsistenzprüfungen migrieren.
  3. Traffic mit Rollback-Leitplanken umschalten.
  4. Geschäftskontinuität und operative Telemetrie verifizieren.
AUTO

Einen Tool-Pfad wählen und ausführen

Wählen Sie für die komplette Welle genau ein freigegebenes Migrationstool. Halten Sie dessen Endpoint-, Mapping-, Replikations-, Testmigrations-, Final-Sync- und Cutover-Sequenz bis zum Abschluss zusammen.

SAFE

Validieren oder Rollback

Starten Sie die Validierung, sobald die Zielinstanzen erreichbar sind. Erfassen Sie Zeitstempel, weil das verbleibende Rollback-Fenster eine technische Randbedingung ist.

  1. Validieren Sie den VM-Zustand: Boot, Konsole, Disks, Dateisysteme, Mounts, Netzwerkschnittstellen, Routen, DNS, NTP, Zertifikate, Server Agent und erforderliche Betriebssystem-Services.
  2. Validieren Sie den Datenzustand: erwarteter Wiederherstellungspunkt, Datei- oder Datenbankkonsistenz, Checksummen oder Record Counts sowie keine unbeabsichtigten Schreibzugriffe auf der Quelle.
  3. Starten Sie Abhängigkeiten und Anwendungen in Reihenfolge und führen Sie dann Health Checks, synthetische Transaktionen, Integrationen, geplante Jobs und verpflichtende Geschäftstests aus.
  4. Bestätigen Sie Logs, Metriken, Alerts, Backups, administrativen Zugriff und Security Controls in der Zielumgebung.
  5. Vergleichen Sie CPU, Memory, Disk-Latenz, IOPS, Durchsatz, Netzwerkverhalten, Applikationslatenz und Fehlerraten mit den freigegebenen Abnahmeschwellen.
  6. Treffen Sie an der Entscheidungs-Deadline entweder die Zielabnahme oder führen Sie den dokumentierten Rollback aus. Weichen Sie nicht in ein ungebundenes Troubleshooting-Fenster aus.

Rollback ist nur sicher, solange die Data Ownership eindeutig bleibt. Wenn das Ziel bereits Schreibzugriffe akzeptiert hat, stoppen Sie die Zielverarbeitung und führen Sie die freigegebene Rücksynchronisations- oder Abstimmungsmethode aus, bevor die Quelle neu gestartet wird. Schalten Sie nie beide Kopien mit Produktionskonnektivität gleichzeitig ein, sofern das Anwendungsdesign keine gleichzeitigen Schreiber explizit unterstützt.

Die Welle ist technisch abgeschlossen, wenn:

  • verpflichtende technische und funktionale Prüfungen bestanden sind und das Ziel das deklarierte System of Record ist;
  • Monitoring- und Backup-Nachweise aus STACKIT vorliegen;
  • Defekte, temporäre Ausnahmen und Folgeaktionen Owner und Fristen haben;
  • tatsächliche Dauern für Replikation, Freeze, Cutover und Validierung für die nächste Welle erfasst sind;
  • Quell-VMs für den freigegebenen Aufbewahrungszeitraum ausgeschaltet und zugriffskontrolliert bleiben;
  • das Löschen der Quelle erst nach Ablauf der Aufbewahrung, Wiederherstellungsbestätigung und expliziter Freigabe erfolgt;
  • das initiale Ziel-Sizing mit seinen Messwerten und Abnahmeschwellen an Optimize übergeben ist.
OPS

Optimize

Sammeln Sie nach akzeptiertem Cutover repräsentative STACKIT-Laufzeitnachweise und überführen Sie Erkenntnisse zu Performance, Stabilität und Kosten in kontrollierte Infrastruktur-Änderungen mit Rollback-Checkpoints.
MigrateOptimizeÜbersicht In 7 Trails
Evidenzbasierter VM-Optimierungszyklus

Optimierungsentscheidungen sollten auf Laufzeitdaten basieren, nicht auf Annahmen. Für die praktische Umsetzung werden Workload-Telemetrie, Alerting und kontrollierte Infrastrukturänderungen kombiniert.

  • Managed-Observability-Basis: Mit STACKIT Observability Metriken, Logs und Traces mit Grafana, Prometheus, Thanos, Loki und Tempo erfassen.
  • Erkennungslogik: Klare Schwellwerte und Beobachtungsfenster für Unterauslastung und Überlast definieren.
  • Umsetzungspfad: Rightsizing über IaC-Änderungen (zum Beispiel VM-Flavors) mit Rollback-Checkpoints umsetzen.
  • Validierungsschleife: Nach jedem Tuning-Inkrement SLO, Fehlerquote und Laufkosten erneut messen.
GOAL

Verlagerte VMs bedarfsgerecht dimensionieren

Klassifizieren Sie den Befund vor jeder Kapazitätsänderung:

  • Keine Änderung: Das aktuelle Profil erfüllt Performance-, Resilienz- und Kostenerwartungen.
  • Compute-Downsize: CPU und Memory behalten über repräsentative Last den freigegebenen Headroom.
  • Compute-Upsize oder Familienwechsel: CPU, Memory oder CPU-zu-Memory-Verhältnis begrenzen den Workload.
  • Wechsel auf einen nicht overprovisioned Typ: Anhaltende CPU-Last, Latenz-Sensitivität oder Steal Time erfordern besser planbaren CPU-Zugriff.
  • Volume-Kapazität erhöhen: Prognostizierte nutzbare Kapazität erreicht die freigegebene Schwelle.
  • Storage-Performance ändern: IOPS- oder Throughput-Grenzen, Latenz oder I/O-Wait zeigen eine Klassenfehlanpassung, nachdem Anwendungs- und Guest-Ursachen ausgeschlossen sind.
  • Zuerst untersuchen: Das begrenzende Signal wird durch Konfiguration, Anwendungsverhalten, Abhängigkeitslatenz, Netzwerkverlust oder unzureichende Nachweise verursacht und nicht durch Ressourcenkapazität.

Ändern Sie nach Möglichkeit jeweils nur eine dominierende Dimension. Das hält Ergebnisse zurechenbar und macht Rollback-Entscheidungen belastbar.