

Service
Managed Kubernetes Platform on STACKIT (PRODYNA)
PRODYNA
Zuletzt aktualisiert am

Geführte PRODYNA Journey zur Managed Kubernetes Platform auf STACKIT: Discovery, Landing Zone, Management-Cluster, Flotte, Workloads, Day-2 und Übergabe.
PRODYNA
Ein Beratungs- und Engineering-Unternehmen für die Umsetzung digitaler Transformation, von Landing Zones bis zur Anwendungsmodernisierung.
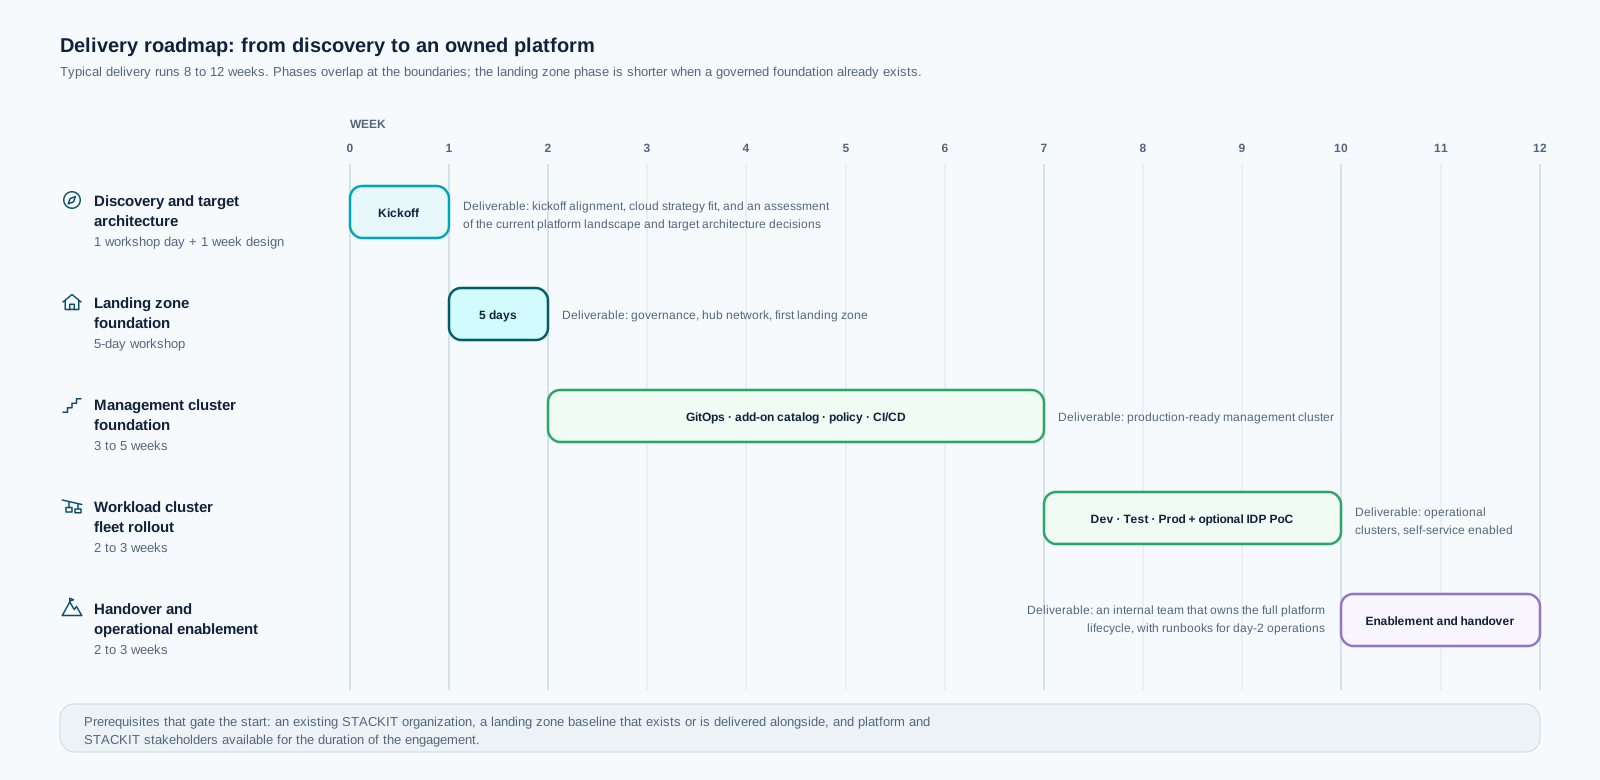
Ein eintägiger Discovery-Workshop mit den zentralen Stakeholdern analysiert die bestehende Infrastruktur, die Workloads und die Compliance-Anforderungen. In den folgenden ein bis zwei Wochen werden Zielarchitektur und Landing-Zone-Strategie entworfen.
Ergebnis: Platform Architecture Blueprint und Roadmap.
PRODYNA
Ein Beratungs- und Engineering-Unternehmen für die Umsetzung digitaler Transformation, von Landing Zones bis zur Anwendungsmodernisierung.
PRODYNA
Ein Beratungs- und Engineering-Unternehmen für die Umsetzung digitaler Transformation, von Landing Zones bis zur Anwendungsmodernisierung.
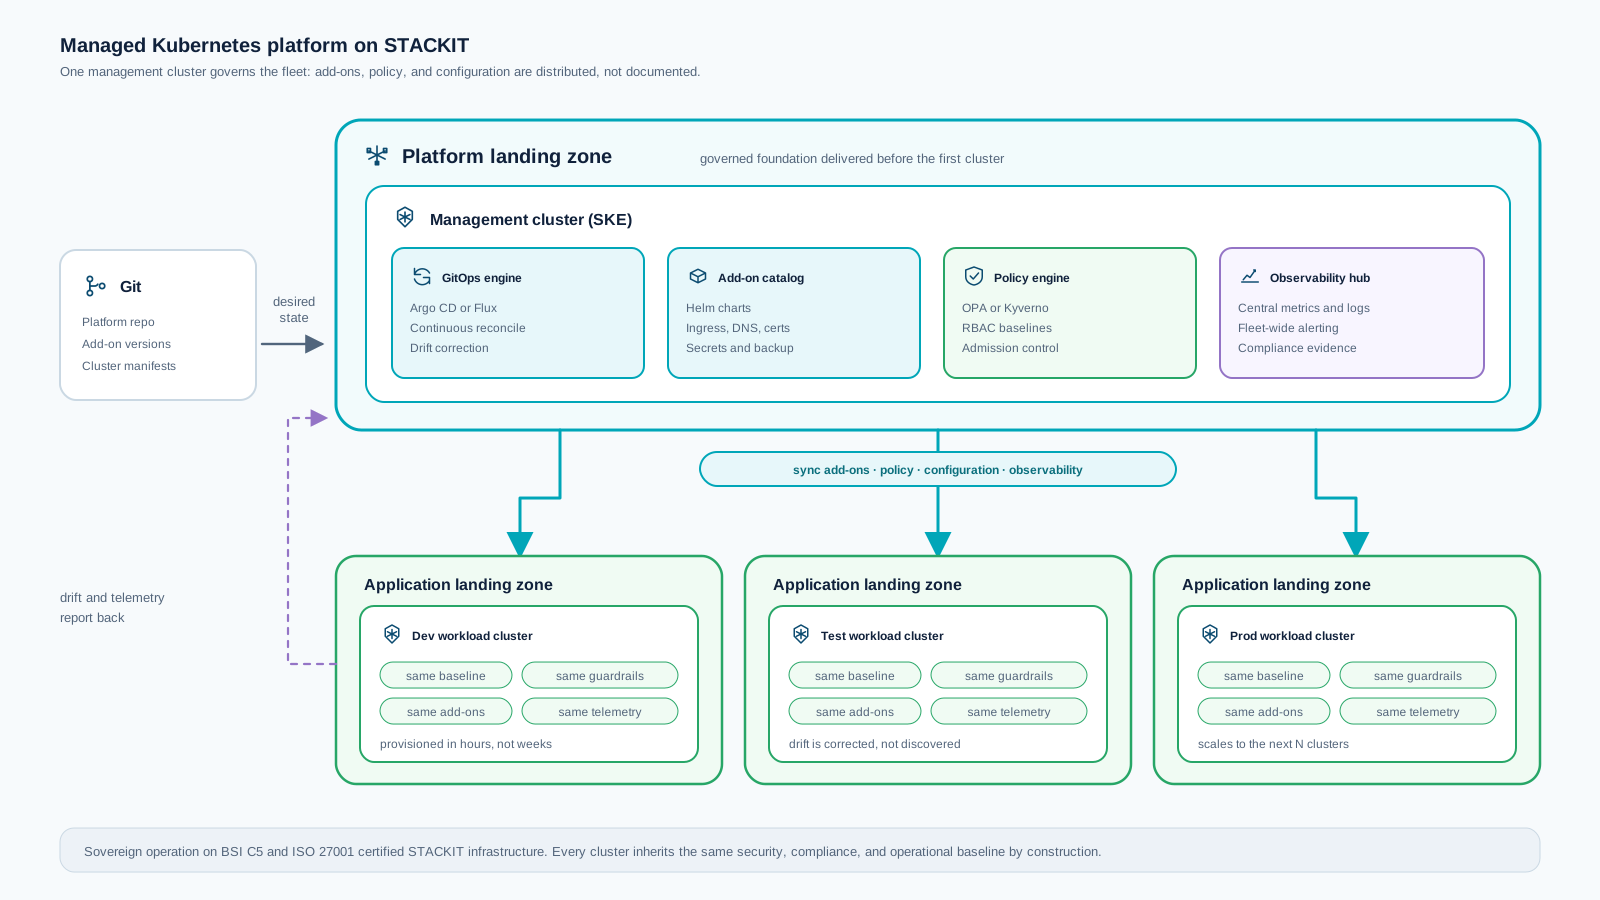
Das Management-Cluster wird in ein Landing-Zone-Projekt ausgerollt und dient als zentrale Control Plane für die Flotte. Für diese Phase sind etwa drei bis vier Wochen einzuplanen.
Ergebnis: Produktionsreifes Management-Cluster mit CI/CD und Governance-Tooling.
Argo CD oder Flux gleichen den gewünschten Zustand ab, und Crossplane erweitert denselben Loop auf STACKIT Ressourcen, sodass Netzwerke und Datenbanken neben den Workloads deklariert werden, die sie nutzen. Welche der beiden Engines Sie wählen, zählt deutlich weniger als die Festlegung auf eine und ein einheitliches Repository-Layout für die gesamte Flotte.
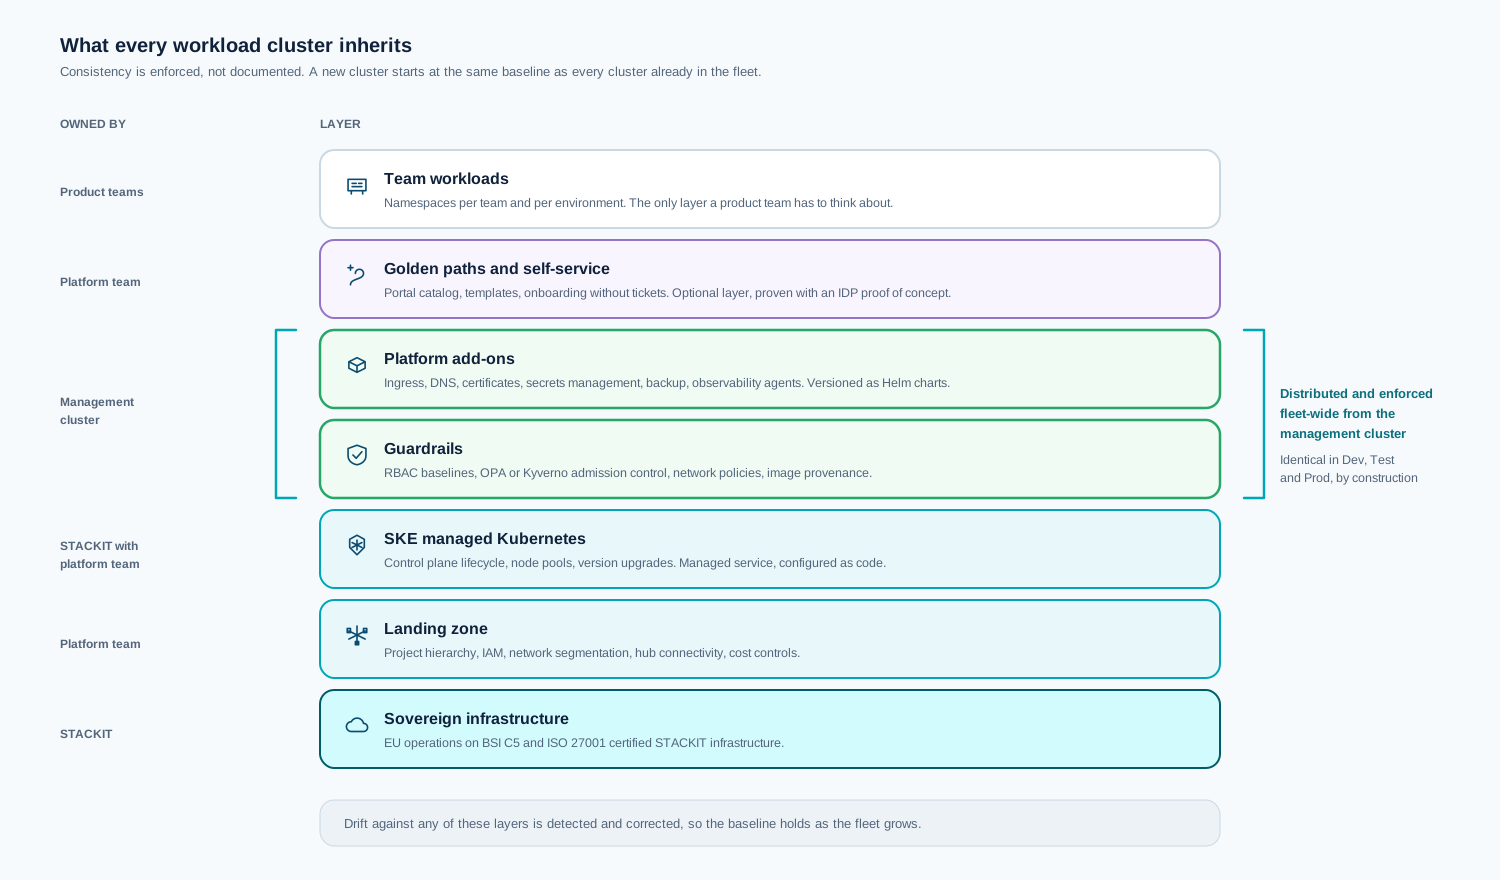
Legen Sie fest, was jedes Cluster erbt, bevor die Flotte existiert: RBAC-Baselines, Admission Control über OPA oder Kyverno, Network Policies und die Add-ons für Ingress, Secrets, Backup und Observability.
Die Leitplanken werden aus dem Management-Cluster verteilt und laufend abgeglichen. Dadurch ist die Baseline in Dev, Test und Prod identisch und bleibt es, während die Flotte wächst. Genau das macht den Betrieb nach BSI C5 und ISO 27001 zu einer Eigenschaft der Architektur statt zu einer Audit-Übung.
PRODYNA
Ein Beratungs- und Engineering-Unternehmen für die Umsetzung digitaler Transformation, von Landing Zones bis zur Anwendungsmodernisierung.
Die ersten Workload-Cluster für Dev, Test und Prod werden provisioniert, Add-ons und Konfiguration werden aus dem Management-Cluster synchronisiert. Dafür sind etwa zwei bis drei Wochen einzuplanen.
Ergebnis: Betriebsbereite Workload-Cluster mit aktiviertem Developer-Self-Service.
Ein Portal macht aus der Plattform einen Katalog: ein Team wählt ein Template und erhält ein Repository, eine Pipeline und einen Namespace mit bereits angewandter Baseline, ohne ein Ticket zu schreiben. Lohnt sich als kleiner Pilot während des Rollouts, statt es auf ein späteres Projekt zu verschieben.
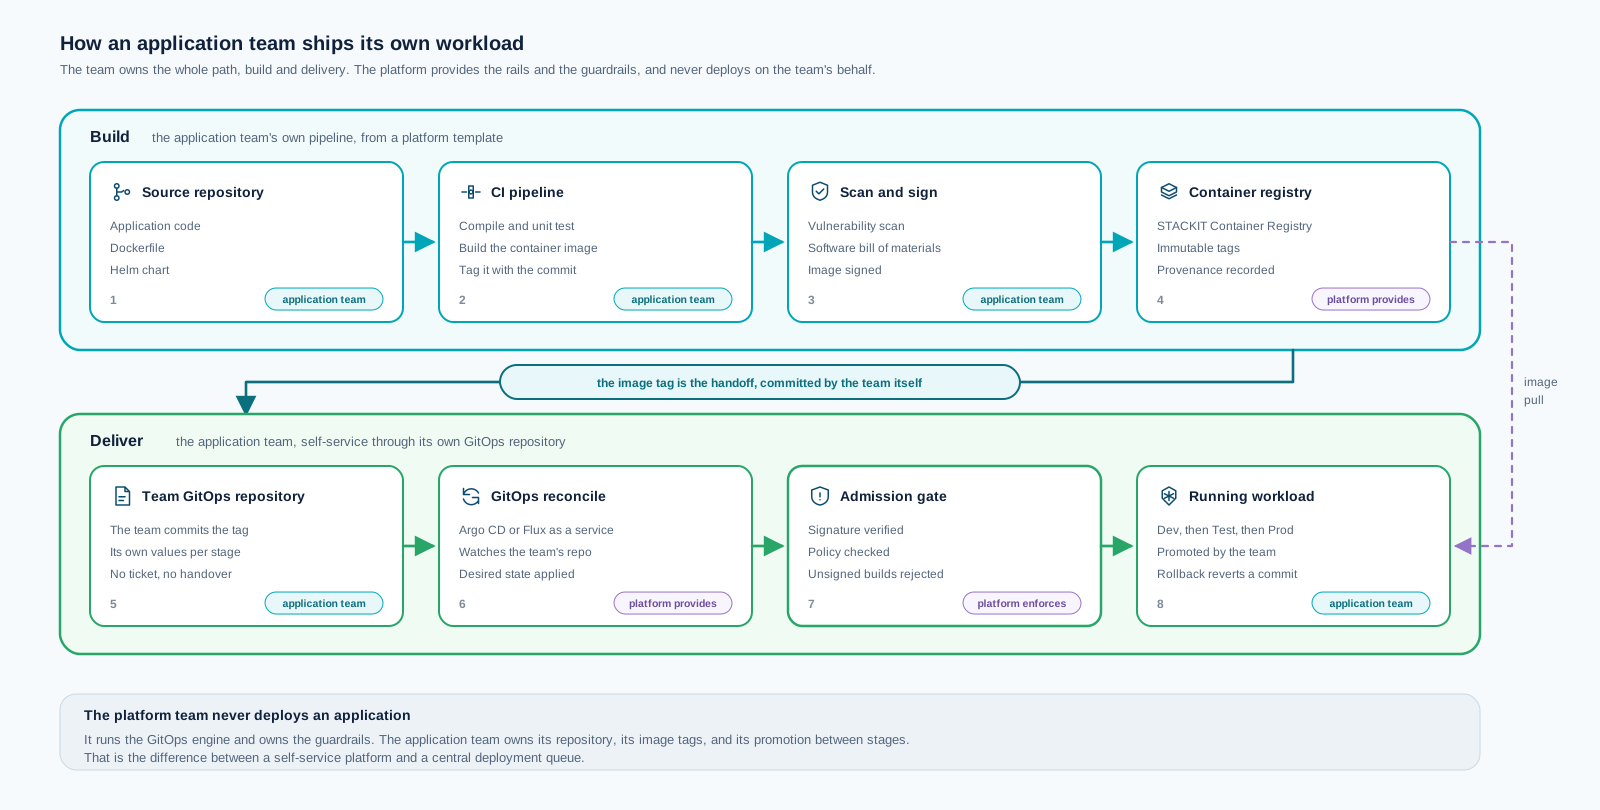
Eine Plattform beweist sich, wenn Workloads auf ihr laufen. Die erste Anwendung geht den kompletten Weg: in der CI gebaut und getestet, gescannt und signiert, in der Container Registry abgelegt und anschließend von derselben GitOps-Engine ins Cluster gebracht, die auch die Flotte regiert.
Der Image-Tag ist die Übergabe zwischen CI und GitOps, weshalb die Pipeline nie Cluster-Credentials braucht. Das Admission Gate weist alles Unsignierte oder nicht Konforme ab, bevor es einen Node erreicht. Die Promotion zwischen Dev, Test und Prod ändert Werte statt Manifeste, und ein Rollback ist ein zurückgenommener Commit statt eines manuellen Eingriffs. Sobald der erste Workload diesen Weg gegangen ist, erbt ihn jedes weitere Team als befestigte Straße.
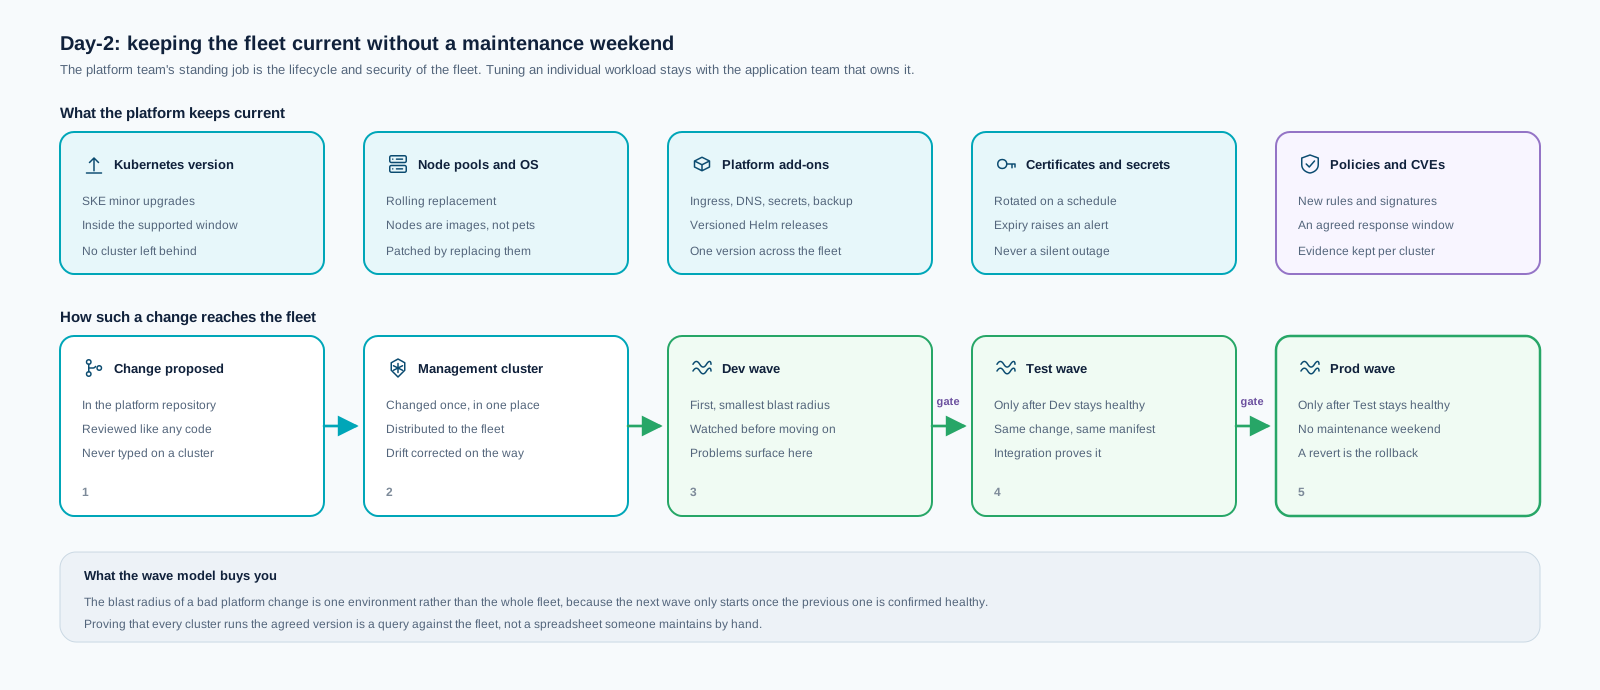
An Day-2 entscheidet sich, ob eine Plattform trägt. Die Daueraufgabe ist, die gesamte Flotte aktuell und nachweisbar gesund zu halten: Kubernetes-Versionen, Node-Images, Add-on-Releases, Zertifikatsrotation und das vereinbarte Reaktionsfenster für neue Policies und CVEs.
Jede dieser Änderungen wird einmal im Plattform-Repository gemacht und in Wellen ausgerollt, erst Dev, dann Test, dann Prod, wobei jede Welle davon abhängt, dass die vorherige gesund bleibt. Eine Welle, die nicht gesund hochkommt, stoppt den Rollout. Dadurch ist der Blast Radius einer schlechten Plattformänderung eine Umgebung statt der gesamten Flotte. Und der Nachweis, dass jedes Cluster auf der vereinbarten Version läuft, ist eine Abfrage gegen die Flotte statt einer handgepflegten Tabelle. Das Tuning einzelner Workloads steht bewusst nicht auf dieser Liste. Es gehört dem Applikationsteam, dem der Workload gehört.
PRODYNA
Ein Beratungs- und Engineering-Unternehmen für die Umsetzung digitaler Transformation, von Landing Zones bis zur Anwendungsmodernisierung.
Die Abschlussphase befähigt die internen Teams, die Plattform eigenständig zu betreiben. Dafür sind etwa zwei bis drei Wochen Wissenstransfer und Handover einzuplanen.
Ergebnis: Geschultes internes Team, das den gesamten Plattform-Lifecycle verantworten kann.