Replatform Spring Boot auf Cloud Foundry mit Autoscaling und Rightsizing optimieren
Zuletzt aktualisiert am
Szenario
Abschnitt betitelt „Szenario“Dieses Asset erweitert die Cloud-Foundry-Architektur-Baseline um ein Optimize-Runbook für Laufzeitverhalten unter Last.
- Architecture-Baseline: Architecture Asset: Spring Boot on Cloud Foundry with backing services
- Optimize-Ziel: Zuverlässigkeit und Kosteneffizienz verbessern und gleichzeitig ein vorhersagbares und reproduzierbares Skalierungsverhalten sicherstellen.
Terraform-first betriebsmodell
Abschnitt betitelt „Terraform-first betriebsmodell“Terraform ist die Standard-Steuerungsebene für Reproduzierbarkeit.
- Marketplace-Services per Terraform: PostgreSQL- und Autoscaler-Service-Instanzen werden mit
cloudfoundry_service_instanceerstellt. - Keine Script-Abhängigkeit: Der Deployment-Weg ist über Terraform-Ressourcen und Variablen definiert, nicht über Shell-Skripte.
- Environment-Strategie:
- dev/demo: standardmäßig Single-Pläne.
- prod: replica-fähige Pläne und Failover-Verhalten validieren.
Zweck und funktionsweise von autoscaling
Abschnitt betitelt „Zweck und funktionsweise von autoscaling“Der App AutoScaler hält die Anzahl der App-Instanzen an der realen Last ausgerichtet.
- Zweck: Service-Qualität unter Last stabil halten und gleichzeitig dauerhafte Überprovisionierung vermeiden.
- Funktionsweise: Ein Control-Loop bewertet Policy-Regeln (zum Beispiel Throughput, CPU, Memory, Zeitpläne) und passt die Anzahl der Instanzen innerhalb der definierten Grenzen an.
- Service-Modell: In Cloud Foundry wird App AutoScaler als Marketplace-Service genutzt und an die App gebunden.
Für Details zur Plattform und zur Policy-Mechanik nutze die Produktdokumentation:
Limits und operative grenzen
Abschnitt betitelt „Limits und operative grenzen“App AutoScaler verbessert Elastizität, bleibt aber an Plattform- und Org-Grenzen gebunden.
- Quota-Grenzen: Org- oder Space-Instanzquoten können Scale-out blockieren (
app_instance_limit_exceeded). - Plan-Grenzen: Der gewählte Autoscaler-Plan definiert verfügbare Fähigkeiten und praktische Limits.
- Metrik-Zeitfenster: Breach Duration und Cool-down verzögern Entscheidungen bewusst, um Oszillation zu vermeiden.
- Terraform-Grenze: Dieses Beispiel erstellt den Autoscaler-Service und setzt Policy-Parameter nativ über
cloudfoundry_service_credential_binding.
Hinweise zur Dashboard-Interpretation
Abschnitt betitelt „Hinweise zur Dashboard-Interpretation“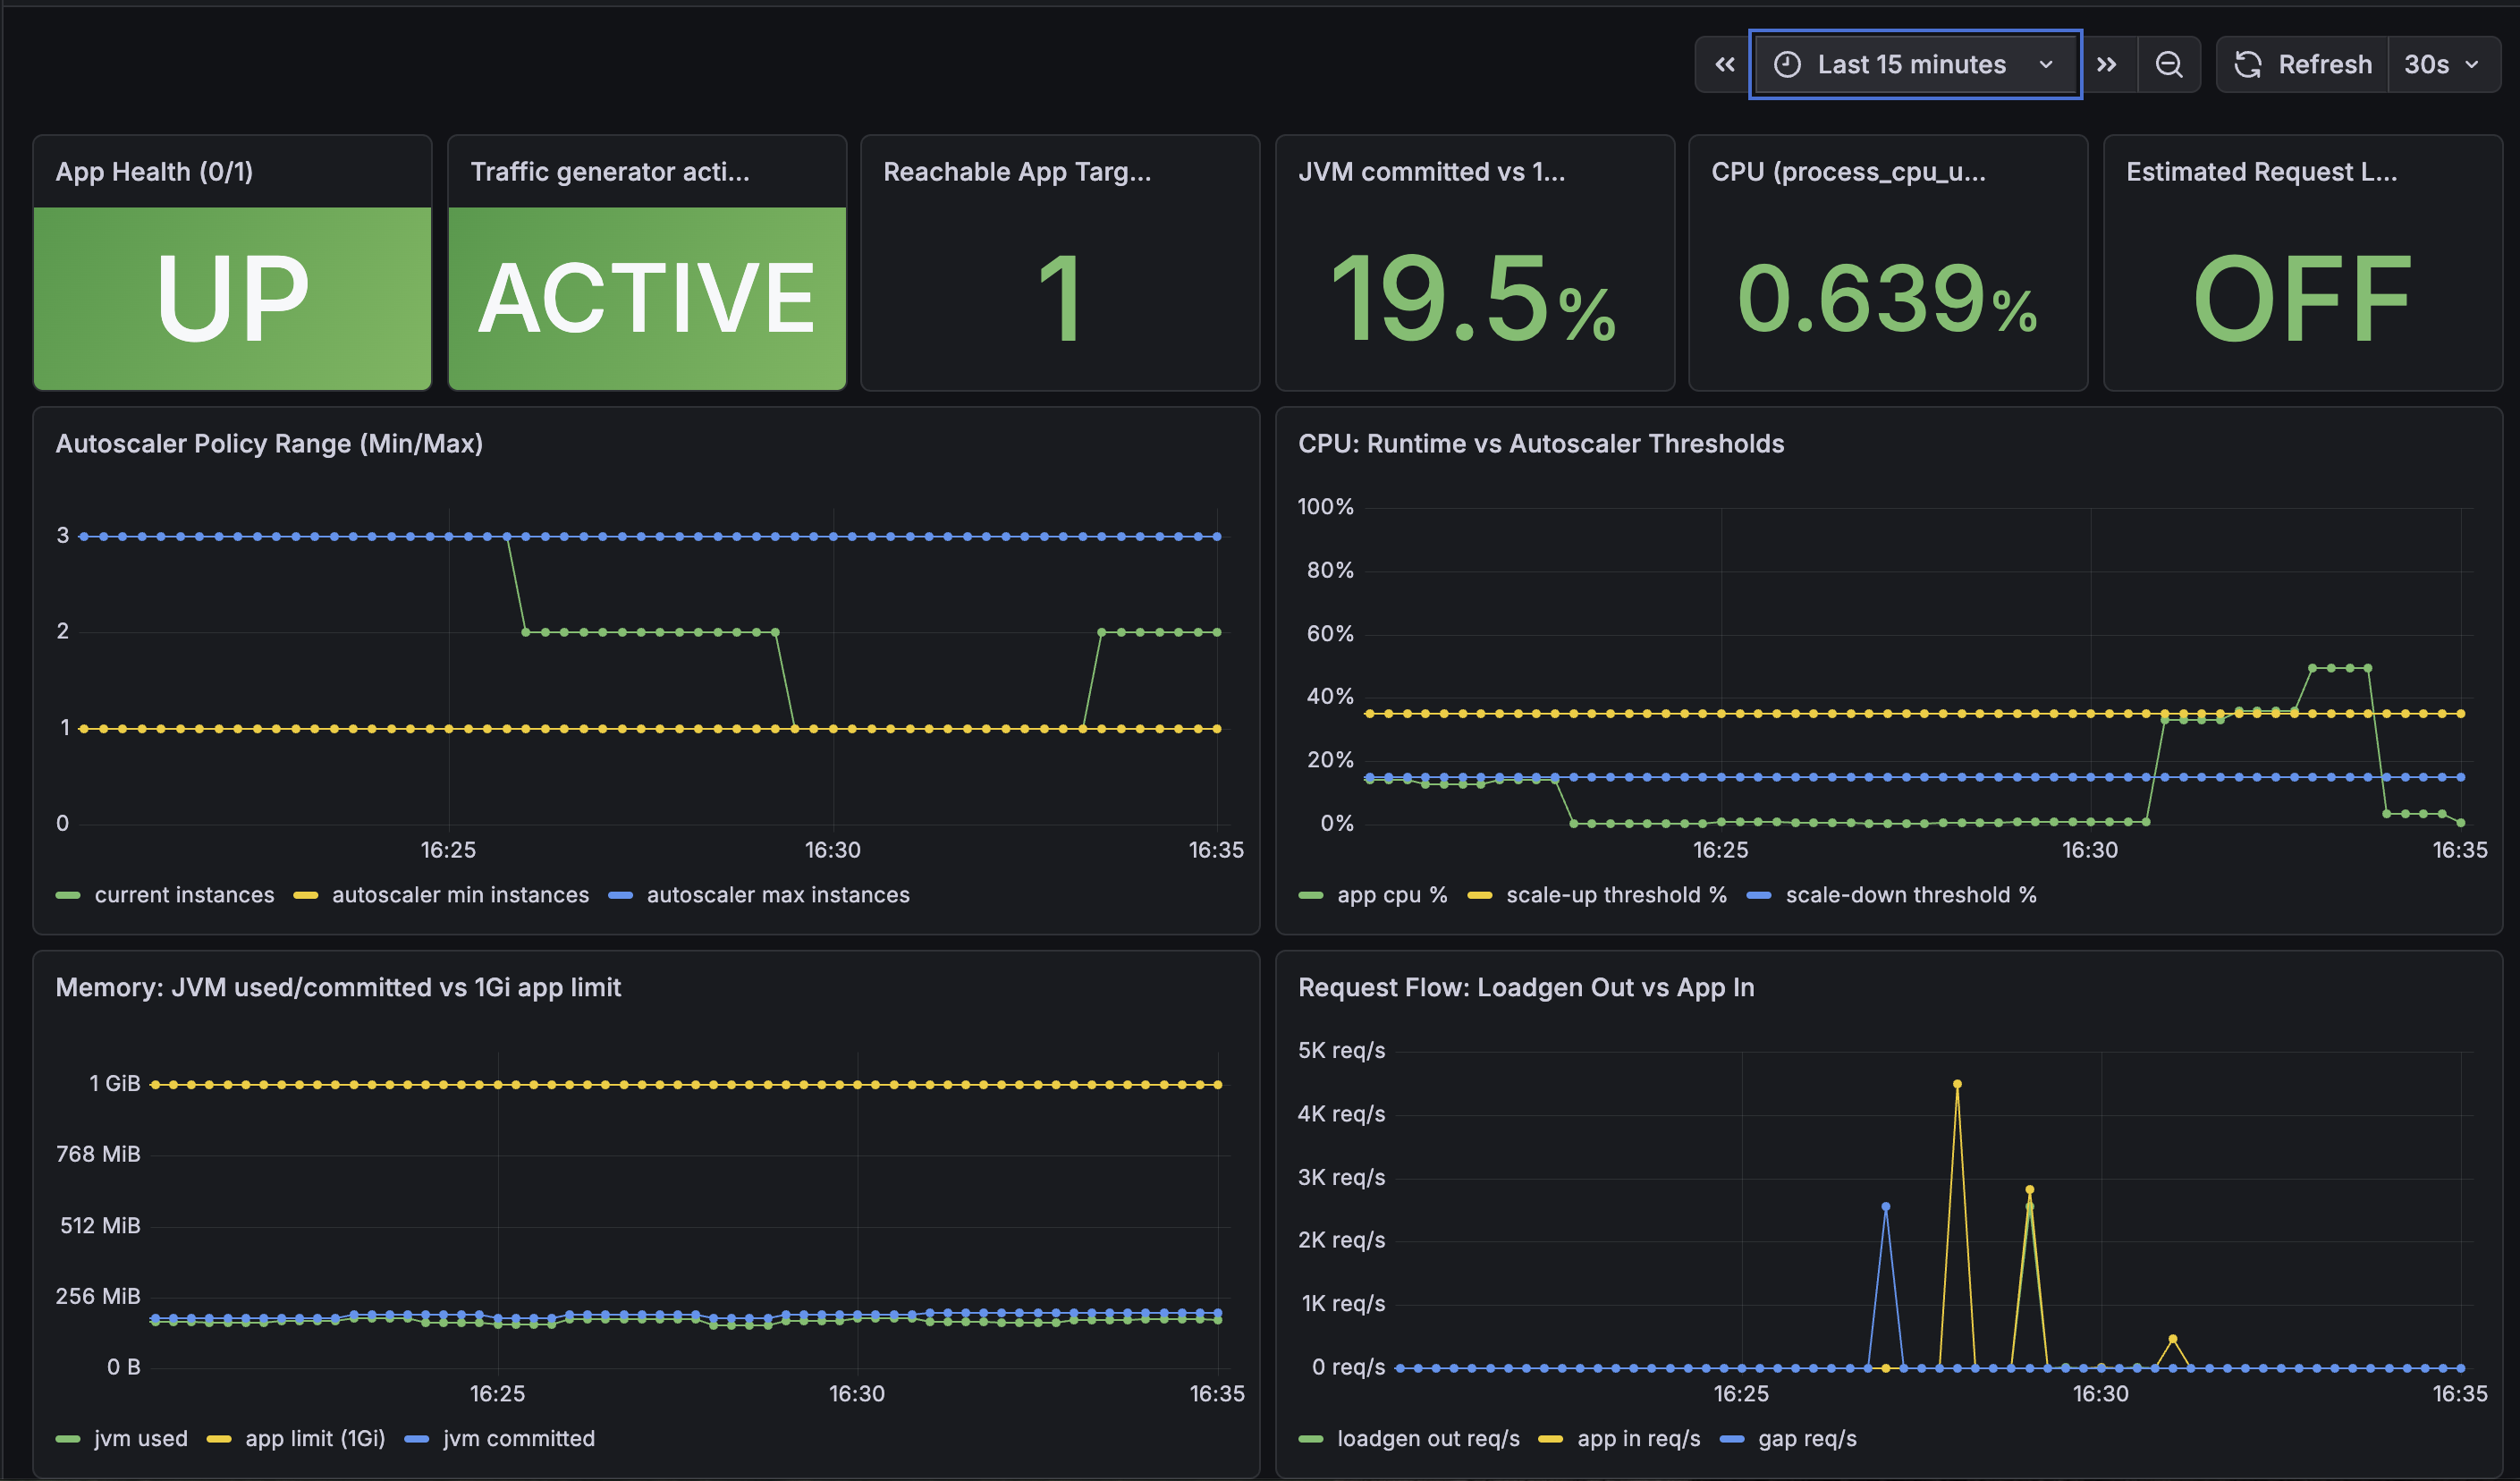
- App Health: Dieses Panel ist ein striktes Binärsignal aus
up{job="spring-music-metrics"}und zeigt nurUPoderDOWN. - Lastgenerator-Aktivität: Dieses Panel zeigt den Lastgenerator-Zustand (
ACTIVE/IDLE) und kannNO TRAFFIC GENERATOR METRICSanzeigen, wenn kein Lastgenerator-Scrape-Job vorhanden ist. - Reachable App Targets: Das ist ein Laufzeit-Proxy aus Scrape-Targets, nicht die verbindliche Anzahl der Cloud-Foundry-Prozesse.
- Autoscaler-Schwellenwerte: Linien für Min/Max-Instanzen und CPU-Schwellen sind konstante Policy-Werte und erscheinen als gerade Linien.
- Current-Instances-Panel: Für die aktuelle Anzahl laufender Instanzen wird die dedizierte Exporter-Metrik (
cf_app_current_instances) genutzt statt eines statischen Policy-Proxys. - Scrape-Takt: In diesem Setup läuft der dedizierte Instance-Exporter mit 60 s-Intervall, daher ist eine kurze Verzögerung in der Anzeige erwartbar.
- Cloud-Foundry-Runtime-Sicht: Für die verbindliche Anzahl der Prozesse und Laufzeit-Memory parallel mit
cf app <app-name>validieren.
Observability-signale für tuning
Abschnitt betitelt „Observability-signale für tuning“Nutze STACKIT Observability für datenbasierte Entscheidungen.
- Scale-out-Kandidat: anhaltender Throughput-Anstieg, erhöhte CPU oder steigende Latenz.
- Scale-in-Kandidat: stabil niedrige Last über das konfigurierte Quiet-Window.
- Sicherheitsleitplanke: keine offenen kritischen Alerts und keine Regression bei der Error-Rate.
Empfohlene autoscaling-policy
Abschnitt betitelt „Empfohlene autoscaling-policy“Nutze klare Schwellwerte und begrenzte Skalierung:
{ "instance_min_count": 1, "instance_max_count": 3, "scaling_rules": [ { "metric_type": "throughput", "breach_duration_secs": 60, "threshold": 80, "operator": ">=", "cool_down_secs": 60, "adjustment": "+1" }, { "metric_type": "cpu", "breach_duration_secs": 60, "threshold": 35, "operator": ">=", "cool_down_secs": 60, "adjustment": "+1" }, { "metric_type": "memoryused", "breach_duration_secs": 120, "threshold": 700, "operator": ">=", "cool_down_secs": 120, "adjustment": "+1" }, { "metric_type": "cpu", "breach_duration_secs": 120, "threshold": 15, "operator": "<", "cool_down_secs": 120, "adjustment": "-1" }, { "metric_type": "throughput", "breach_duration_secs": 120, "threshold": 20, "operator": "<", "cool_down_secs": 120, "adjustment": "-1" } ]}cpu- Kurzbezeichnung für “CPU utilization”, also die CPU-Auslastung Ihrer Anwendung in Prozent.memoryused- Absoluter Wert des verwendeten Speichers Ihrer Anwendung. Die Einheit der Metrikmemoryusedist “MB”.memoryutil- Kurzbezeichnung für “memory utilization”, also der prozentuale Anteil des verwendeten Speichers am insgesamt für die Anwendung zugewiesenen Speicher. Beispiel: Bei 100 MB Nutzung und 200 MB Speicher-Quota beträgtmemoryutil50%.responsetime- Durchschnittliche Zeit, welche die Anwendung in einem bestimmten Zeitraum zur Beantwortung einer Anfrage benötigt. Die Einheit vonresponsetimeist “ms” (Millisekunden).throughput- Gesamtzahl verarbeiteter Anfragen in einem bestimmten Zeitraum. Die Einheit vonthroughputist “rps” (Requests per second).- Benutzerdefinierte Metrik - Sie können einen eigenen Metriknamen definieren und eigene Metriken an den App AutoScaler senden, um weitere dynamische Skalierung auszulösen. Für gültige Metriknamen sind nur Buchstaben, Zahlen und ”_” erlaubt; die maximale Länge beträgt 100 Zeichen.
Was ist das?
Dieser Abschnitt wird mehrmals am Tag automatisch aus der STACKIT-Doku übernommen. Hier lässt er sich nicht ändern. Änderungen gehören in die STACKIT-Doku.
Last-validierungsablauf
Abschnitt betitelt „Last-validierungsablauf“- Stack mit Terraform ausrollen und prüfen, dass die Route
200liefert. - Repräsentative Burst-Last mit einem dedizierten load generator erzeugen.
- Last lange genug halten, um die Scale-out-Bedingung sicher zu triggern.
- Last stoppen und Scale-in nach Quiet-Window und Cool-down prüfen.
- Applikations-Logs und Autoscaling-Historie auf sauberes Verhalten prüfen.
Terraform-schalter für dedizierte loadgen-app
Abschnitt betitelt „Terraform-schalter für dedizierte loadgen-app“Nutze für reproduzierbare Lastprüfungen eine zweite, von Terraform verwaltete Loadgen-App.
- Aktivieren:
setup_loadgen_app = true,loadgen_enabled = true,loadgen_mode = "cf-app" - Deaktivieren:
setup_loadgen_app = false - Lastprofil steuern:
loadgen_parallel_requests,loadgen_burst_seconds,loadgen_idle_seconds
Beispiel:
setup_loadgen_app   = trueloadgen_enabled     = trueloadgen_mode        = "cf-app"loadgen_app_name    = "spring-music-loadgen"
loadgen_instances         = 3loadgen_parallel_requests = 60loadgen_burst_seconds     = 180loadgen_idle_seconds      = 480loadgen_inner_sleep_seconds = 0
Aktuelle provider-grenze und freigabe-regel
Abschnitt betitelt „Aktuelle provider-grenze und freigabe-regel“Die Autoscaler-Marketplace-Service-Instanz ist vollständig per Terraform abgedeckt.
Policy-Parameter werden in dieser Implementierung ebenfalls nativ über cloudfoundry_service_credential_binding gesetzt.
- Terraform ist der primäre Weg für Änderungen an Schwellwerten.
- Manuelle CLI/API-Policy-Änderungen bleiben nur ein Notfallweg und müssen anschließend sofort in Terraform rückgeführt werden.