Rehost Spring Boot mit Observability und VM-Rightsizing optimieren
In 2 TrailsZuletzt aktualisiert am
Dieselbe Referenzimplementierung fortsetzen
Abschnitt betitelt „Dieselbe Referenzimplementierung fortsetzen“Dieses Asset führt dieselbe Spring-Boot- und PostgreSQL-Referenzimplementierung fort, die für Provisioning, Migration, Cutover und Stabilisierung verwendet wurde. Es führt kein weiteres Beispiel oder Repository ein. Die vorhandenen Terraform-Variablen, Ansible-Konfiguration, Observability-Instanz und Validierungsworkflows bleiben die technische Baseline für Optimize.
Die Optimize-Erweiterung beantwortet eine praktische Frage: Wie lassen sich Über- oder Unterprovisionierung erkennen und VM- oder Storage-Kapazität anschließend über einen kontrollierten IaC-Workflow ändern?
STACKIT CMF Rehost Spring Boot Repository Arbeiten Sie mit derselben Terraform- und Ansible-Referenzimplementierung weiter, die in den vorherigen Rehost-Migrationsschritten verwendet wurde. Repository öffnen Rehost-Implementierungs-AssetObservability-Setup für die Optimierung
Abschnitt betitelt „Observability-Setup für die Optimierung“Nutze den managed STACKIT Observability -Stack als Datenquelle.
- Prometheus: Metrik-Erfassung
- Thanos: Langfristige Aufbewahrung von Metriken
- Grafana Loki: Log-Analyse
- Grafana Tempo: Distributed Traces
- Grafana: Dashboards und Visualisierung
Architektur-Referenzen:
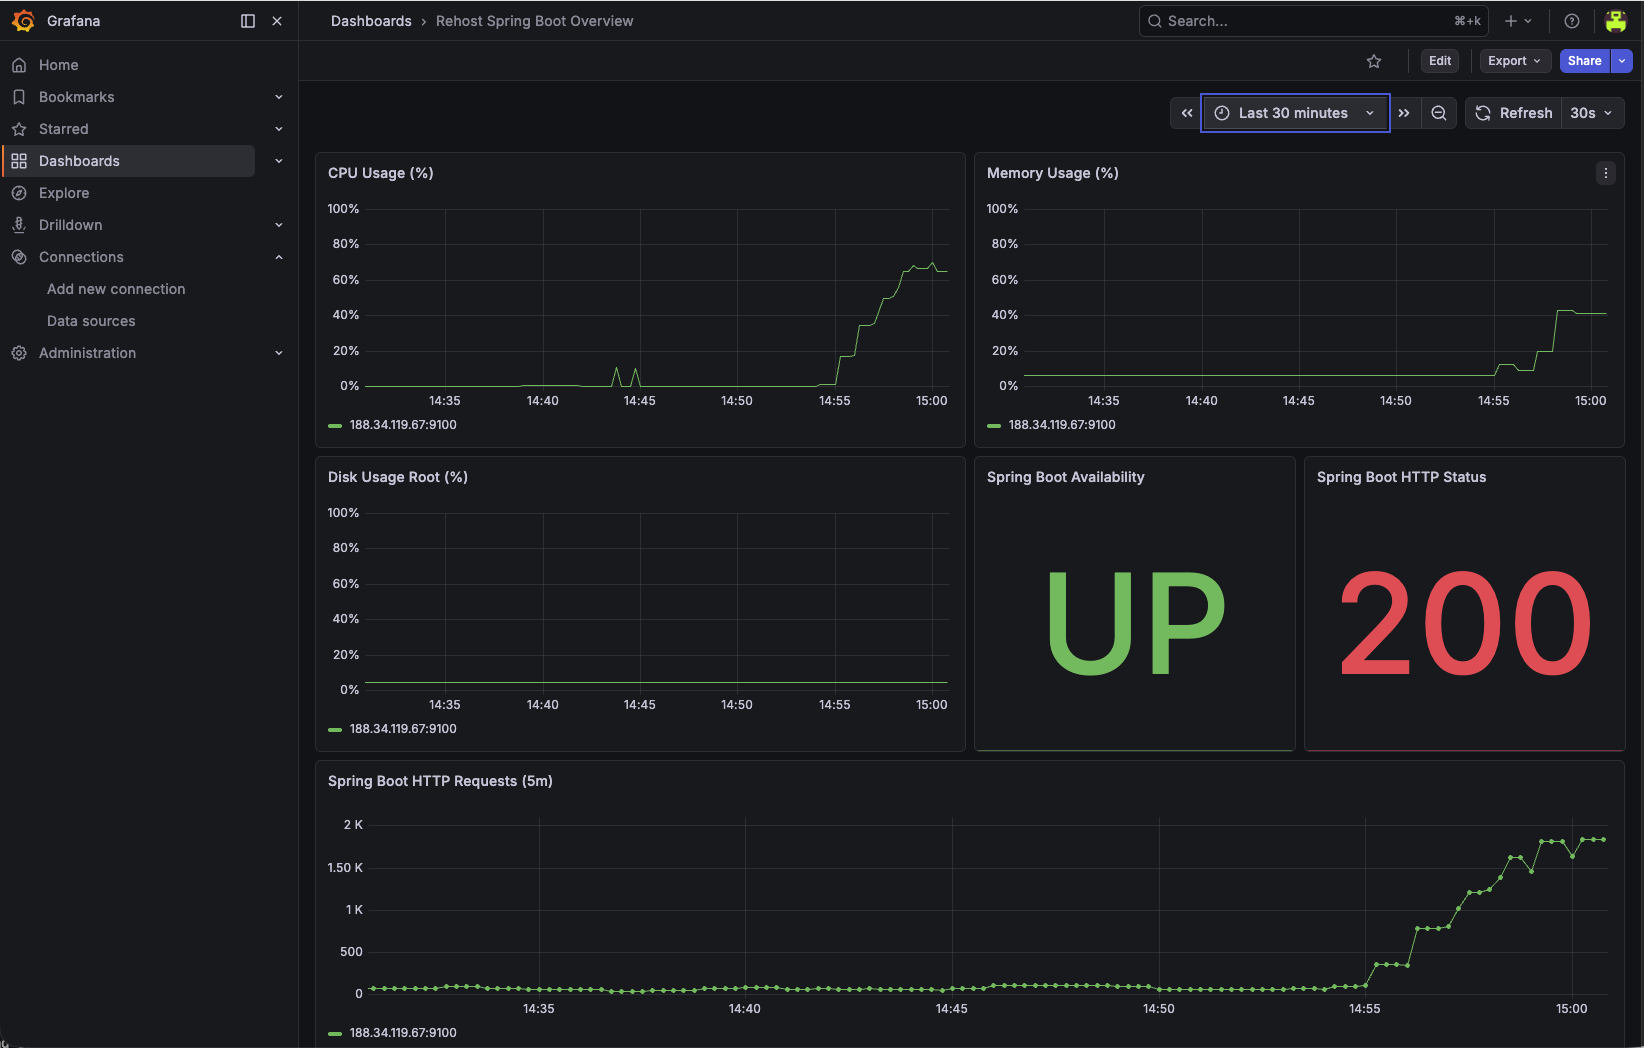
Observability-Entscheidungsdashboard
Abschnitt betitelt „Observability-Entscheidungsdashboard“Nutze das Dashboard, um Infrastruktur-Auslastung, Anwendungszustand, Request-Verhalten und Alert-Historie gemeinsam zu bewerten, bevor die VM-Kapazität geändert wird.
Signale und Schwellwerte für Rightsizing
Abschnitt betitelt „Signale und Schwellwerte für Rightsizing“Definiere technische Schwellwerte, bevor du Kapazität änderst.
- Kandidat für Downsize: CPU p95 unter 30% und Memory p95 unter 50% für mindestens 14 Tage.
- Kandidat für Scale-up: CPU p95 über 75% oder Memory p95 über 80% während Business-Lastfenstern für mindestens drei Tage in Folge.
- Stabilitäts-Guardrail: Keine offenen kritischen Alerts und keine Regression in der Error-Rate-SLO.
Halte Schwellwerte workload-spezifisch und validiere sie gegen reale Traffic-Muster.
Datenbank Sicht für Optimize Entscheidungen
Abschnitt betitelt „Datenbank Sicht für Optimize Entscheidungen“Für stateful Rehost-Workloads sollten Signale aus der Datenbank im selben Dashboard-Zyklus bewertet werden.
- Verbindungen: Trend aktiver Verbindungen und Verhalten bei Lastspitzen.
- Datenbank Größe: Entwicklung der Datenbankgröße über die Zeit.
- Transaktionen: Commit-/Rollback-Trends zur Stabilitätsbewertung.
Nutze diese Signale gemeinsam mit VM-Metriken, damit Optimize-Entscheidungen nicht nur auf CPU oder Memory basieren.
PostgreSQL Flex im späteren Optimize-Pfad
Abschnitt betitelt „PostgreSQL Flex im späteren Optimize-Pfad“Wenn der Rehost-Workload den Datenbank-Layer später auf PostgreSQL Flex umstellt, sollte DB-Rightsizing in denselben Optimize-Loop aufgenommen werden.
- Ziel-Instanz planen: PostgreSQL-Flex-Instanz planen
- Flavor und Performance-Klasse abstimmen: Flavors und Performance-Klassen von PostgreSQL Flex
- Integriertes Dashboard für schnelle Prüfung: Dashboard-Metriken
- Observability-Metriken für Analyse im Detail: Observability-Metriken
Rightsizing-Workflow
Abschnitt betitelt „Rightsizing-Workflow“- Baseline-Metriken und Traces für einen repräsentativen Zeitraum erfassen.
- Optimize-Kandidat mit Dashboards und Alert-Historie bestätigen.
- Kapazitätsänderung und Rollback-Checkpoint planen.
- VM-Größe per Terraform/OpenTofu anpassen.
- Latenz, Error-Rates, Durchsatz und Kosten erneut validieren.
- Behalten oder zurückrollen anhand objektiver Kriterien.
Praktisches Beispiel
Abschnitt betitelt „Praktisches Beispiel“Beispiel A: Downsize nach dauerhaft niedriger Auslastung
Abschnitt betitelt „Beispiel A: Downsize nach dauerhaft niedriger Auslastung“Passe die VM-Größe in env.tfvars an:
machine_type = "g3i.2"Apply und Plan-Ausgabe prüfen:
terraform plan -var-file=env.tfvarsterraform apply -var-file=env.tfvarsDanach validieren:
- Service-Health (
systemctl status, synthetische Checks) - p95-Latenz und Error-Rate-Trend
- Kosten-Differenz im Reporting-Zeitraum
Beispiel B: Scale-up bei dauerhaft hoher Last
Abschnitt betitelt „Beispiel B: Scale-up bei dauerhaft hoher Last“Passe die VM-Größe in env.tfvars an:
machine_type = "g3i.4"Apply durchführen und mit denselben Post-Change-Checks validieren.
Rollback-Muster
Abschnitt betitelt „Rollback-Muster“Wenn sich SLOs nach dem Rightsizing verschlechtern, rolle zurück, indem du den vorherigen machine_type wiederherstellst und IaC erneut ausführst.
Behandle Rollback als regulären Runbook-Schritt und nicht nur als Notfallweg.
Hinweise
Abschnitt betitelt „Hinweise“- Abhängig von Plattform-Constraints und Machine Type kann ein Resize einen Neustart oder Ersatz der VM auslösen. Prüfe das Verhalten vorab in
terraform plan.
Storage als Optimierungsaspekt
Abschnitt betitelt „Storage als Optimierungsaspekt“In Rehost-Szenarien sind CPU und Memory nur eine Seite des Rightsizing. Auch Storage-Performance kann zum Engpass werden.
- Wann Storage prüfen: erhöhte I/O-Wait-Werte, instabile Latenz bei schreibintensiver Last oder Throughput-Sättigung trotz freier CPU.
- Was auswählen: Storage-Service-Plan und Performance-Klasse passend zum beobachteten IOPS- und Durchsatzprofil.
- Guidance: Block Storage Service Plans
Performance-Klasse vor dem Provisioning auswählen
Abschnitt betitelt „Performance-Klasse vor dem Provisioning auswählen“Eine Block-Storage-Performance-Klasse definiert die maximalen IOPS und den maximalen Durchsatz für das gesamte Volume. Zugriffe von Anwendung, Datenbank, Betriebssystem und Backup teilen dieses Performance-Budget. Wählen Sie die Klasse vor dem Erstellen des Volumes anhand gemessener Lastspitzen, Latenzanforderungen, Backup-Aktivität und expliziter Wachstumsreserve.
Die folgende Tabelle listet die derzeit verfügbaren Leistungs-Klassen für die Region EU01 auf:
| Leistungs-Klasse | Name | Max. IOPS | Max. Durchsatz (MB/s) |
|---|---|---|---|
| Leistungs-Klasse 0 | storage_premium_perf0 | 120 | 25 |
| Leistungs-Klasse 1 | storage_premium_perf1 | 500 | 50 |
| Leistungs-Klasse 2 | storage_premium_perf2 | 1000 | 100 |
| Leistungs-Klasse 4 | storage_premium_perf4 | 2000 | 150 |
| Leistungs-Klasse 6 | storage_premium_perf6 | 5000 | 200 |
| Leistungs-Klasse 8 | storage_premium_perf8 | 10000 | 250 |
| Leistungs-Klasse 10 | storage_premium_perf10 | 15000 | 300 |
| Leistungs-Klasse 12 | storage_premium_perf12 | 20000 | 350 |
| Leistungs-Klasse 13 | storage_premium_perf13 | 20000 | 700 |
| Leistungs-Klasse 14 | storage_premium_perf14 | 25000 | 400 |
| Leistungs-Klasse 15 | storage_premium_perf15 | 25000 | 800 |
| Leistungs-Klasse 16 | storage_premium_perf16 | 30000 | 450 |
| Leistungs-Klasse 17 | storage_premium_perf17 | 30000 | 900 |
| Leistungs-Klasse 18 | storage_premium_perf18 | 35000 | 500 |
| Leistungs-Klasse 19 | storage_premium_perf19 | 35000 | 1000 |
| Leistungs-Klasse 20 | storage_premium_perf20 | 40000 | 550 |
| Leistungs-Klasse 21 | storage_premium_perf21 | 40000 | 1100 |
IOPS – Input/Output Operations per second (Ein-/Ausgabebefehle pro Sekunde)
Durchsatz – Durchsatz in Megabyte pro Sekunde
Somit lassen sich die verwendeten Klassen anhand der Namensgebung im Detail unterscheiden. Beispiel: „Block Storage Premium – Leistungs-Klasse 2“ entspricht SSD-Festplatten mit max. 1000 IOPS und max. 100 Mbyte/s Durchsatz.
Was ist das?
Dieser Abschnitt wird mehrmals am Tag automatisch aus der STACKIT-Doku übernommen. Hier lässt er sich nicht ändern. Änderungen gehören in die STACKIT-Doku.
In der Rehost-Baseline teilen sich Betriebssystem, Spring-Boot-Anwendung und PostgreSQL-Daten das Boot Volume. Eine Änderung der Performance-Klasse erfordert daher ein kontrolliertes Ersatzziel:
- Wählen Sie die neue Klasse anhand beobachteter IOPS, Durchsatz-, Latenz- und I/O-Wait-Werte.
- Prüfen Sie die Bereitschaft für Backup und Datenbank-Rollback.
- Stellen Sie Ersatz-VM und Boot Volume mit der gewählten Klasse über IaC bereit.
- Wenden Sie die Ansible-Konfiguration erneut an und stellen oder migrieren Sie die Workload-Daten wieder her.
- Validieren Sie vor der Umschaltung Applikationsverhalten, Datenintegrität, Storage-Latenz, Backup-Abdeckung und Kosten.
Verwenden Sie ein separates Data Volume, wenn Storage-Kapazität oder -Performance unabhängig vom VM-Lifecycle weiterentwickelt werden müssen. Erstellen Sie für eine andere Performance-Klasse ein neues Volume im erforderlichen Verfügbarkeitsmodell mit ausreichender Kapazität, stoppen Sie Schreibzugriffe, migrieren und verifizieren Sie die Daten, wechseln Sie Attachment oder Mount und bewahren Sie das Quell-Volume auf, bis Abnahme- und Rollback-Gates passiert sind.
Daten aus Block Storage migrierenBehandeln Sie Storage-Prüfungen als Teil derselben Optimize-Schleife und validieren Sie nach jeder Änderung erneut Latenz, Fehlerverhalten, Recovery und Kostenwirkung.