Teams neu strukturieren
Das Modell von stromorientierten Teams mit echter operativer Verantwortung — und wie ein Platform-Engineering-Team alle anderen befähigt, ohne zum Engpass zu werden.
Zuletzt aktualisiert am


Eine Migration entfaltet ihre Wirkung erst mit modernisierten Betriebs- und Prozessstrukturen: von ITIL über You-Build-It-You-Run-It bis zu DORA-Kennzahlen.
Einführung in das Cloud-native Betriebsmodell und die Analyse finanzieller Risiken bei ausbleibender Transformation.
Cloud-Technologie ändert nicht automatisch die Art und Weise, wie Ihre Organisation Software entwickelt und betreibt. Viele Organisationen haben nach der Migration die gleichen langen Deployment-Zyklen, die gleichen Silos zwischen Entwicklung und Betrieb, die gleichen manuellen Prozesse — jetzt eben in der Cloud.
Dieses Kapitel befasst sich mit den organisatorischen Veränderungen, die die Cloud effektiv machen: wie Teams strukturiert sind, wie Verantwortung verteilt ist, wie Change Management und Incident Response an die Cloud-Geschwindigkeit angepasst werden — und wie zu messen ist, ob die Transformation tatsächlich stattgefunden hat.
Teams neu strukturieren
Das Modell von stromorientierten Teams mit echter operativer Verantwortung — und wie ein Platform-Engineering-Team alle anderen befähigt, ohne zum Engpass zu werden.
Infrastructure as Code
Warum das Klicken in die Konsole nicht mehr der Standard sein darf — und wie Infrastructure as Code gleichzeitig Reproduzierbarkeit, Sicherheit und Geschwindigkeit liefert.
ITIL an Cloud-Geschwindigkeit anpassen
Welche Change-Management-Prozesse in der Cloud anders ablaufen müssen — und wie man Standard Changes definiert, damit Compliance und Agilität keine Gegensätze sind.
Erfolge messen
Die vier DORA-Kennzahlen als objektive Messgröße der Lieferperformance — mit Richtwerten und einer realistischen Verbesserungs-Roadmap.
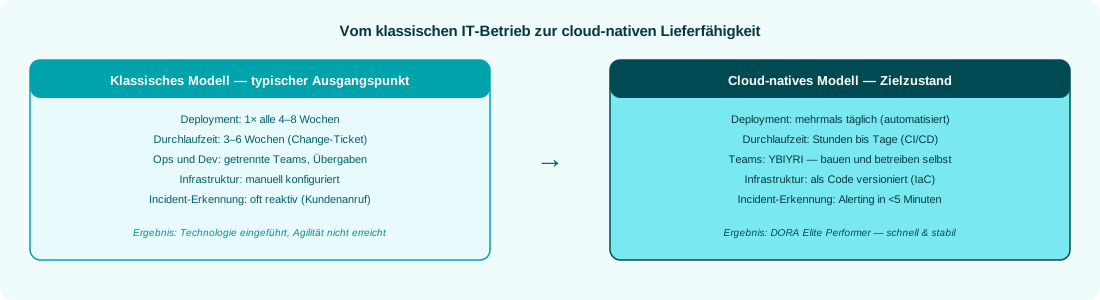
Ein Finanzdienstleister hat in acht Monaten 40 Workloads auf STACKIT migriert. Technisch ein Erfolg. Organisatorisch eine ernüchternde Erfahrung.
Deployment-Zyklen: immer noch sechs Wochen. Nicht, weil die Technologie zu langsam wäre — sondern weil der Change-Management-Prozess weiterhin jeden Patch durch ein dreiköpfiges CAB-Gremium leitete.
Manuelle Konfiguration: weiterhin über die Konsole. Nicht, weil kein IaC-Tool zur Verfügung stand — sondern weil niemand es gelernt hatte und niemand die Zeit dafür bekam.
Kosten: 60 % höher als budgetiert. Nicht, weil STACKIT teuer ist — sondern weil kein Team Verantwortung für seinen Cloud-Kostenanteil übernommen hat.
420.000 Euro an jährlichen Mehrkosten. Die Migration war erfolgreich. Die Transformation war fehlgeschlagen.
Die Cloud-Transformation schafft neue Rollen und ändert bestehende. Systemadministratoren werden zu Platform Engineers. Infrastrukturteams werden zu DevOps-Teams. Manche Rollen, die es heute gibt, werden in drei Jahren nicht mehr benötigt — zumindest nicht in ihrer jetzigen Form.
Diese Realität offen zu kommunizieren und aktiv mitzugestalten — mit klaren Qualifizierungspfaden, fairen Übergangsprozessen und dem Betriebsrat als Partner — ist nicht nur moralisch geboten. Es ist strategisch notwendig. Wer diese Gespräche nicht führt, verliert genau die Personen, die für die Transformation am dringendsten benötigt werden.
Das Kapitel DevOps & YBIYRI adressiert dies mit konkreten Teamtopologien und Rollenübergängen.
Die Anpassung der Betriebsmodelle setzt Cloud Empowerment voraus — Teams benötigen die Fähigkeit, neue Arbeitsweisen zu praktizieren.
Stufenweise Einführung des "You Build It, You Run It"-Prinzips (Pilot-Team, Expansion, Full Adoption) zur Vermeidung operativer Flaschenhälse.
Im klassischen IT-Modell gibt es eine strukturelle Übergabe: Entwickler bauen eine Applikation und übergeben sie an den Betrieb. Operations deployt, überwacht und repariert.
Durch diese Übergabe entstehen systematisch drei Probleme:
Reibungs- und Wartezeiten: Jeder Wechsel durchläuft einen Übergabeprozess. Was technisch fertig ist, wartet auf die Kapazität des operativen Teams.
Unklare Verantwortlichkeit: Wenn eine Applikation in der Produktion ausfällt, stellt sich zunächst die Frage: Liegt es am Code oder an der Infrastruktur? Diese Frage kostet Zeit — die besonders im Incident wertvoll ist.
Unterschiedliche Prioritäten: Entwicklungsteams wollen neue Features ausliefern. Betriebsteams wollen Stabilität. Diese Interessen stehen strukturell im Konflikt, solange sie in unterschiedlichen Teams sitzen.
YBIYRI (You Build It You Run It) löst alle drei Probleme durch eine einfache Verschiebung: Das Team, das eine Anwendung baut, betreibt sie auch in der Produktion. Volle Verantwortung, volle Kompetenz.
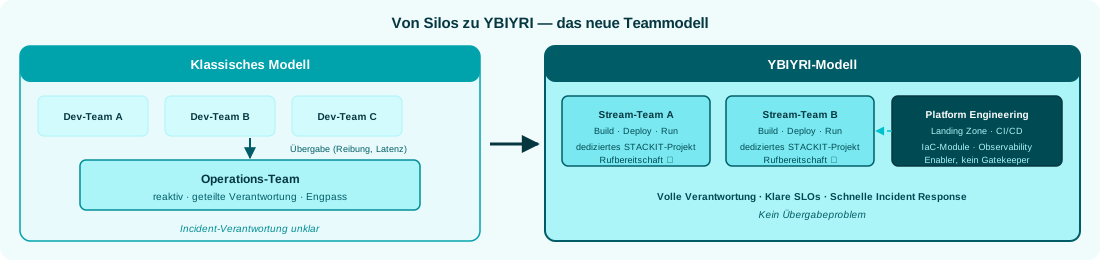
Stream-orientierte Teams sind vollumfänglich für einen Service oder ein Produkt verantwortlich — von der Entwicklung bis zum Produktionsbetrieb:
Diese vollständige Eigenverantwortung ist der Kern von YBIYRI. Sie verändert die Denkweise: Eine Person, die weiß, dass sie nachts geweckt wird, wenn die Anwendung ausfällt, baut sie anders auf.
Das Platform-Engineering-Team (oft aus dem CCoE hervorgegangen) ist kein Ops-Team im klassischen Sinne. Es baut und betreibt die interne Plattform, die allen stromorientierten Teams das Leben erleichtert:
Das Plattform-Team ist kein Freigabegremium, sondern ein Enabler. Stream-orientierte Teams sollten in der Lage sein, ihre Arbeit zu erledigen, ohne für jedes Infrastrukturthema ein Ticket zu erstellen.
YBIYRI ist als Konzept attraktiv — scheitert aber, wenn die organisatorischen Voraussetzungen fehlen.
Gute Beobachtbarkeit
Kein Team kann einen Service betreiben, den es nicht sieht. Vor der Einführung von YBIYRI muss die Observability-Plattform vorhanden sein: Dashboards, Alerts, Runbooks.
Automatisierte Deployments
Bereitschaftsteams können um 2 Uhr morgens nicht manuell deployen. Automatisierte, reproduzierbare Deployments über CI/CD sind Voraussetzung — kein Nice-to-have.
Klare Service Level Objectives
SLOs definieren, wann ein Incident wirklich kritisch ist. Ohne diese Klarheit weckt jede kleine Anomalie jemanden. Mit SLOs erfolgt eine Eskalation nur, wenn ein Ziel gefährdet ist.
Psychologische Sicherheit
Teams übernehmen keine echte Verantwortung, wenn Fehler bestraft werden. Grundvoraussetzung ist eine Kultur, in der Vorfälle als Lerngelegenheiten behandelt werden (Blameless Post-Mortem).
Faire Bereitschaftsvergütung
YBIYRI ohne fairen Ausgleich der Rufbereitschaft führt zu Burnout und zum Verlust der besten Mitarbeitenden. Bereitschaft muss klar geregelt und angemessen vergütet werden — vor der Einführung, nicht danach.
Ausreichende Teamgröße
Ein dreiköpfiges Team kann keine gesunde Rotation der Rufbereitschaft aufrechterhalten. YBIYRI erfordert, dass die Teams groß genug sind (in der Regel 5–8 Personen), um die Rufbereitschaft zu verteilen.
SLOs (Service Level Objectives) sind die schriftliche Zusage eines Teams zu seinem Service. Sie beantworten: Was ist für uns „gut genug“ — und ab wann eskalieren wir?
Ein vollständiges SLO definiert mindestens drei Dimensionen:
Verfügbarkeit: In welchem Zeitanteil muss der Service verfügbar sein? Ein SLO von 99,9 % bedeutet: Es werden maximal 8,7 Stunden Downtime pro Jahr akzeptiert.
Latenz: Wie schnell muss der Dienst reagieren? „95 % aller Anfragen unter 200 Millisekunden“ ist eine konkrete, messbare Vorgabe.
Fehlerquote: Welcher Anteil der Anfragen darf mit einem Fehler beantwortet werden? „Weniger als 0,1 % 5xx-Antworten“ schützt die Nutzer vor systemischen Problemen.
Diese drei Zahlen zusammen definieren das Qualitätsversprechen des Teams. Sie sind die Grundlage für Bereitschaftsentscheidungen: Eskaliert wird, wenn ein SLO gefährdet ist — nicht bei jeder Auffälligkeit.
Pilot mit einem Team (Monate 1–3): Ein freiwilliges Team übernimmt YBIYRI für einen unkritischen Service. Rufbereitschaft einrichten, SLOs definieren, erste Erfahrungen sammeln. Lessons Learned dokumentieren.
Expansion (Monate 3–6): Drei bis fünf weitere Teams übernehmen YBIYRI. Das Plattform-Team stellt Self-Service-Tools bereit, die die kognitive Belastung reduzieren. Es werden gemeinsame Runbooks und Playbooks erstellt.
Vollständige Einführung (Monate 6–12): Alle neuen Services werden nach dem YBIYRI-Modell erstellt. Das klassische Ops-Team wandelt sich sukzessive zum Platform Engineering. Altsysteme verbleiben während der Transition im klassischen Modell.
Diese Frage beschäftigt die Führung mehr als jede fachliche Frage. Die ehrliche Antwort: Das klassische Ops-Team verschwindet nicht. Es transformiert sich.
Mitarbeitende mit guten Infrastrukturkenntnissen sind im Platform-Engineering-Team sehr wertvoll: Sie kennen betriebliche Probleme, sie verstehen, was in der Produktion schiefgehen kann, sie haben die Erfahrung, die Entwicklern oft fehlt.
Die Qualifizierungsmaßnahmen für diesen Übergang sind im Kapitel Workforce Transition beschrieben. Was frühzeitig kommuniziert werden muss: Niemand verliert durch YBIYRI seinen Job — aber die Aufgaben ändern sich.
Koordination über dezentrale Dependency Boards und Etablierung des "Inner Source"-Prinzips zur gemeinsamen Nutzung von Terraform- und Helm-Modulen.
Technisch ist eine Cloud-Migration planbar. Organisatorisch eher selten. Sobald mehrere Teams parallel auf der gleichen Plattform arbeiten, entstehen Abhängigkeiten, die zu Beginn niemand vollständig sieht.
Ein gängiges Muster: Das Applikationsteam wartet auf die Landing Zone des Plattform-Teams. Das Plattform-Team wartet auf die IAM-Entscheidung des Security-Teams. Das Security-Team wartet auf die regulatorische Freigabe durch Compliance. Alle warten — und der Go-Live-Termin naht.
Dieses Kapitel beschreibt, wie Abhängigkeiten frühzeitig sichtbar werden und wie Teams trotz Abhängigkeiten parallel arbeiten können.
In klassischen IT-Projekten gibt es einen Projektleiter, der alle Abhängigkeiten kennt und steuert. Bei Cloud-Transformationen wird die Arbeit auf Teams mit unterschiedlichen Kadenzen, unterschiedlichen Prioritäten und unterschiedlichen Anreizstrukturen verteilt.
Ein Plattform-Team arbeitet in zweiwöchigen Sprints. Ein Compliance-Team arbeitet im Quartalsrhythmus. Ein Applikationsteam arbeitet nach einer Produkt-Roadmap. Diese drei Rhythmen erzeugen systematisch Fehlausrichtungen.
Die Lösung ist nicht eine stärkere zentrale Steuerung, sondern eine bessere Sichtbarkeit und klarere Schnittstellen.
Bevor Teams zusammenarbeiten, sollte klar sein: In welcher Beziehung stehen sie zueinander?
Plattform-Team → Applikationsteams: Das Plattform-Team stellt Services (Kubernetes-Cluster, Networking, IAM-Templates) bereit. Applikationsteams konsumieren diese Dienste. Die Interaktion sollte möglichst über Self-Service-Schnittstellen (Servicekatalog, Terraform-Module, Dokumentation) erfolgen — nicht über Tickets.
CCoE → alle Teams: Der CCoE setzt Standards, prüft Architekturentscheidungen und unterstützt bei Eskalationen. Er ist kein Freigabegremium, sondern ein Enabler mit Vetorecht bei kritischen Sicherheits- und Compliance-Fragen.
Applikationsteams untereinander: Shared-Service-Abhängigkeiten (z. B. eine zentrale Datenbank, die von mehreren Teams genutzt wird) sind der häufigste Abstimmungsengpass. Diese sind explizit als „Plattform-Service“ zu behandeln und vom zuständigen Team als internes Produkt mit SLA zu betreiben.
Ein einfaches, aber effektives Instrument: eine Tafel (physisch oder digital), die alle teamübergreifenden Abhängigkeiten visualisiert.
| Abhängigkeit | Lieferndes Team | Empfangendes Team | Geplant für | Status |
|---|---|---|---|---|
| Landing Zone Prod | Plattform | App-Team Billing | Woche 14 | in Arbeit |
| IAM-Rollenkonzept | Security | Plattform | Woche 12 | blockiert |
| Datenschutzrechtliche Freigabe | Compliance | App-Team CRM | Woche 16 | offen |
| CI/CD-Pipeline-Template | Plattform | App-Team Logistik | Woche 13 | fertig |
Das Dependency Board wird wöchentlich aktualisiert. Blockaden werden sofort sichtbar — bevor sie zum Engpass werden.
Daily Standup (teamintern)
15 Minuten täglich. Was wurde gestern gemacht? Was ist heute geplant? Was blockiert? Blockaden mit teamübergreifenden Abhängigkeiten werden sofort eskaliert — nicht als Ticket, sondern als direkte Ansprache.
Platform Sync (wöchentlich)
45 Minuten. Das Plattform-Team stellt vor: Was ist neu verfügbar? Was kommt in den nächsten zwei Wochen? Welche Änderungen haben Breaking-Change-Potenzial? Alle Applikationsteams sind vertreten.
Dependency Review (zweiwöchentlich)
30 Minuten. Review des Dependency Boards. Welche Abhängigkeiten sind offen, welche eskalieren? Entscheidungen über Verschiebungen werden hier getroffen, nicht per E-Mail.
Lenkungsausschuss (monatlich)
Management, CIO, Tech Leads. Stand der Gesamtmigration, strategische Kursanpassungen, Ressourcenentscheidungen. Keine Detailgespräche — nur Entscheidungen.
Wenn alle Teams die gleiche STACKIT-Infrastruktur nutzen, entsteht ein gemeinsamer Code-Base-Effekt: Terraform-Module, Helm-Charts und CI/CD-Templates werden doppelt entwickelt.
Inner Source bedeutet: Plattformkomponenten werden intern wie Open-Source-Projekte geteilt. Jedes Team kann seinen Beitrag leisten. Das Plattform-Team pflegt und prüft. Ergebnis: keine Duplikate, schnellere Iteration, gemeinsames Qualitätsbewusstsein.
In der Praxis: ein internes Git-Repository mit Terraform-Modulen für STACKIT-Ressourcen, versioniert und dokumentiert. Applikationsteams nutzen, verbessern und teilen zurück.
Manchmal reichen Prozesse nicht aus. Dann braucht es klare Eskalationswege.
Eskalations-Trigger: Eine teamübergreifende Abhängigkeit ist seit zwei Wochen blockiert und hat einen Go-Live-Termin gefährdet.
Eskalationspfad:
Was auf keinen Fall passieren sollte: Das Lösen von Blockaden durch E-Mail-Pingpong ohne definierten Eskalationspunkt. Zeitdruck löst strukturelle Abhängigkeitsprobleme nicht.
Teamtopologie dokumentieren — Wer arbeitet mit wem zusammen? In welchem Modus (Collaboration, X-as-a-Service, Facilitating)? Schriftlich, als Basis für alle weiteren Abstimmungsformate.
Dependency Board aufsetzen — Einfach starten: Eine Tabelle in Confluence oder Jira reicht. Wichtig: ein wöchentlicher Prüftermin im Kalender.
Sync-Formate etablieren — Platform Sync und Dependency Review als wiederkehrende Termine anlegen. Agenda-Vorlagen erstellen.
Den Eskalationspfad kommunizieren — Alle Teams wissen, an wen und wann eskaliert werden muss. Nicht als Bedrohung, sondern als Sicherheitsnetz.
Ein Inner-Source-Repository erstellen — Beginnen Sie mit dem Terraform-Modul, das die meisten Teams benötigen. Dokumentieren Sie, wie Beiträge geleistet werden.
Anpassung klassischer ITIL-Prozesse (z. B. Reduzierung der CMDB auf strategische Informationen, Etablierung von IaC als Konfigurationsquelle).
ITIL (IT Infrastructure Library) war die Antwort auf das Chaos der frühen IT-Organisationen: standardisierte Prozesse für Change Management, Incident Management, Problem Management und Service Design. Für die meisten Organisationen war ITIL ein notwendiger Schritt in Richtung Reife.
In Cloud-Umgebungen gerät ITIL unter Druck. Ein Change Advisory Board, das einmal pro Woche tagt, ist nicht vereinbar mit einer Organisation, die Hunderte von Deployments pro Tag anstrebt. Ein 14-tägiger Change-Request-Prozess blockiert die agile Iteration, die die Cloud ermöglichen soll.
Die Antwort lautet nicht: ITIL abschaffen. Die Antwort lautet: ITIL weiterentwickeln.
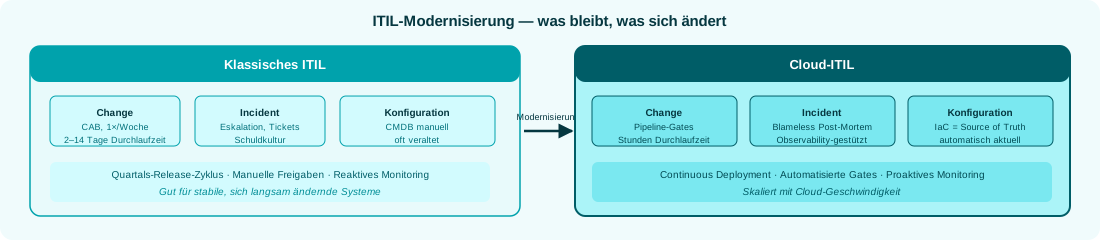
Was von ITIL bleibt:
Was sich grundlegend ändert:
Das klassische Change Management wurde für eine Welt konzipiert, in der jede Änderung an Produktivsystemen manuell, riskant und schwer rückgängig zu machen war. In dieser Welt war ein formaler Freigabeprozess sinnvoll.
In Cloud-Umgebungen mit Infrastructure-as-Code und automatisierten Tests verändert sich die Risikoeinschätzung grundlegend. Ein Terraform-Change, der vor dem Deployment automatisch gegen Policies geprüft, im Staging getestet und von zwei Personen per Pull Request geprüft wurde, hat ein anderes Risikoprofil als eine manuelle Konfigurationsänderung in der Nacht.
Das modernisierte Change-Modell:
Standard Changes (häufig, gut dokumentiert, geringes Risiko) werden vollständig automatisiert. Kein CAB, kein Change-Ticket — die Automatisierung ist der Freigabeprozess. Beispiele: Container-Image-Updates, Konfigurationsänderungen bei bekannten Parametern, Ressourcenskalierung.
Normal Changes (Änderungen an kritischen Systemkomponenten) durchlaufen einen Pull-Request-Prozess mit zwei Reviewern, einer automatisierten Test-Suite und einem Deployment-Window. Das „CAB“ ist die asynchrone Prüfung durch erfahrene Kolleginnen und Kollegen — schneller, effizienter, bei gleichbleibender Sicherheit.
Emergency Changes (kritische Korrekturen in der Produktion) haben einen beschleunigten Prozess mit anschließender Dokumentation. Sie werden im Post-Incident-Review besprochen: Wurde das Notfallverfahren korrekt angewendet? Was verhindert, dass das gleiche Problem noch einmal als Notfall behandelt wird?
Das Kernmodell des Incident Managements — Detection, Triage, Escalation, Resolution, Post-Mortem — ist in Cloud-Umgebungen genauso gültig wie in klassischen IT-Umgebungen.
Was sich ändert, ist die Geschwindigkeit und die Erwartungshaltung.
Detection: Klassisch durch Benutzermeldungen oder manuelles Monitoring. Heute durch automatisierte Observability-Systeme, die Auffälligkeiten erkennen, bevor Nutzer betroffen sind.
Triage: Klassisch durch manuelle Diagnose über SSH und Logfiles. Heute durch zentrale Dashboards, verteiltes Tracing und strukturierte Log-Suche.
Rufbereitschaftsstruktur: Cloud-Umgebungen erfordern eine Rotation der Rufbereitschaft rund um die Uhr. Für viele IT-Organisationen ist dies kulturell die größte Veränderung: Wer hat Rufbereitschaft, wie wird diese vergütet, wie wird Burnout verhindert?
Post-Mortem-Kultur: Fehleranalysen ohne Schuldzuweisung (Blameless Post-Mortems) sind in DevOps-Kulturen Standard — keine Schuldzuweisung, sondern systemisches Lernen. Für ITIL-geprägte Organisationen ist dies häufig ein kultureller Wandel, der Zeit und Engagement der Führungskräfte erfordert.
Die Configuration Management Database (CMDB) war die Antwort von ITIL auf die Frage: Was läuft wo, in welcher Konfiguration, mit welchen Abhängigkeiten zu was sonst? In klassischen Umgebungen war sie wertvoll — und notorisch schwierig aktuell zu halten.
In Cloud-Umgebungen mit Infrastructure-as-Code ist die CMDB kein Primärsystem mehr. Infrastructure-as-Code (Terraform, Ansible) ist die neue CMDB — mit dem entscheidenden Vorteil, dass sie automatisch richtig ist: Was in Terraform steht, ist (nach dem letzten Apply) Realität.
Was dies für die Organisation bedeutet:
SLAs mit den Sparten bleiben wichtig — aber deren Design ändert sich. Klassische SLAs sprachen über die Verfügbarkeit in Prozent auf Monatsbasis. Cloud-SLAs können granularer sein.
Verfügbarkeits-SLA
Monatliche Verfügbarkeit des Services. Basierend auf dem STACKIT Plattform-SLA, reduziert um einen internen Betriebspuffer. Transparent kommuniziert und im Servicekatalog dokumentiert.
Reaktionszeit-SLA
Reaktionszeiten nach Schweregrad. P1 innerhalb von 15 Minuten, P2 innerhalb von 1 Stunde — nicht als Versprechen, sondern als messbare Zusage mit monatlichem Reporting.
Recovery-Time-SLA
RTO und RPO pro Tier-Klasse (Tier 1 bis 4). Nicht als theoretische Kennzahl, sondern als regelmäßig getestete und nachgewiesene Fähigkeit.
Change Lead Time
Wie lange dauert es, bis eine genehmigte Änderung in Produktion ist? Bei Standard Changes: Stunden. Bei Normal Changes: Tage. Nicht Wochen.
ITIL-Prozesse über Nacht abzuschaffen ist genauso falsch, wie sie unverändert in die Cloud zu überführen. Das richtige Vorgehen ist schrittweise.
Bestandsaufnahme: Welche ITIL-Prozesse gibt es? Welche davon machen in der Cloud Sinn, welche erzeugen Reibung?
Quick Wins identifizieren: Die Automatisierung von Standard Changes ist in der Regel schnell umzusetzen und sofort spürbar.
Change-Prozess überarbeiten: CAB-Frequenz erhöhen oder durch asynchrone Prüfung ersetzen. Einführung eines Automatisierungs-Gateways als Alternative zu manuellen Freigaben.
Blameless Post-Mortems einführen: Kulturell fordernd, aber entscheidend für eine kontinuierliche Verbesserung. Die Führung muss vorleben, dass Fehler Lernchancen sind.
CMDB-Strategie anpassen: IaC als primäre Konfigurationsquelle festlegen; die CMDB auf strategische Informationen reduzieren.
Einführung der vier DORA-Kennzahlen zur objektiven und regelmäßigen Messung sowie Steigerung der Software-Lieferfähigkeit.
DORA (DevOps Research and Assessment) hat in einer siebenjährigen Studie mit mehr als 32.000 Organisationen festgestellt: Vier Kennzahlen korrelieren stark mit den Geschäftsergebnissen, einschließlich Marktanteil, Rentabilität und Mitarbeiterzufriedenheit.
DORA-Kennzahlen messen Ergebnisse, nicht Aufwand. Eine Organisation, die diese vier Kennzahlen verbessert, verbessert objektiv ihre Fähigkeit, Software zuverlässig und schnell bereitzustellen — unabhängig davon, welche Methoden oder Tools sie verwendet.
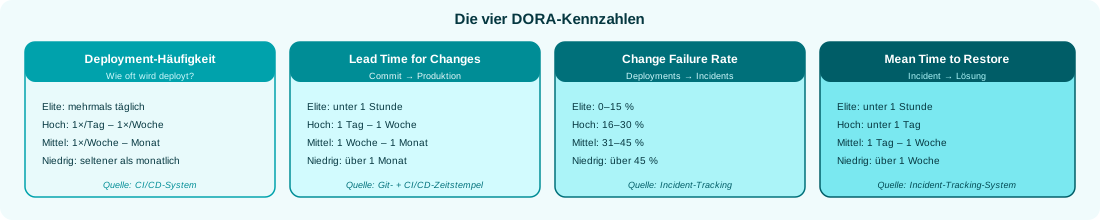
Diese Metrik misst die Lieferfähigkeit. Teams mit hoher Deployment-Häufigkeit liefern kleine, zielgerichtete Änderungen — was das Risiko reduziert und die Feedback-Zyklen verkürzt.
| Performance-Level | Deployment-Häufigkeit | Bedeutung |
|---|---|---|
| Elite | Mehrmals täglich | Continuous Deployment, kleinstmögliche Chargen |
| Hoch | Einmal täglich bis einmal wöchentlich | Regelmäßige, strukturierte Releases |
| Mittel | Einmal wöchentlich bis einmal monatlich | Weiterhin erheblicher manueller Aufwand |
| Niedrig | Weniger als monatlich | Hoher Release-Overhead, geballtes Risiko |
Wie gemessen wird: Anzahl der Deployments in die Produktion pro Zeiteinheit — aus dem CI/CD-System bzw. dem Deployment-Tracking.
Diese Metrik misst die Effizienz des Lieferprozesses. Eine lange Vorlaufzeit bedeutet, dass zwischen einer Codeänderung und der Produktivumgebung viele manuelle Schritte, Wartezeiten, Freigaben oder schwerfällige Tests stehen.
| Performance-Level | Durchlaufzeit | Bedeutung |
|---|---|---|
| Elite | Weniger als 1 Stunde | Vollautomatisierte Pipeline |
| Hoch | 1 Tag bis 1 Woche | Guter Automatisierungsgrad |
| Mittel | 1 Woche bis 1 Monat | Viele manuelle Prozesse |
| Niedrig | Mehr als 1 Monat | Schwerfällige Freigabeprozesse |
Diese Metrik misst die Qualität. Eine hohe Change Failure Rate bedeutet, dass Produktiv-Deployments regelmäßig zu Problemen führen — trotz Tests und Reviews.
| Performance-Level | Change Failure Rate |
|---|---|
| Elite | 0–15 % |
| Hoch | 16–30 % |
| Mittel/Niedrig | 31–60 % |
Eine hohe Change Failure Rate ist oft der Treiber für die niedrige Deployment-Häufigkeit: Wenn bei jedem zweiten Deployment etwas kaputtgeht, werden Deployments seltener und riskanter.
Diese Metrik misst die Belastbarkeit. Vorfälle werden immer auftreten — die Fähigkeit, schnell zu reagieren und sich zu erholen, unterscheidet Elite-Organisationen von anderen.
| Performance-Level | MTTR |
|---|---|
| Elite | Weniger als 1 Stunde |
| Hoch | Weniger als 1 Tag |
| Mittel | 1 Tag bis 1 Woche |
| Niedrig | Mehr als 1 Woche |
Die meisten Organisationen, die ihre erste Cloud-Migration beginnen, starten auf dem Niveau Niedrig bis Mittel. Dies ist keine Kritik — es ist der natürliche Ausgangspunkt einer Organisation, die von klassischen IT-Betriebsmodellen kommt.
| Metrik | Typischer Ausgangspunkt | DORA-Level | Ziel Jahr 1 | Ziel Jahr 2 |
|---|---|---|---|---|
| Deployment-Häufigkeit | 1× alle 2–4 Wochen | Niedrig | 1× / Woche (Mittel) | 1× / Tag (Hoch) |
| Durchlaufzeit | 3–6 Wochen | Niedrig | 1–5 Tage | unter 1 Tag |
| Change Failure Rate | 30–50 % | Niedrig/Mittel | unter 20 % | unter 10 % |
| MTTR | 2–5 Tage | Niedrig | unter 4 Stunden | unter 1 Stunde |
DORA-Kennzahlen sind keine abstrakten Konzepte — sie benötigen konkrete Datenquellen:
Deployment-Häufigkeit
Datenquelle: CI/CD-System (GitHub Actions, GitLab CI, Jenkins). Jedes erfolgreiche Produktiv-Deployment wird gezählt. Einfach zu automatisieren.
Durchlaufzeit
Datenquelle: Git-Zeitstempel des Commits kombiniert mit dem Deployment-Zeitstempel aus CI/CD. Die Differenz ist die Durchlaufzeit. DORA-Tools wie Sleuth oder LinearB automatisieren diese Berechnung.
Change Failure Rate
Datenquelle: Incidents aus dem Incident-Tracking (PagerDuty, OpsGenie, JIRA) kombiniert mit Deployments. Anteil der Deployments, die innerhalb von 24 Stunden zu einem Incident führten.
MTTR
Datenquelle: Incident-Tracking-System. Zeit zwischen Störfalleröffnung und Störfallschließung bei Produktionsstörfällen.
DORA-Kennzahlen im Management-Reporting: Diese vier Zahlen gehören in den monatlichen IT-Report an die Führung — als objektives Maß für die Lieferfähigkeit, nicht als technische Kennzahlen für Entwickler. Sie sind für das Business so relevant wie der NPS oder die Conversion Rate.
Quartal 1 — die Grundlage bilden: Zwei bis drei Pilot-Services erhalten eine vollständige CI/CD-Pipeline. Automatisiertes Testen wird eingeführt. Das erste DORA-Dashboard wird aufgebaut. Deployment-Häufigkeit: Niedrig → Mittel.
Quartal 2 — Automatisierung ausbauen: Standard Changes werden vollständig automatisiert. Der Observability-Stack ist vollständig. Reduzierung der Durchlaufzeit durch weniger manuelle Arbeitsschritte. Durchlaufzeit: Niedrig → Hoch.
Quartal 3 — Qualität verbessern: Die Testabdeckung wird ausgeweitet. Security Scanning ist in CI/CD eingebettet. Der Incident-Response-Prozess wird optimiert. Change Failure Rate und MTTR verbessern sich.
Quartal 4 — skalieren: DORA-Praktiken werden in alle Teams ausgerollt. DORA-Kennzahlen sind Bestandteil des monatlichen Managementreports. Alle vier Metriken im Bereich Hoch.
DORA-Kennzahlen — insbesondere MTTR und Change Failure Rate — können ohne ein gutes Observability-Setup nicht zuverlässig gemessen werden. Eine Organisation, die Incidents nicht innerhalb von Minuten erkennt, kann die MTTR nicht auf unter eine Stunde reduzieren. Der Aufbau von Observability ist also keine technische Nebensache, sondern die Voraussetzung für messbare DORA-Verbesserungen.