CIO / IT-Lead
Verabschiedet RTO/RPO-Ziele, fungiert im Notfall als Eskalationsinstanz, gibt DR-Tests frei und berichtet Ergebnisse an Vorstand und Aufsichtsbehörden.
Disaster Recovery ist die Disziplin, die niemand praktiziert — bis sie muss. Dann kostet jede Entscheidung, die früher hätte getroffen werden können, Geld und Vertrauen.
Für die meisten Organisationen ist die Cloud-Migration der Moment, in dem DR-Anforderungen zum ersten Mal schriftlich definiert werden. Das ist die Chance: klar, verhältnismäßig und getestet.
Jedes System hat eine implizite Wiederherstellungszeit und einen akzeptablen Schwellenwert für Datenverlust. Die meisten Organisationen kennen diese Zahlen nicht — und zahlen den Preis dafür, wenn ein Vorfall eintritt.
Recovery Time Objective (RTO): Wie lange darf ein System nach einem Ausfall nicht verfügbar sein? Eine RTO von 4 Stunden bedeutet: Nach spätestens 4 Stunden muss das System wieder funktionsfähig sein.
Recovery Point Objective (RPO): Wie viel Datenverlust ist akzeptabel? Ein RPO von 1 Stunde bedeutet: Maximal dürfen die letzten 60 Minuten Daten verloren gehen.
Die wichtige Regel: Je aggressiver RTO und RPO, desto höher die laufenden Kosten. Eine RTO von 15 Minuten bei einem RPO von 5 Minuten erfordert Hot-Standby-Umgebungen. Eine RTO von 24 Stunden bei einem RPO von 12 Stunden kann durch tägliche Sicherungen und manuelle Prozesse eingehalten werden.
Die richtige Antwort ist: verhältnismäßig, nicht maximalistisch.
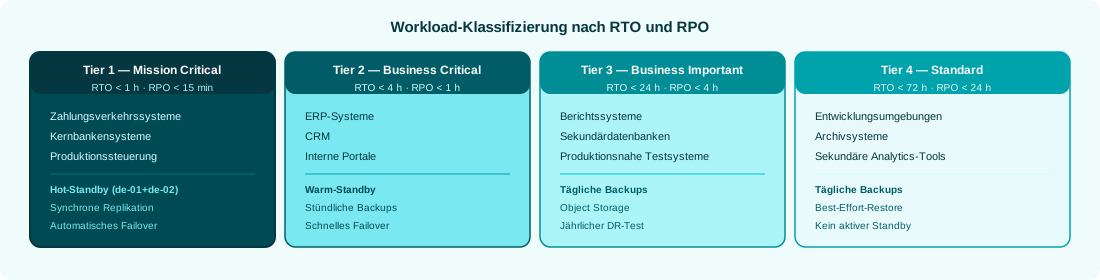
Systeme, deren Ausfall unmittelbar zu Umsatzeinbußen, regulatorischen Konsequenzen oder Sicherheitsrisiken führt. Beispiele: Zahlungsverkehrssysteme, Kernbankensysteme, industrielle Produktionssteuerung.
Systeme, die innerhalb weniger Stunden wiederhergestellt werden müssen, deren Ausfall aber kurzfristig tolerierbar ist. Beispiele: ERP-Systeme, CRM, interne Portale.
Systeme, die innerhalb eines Arbeitstages wiederhergestellt werden können. Beispiele: Berichtssysteme, Sekundärdatenbanken, produktionsnahe Testsysteme.
Systeme ohne unmittelbare Business-Kritikalität. Beispiele: Entwicklungsumgebungen, Archivsysteme, sekundäre Analytics-Tools.
Für regulierte Branchen ist DR keine freiwillige Best Practice, sondern eine regulatorische Anforderung.
BAIT (Banken): Erfordert dokumentierte Notfallpläne, regelmäßige Tests und Ausfallszenarien für alle wesentlichen IT-Systeme. Wiederherstellungsziele müssen von der Geschäftsleitung freigegeben werden.
KRITIS (kritische Infrastruktur): Verpflichtet KRITIS-Betreiber zum Business Continuity Management nach BSI IT-Grundschutz bzw. ISO 22301. DR-Tests sind verpflichtend; Ergebnisse sind zu dokumentieren.
DSGVO: Art. 32 erfordert die Fähigkeit, die Verfügbarkeit von personenbezogenen Daten nach einem Vorfall wiederherzustellen. Ein RPO von mehr als 24 Stunden für DSGVO-relevante Systeme ist nur schwer zu begründen.
DORA (Digital Operational Resilience Act, ab Januar 2025): Verpflichtet Finanzinstitute zu einem umfassenden IKT-Risikomanagement mit expliziten BCM-Anforderungen und verpflichtenden Resilienz-Tests.
STACKIT als Partner: STACKIT betreibt in Deutschland Rechenzentren mit ISO-27001- und SOC-2-Zertifizierung. Die Datenresidenz in de-01/de-02 stellt sicher, dass Backup-Daten Deutschland nicht verlassen — ein entscheidender Vorteil für regulierte Industrien.
Der häufigste DR-Fehler ist, den Plan nie zu testen. DR-Tests werden regelmäßig verschoben, weil die Produktionsumgebung als zu kritisch gilt, um ein simuliertes Failover zu riskieren, weil keine klare Verantwortlichkeit für DR-Tests besteht und weil Tests als Aufwand ohne direkten Nutzen angesehen werden.
Die Lösung: DR-Tests als regelmäßiges Engineering-Ritual verankern, nicht als Ausnahmeereignis.
Vier Testformate in aufsteigender Intensität:
1. Tabletop-Übung (jährlich, geringer Aufwand): Das Team bearbeitet gemeinsam ein Ausfallszenario — am Whiteboard. Keine Systeme werden berührt. Identifiziert Lücken in Prozessen und Verantwortlichkeiten.
2. Komponententest (quartalsweise): Ein bestimmter Backup- oder Failover-Mechanismus wird in der Staging-Umgebung getestet. Dauer: einige Stunden.
3. Teil-Failover-Test (halbjährlich): Ein nicht produktionskritisches System wird tatsächlich auf den Standby-Standort geschaltet. Misst die tatsächliche RTO. Dauer: ein halber Tag.
4. Vollständige DR-Übung (jährlich): Vollständige Simulation eines Rechenzentrumsausfalls für alle Tier-1- und Tier-2-Systeme. Erfordert Planung und Abstimmung mit Stakeholdern. Liefert die echten Nachweise für die Aufsichtsbehörden.
CIO / IT-Lead
Verabschiedet RTO/RPO-Ziele, fungiert im Notfall als Eskalationsinstanz, gibt DR-Tests frei und berichtet Ergebnisse an Vorstand und Aufsichtsbehörden.
Plattform-Team
Implementiert und wartet die DR-Infrastruktur, führt Komponententests durch, dokumentiert Wiederherstellungsverfahren.
Applikationseigentümer
Klassifizieren ihre Systeme in Tier-Klassen, definieren applikationsspezifische Wiederherstellungsschritte, nehmen an Tabletop-Übungen teil.
STACKIT
Gewährleistet die Verfügbarkeit der Cloud-Infrastruktur gemäß SLA, stellt Zone-zu-Zone-Replikation bereit, liefert Audit-Logs für behördliche Nachweise.
Inventur und Klassifizierung aller Systeme — Tier-Zuordnung für jeden Workload, dokumentiert und durch die Sparte bestätigt.
RTO-/RPO-Ziele durch Vorstand oder CIO genehmigen lassen — Keine IT-Entscheidung, sondern eine Business-Entscheidung mit Auswirkungen auf die Kosten.
DR-Architektur pro Tier umsetzen — Vom einfachen Backup im Object Storage bis zum Hot Standby in der zweiten STACKIT-Zone.
Wiederherstellungsverfahren dokumentieren — Als Runbook, nicht als Konzept. Konkrete Schritte, die im Notfall ohne weitere Rückfragen ausgeführt werden können.
Die erste Tabletop-Übung durchführen — Innerhalb von 30 Tagen nach Produktivsetzung. Ergebnis: eine Liste der offenen Punkte mit Eigentümer und Termin.
Einen DR-Testkalender etablieren und pflegen — Quartalsweise Komponententests, halbjährlich partielles Failover, jährlich vollständige Übung.