Gute Beobachtbarkeit
Kein Team kann einen Service betreiben, den es nicht sieht. Vor der Einführung von YBIYRI muss die Observability-Plattform vorhanden sein: Dashboards, Alerts, Runbooks.
Im klassischen IT-Modell gibt es eine strukturelle Übergabe: Entwickler bauen eine Applikation und übergeben sie an den Betrieb. Operations deployt, überwacht und repariert.
Durch diese Übergabe entstehen systematisch drei Probleme:
Reibungs- und Wartezeiten: Jeder Wechsel durchläuft einen Übergabeprozess. Was technisch fertig ist, wartet auf die Kapazität des operativen Teams.
Unklare Verantwortlichkeit: Wenn eine Applikation in der Produktion ausfällt, stellt sich zunächst die Frage: Liegt es am Code oder an der Infrastruktur? Diese Frage kostet Zeit — die besonders im Incident wertvoll ist.
Unterschiedliche Prioritäten: Entwicklungsteams wollen neue Features ausliefern. Betriebsteams wollen Stabilität. Diese Interessen stehen strukturell im Konflikt, solange sie in unterschiedlichen Teams sitzen.
YBIYRI (You Build It You Run It) löst alle drei Probleme durch eine einfache Verschiebung: Das Team, das eine Anwendung baut, betreibt sie auch in der Produktion. Volle Verantwortung, volle Kompetenz.
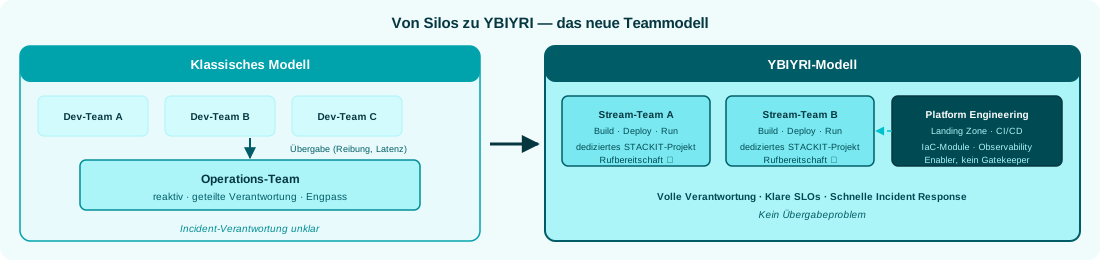
Stream-orientierte Teams sind vollumfänglich für einen Service oder ein Produkt verantwortlich — von der Entwicklung bis zum Produktionsbetrieb:
Diese vollständige Eigenverantwortung ist der Kern von YBIYRI. Sie verändert die Denkweise: Eine Person, die weiß, dass sie nachts geweckt wird, wenn die Anwendung ausfällt, baut sie anders auf.
Das Platform-Engineering-Team (oft aus dem CCoE hervorgegangen) ist kein Ops-Team im klassischen Sinne. Es baut und betreibt die interne Plattform, die allen stromorientierten Teams das Leben erleichtert:
Das Plattform-Team ist kein Freigabegremium, sondern ein Enabler. Stream-orientierte Teams sollten in der Lage sein, ihre Arbeit zu erledigen, ohne für jedes Infrastrukturthema ein Ticket zu erstellen.
YBIYRI ist als Konzept attraktiv — scheitert aber, wenn die organisatorischen Voraussetzungen fehlen.
Gute Beobachtbarkeit
Kein Team kann einen Service betreiben, den es nicht sieht. Vor der Einführung von YBIYRI muss die Observability-Plattform vorhanden sein: Dashboards, Alerts, Runbooks.
Automatisierte Deployments
Bereitschaftsteams können um 2 Uhr morgens nicht manuell deployen. Automatisierte, reproduzierbare Deployments über CI/CD sind Voraussetzung — kein Nice-to-have.
Klare Service Level Objectives
SLOs definieren, wann ein Incident wirklich kritisch ist. Ohne diese Klarheit weckt jede kleine Anomalie jemanden. Mit SLOs erfolgt eine Eskalation nur, wenn ein Ziel gefährdet ist.
Psychologische Sicherheit
Teams übernehmen keine echte Verantwortung, wenn Fehler bestraft werden. Grundvoraussetzung ist eine Kultur, in der Vorfälle als Lerngelegenheiten behandelt werden (Blameless Post-Mortem).
Faire Bereitschaftsvergütung
YBIYRI ohne fairen Ausgleich der Rufbereitschaft führt zu Burnout und zum Verlust der besten Mitarbeitenden. Bereitschaft muss klar geregelt und angemessen vergütet werden — vor der Einführung, nicht danach.
Ausreichende Teamgröße
Ein dreiköpfiges Team kann keine gesunde Rotation der Rufbereitschaft aufrechterhalten. YBIYRI erfordert, dass die Teams groß genug sind (in der Regel 5–8 Personen), um die Rufbereitschaft zu verteilen.
SLOs (Service Level Objectives) sind die schriftliche Zusage eines Teams zu seinem Service. Sie beantworten: Was ist für uns „gut genug“ — und ab wann eskalieren wir?
Ein vollständiges SLO definiert mindestens drei Dimensionen:
Verfügbarkeit: In welchem Zeitanteil muss der Service verfügbar sein? Ein SLO von 99,9 % bedeutet: Es werden maximal 8,7 Stunden Downtime pro Jahr akzeptiert.
Latenz: Wie schnell muss der Dienst reagieren? „95 % aller Anfragen unter 200 Millisekunden“ ist eine konkrete, messbare Vorgabe.
Fehlerquote: Welcher Anteil der Anfragen darf mit einem Fehler beantwortet werden? „Weniger als 0,1 % 5xx-Antworten“ schützt die Nutzer vor systemischen Problemen.
Diese drei Zahlen zusammen definieren das Qualitätsversprechen des Teams. Sie sind die Grundlage für Bereitschaftsentscheidungen: Eskaliert wird, wenn ein SLO gefährdet ist — nicht bei jeder Auffälligkeit.
Pilot mit einem Team (Monate 1–3): Ein freiwilliges Team übernimmt YBIYRI für einen unkritischen Service. Rufbereitschaft einrichten, SLOs definieren, erste Erfahrungen sammeln. Lessons Learned dokumentieren.
Expansion (Monate 3–6): Drei bis fünf weitere Teams übernehmen YBIYRI. Das Plattform-Team stellt Self-Service-Tools bereit, die die kognitive Belastung reduzieren. Es werden gemeinsame Runbooks und Playbooks erstellt.
Vollständige Einführung (Monate 6–12): Alle neuen Services werden nach dem YBIYRI-Modell erstellt. Das klassische Ops-Team wandelt sich sukzessive zum Platform Engineering. Altsysteme verbleiben während der Transition im klassischen Modell.
Diese Frage beschäftigt die Führung mehr als jede fachliche Frage. Die ehrliche Antwort: Das klassische Ops-Team verschwindet nicht. Es transformiert sich.
Mitarbeitende mit guten Infrastrukturkenntnissen sind im Platform-Engineering-Team sehr wertvoll: Sie kennen betriebliche Probleme, sie verstehen, was in der Produktion schiefgehen kann, sie haben die Erfahrung, die Entwicklern oft fehlt.
Die Qualifizierungsmaßnahmen für diesen Übergang sind im Kapitel Workforce Transition beschrieben. Was frühzeitig kommuniziert werden muss: Niemand verliert durch YBIYRI seinen Job — aber die Aufgaben ändern sich.