Deployment-Häufigkeit
Datenquelle: CI/CD-System (GitHub Actions, GitLab CI, Jenkins). Jedes erfolgreiche Produktiv-Deployment wird gezählt. Einfach zu automatisieren.
DORA (DevOps Research and Assessment) hat in einer siebenjährigen Studie mit mehr als 32.000 Organisationen festgestellt: Vier Kennzahlen korrelieren stark mit den Geschäftsergebnissen, einschließlich Marktanteil, Rentabilität und Mitarbeiterzufriedenheit.
DORA-Kennzahlen messen Ergebnisse, nicht Aufwand. Eine Organisation, die diese vier Kennzahlen verbessert, verbessert objektiv ihre Fähigkeit, Software zuverlässig und schnell bereitzustellen — unabhängig davon, welche Methoden oder Tools sie verwendet.
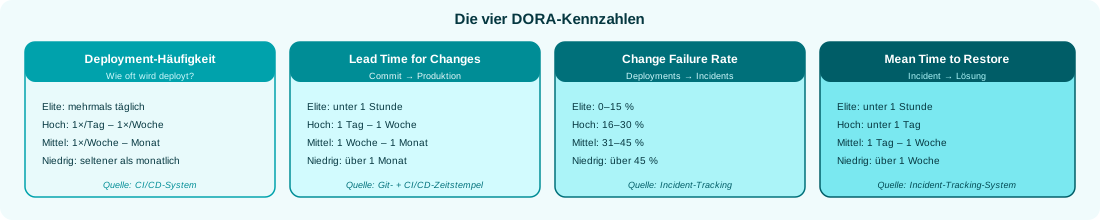
Diese Metrik misst die Lieferfähigkeit. Teams mit hoher Deployment-Häufigkeit liefern kleine, zielgerichtete Änderungen — was das Risiko reduziert und die Feedback-Zyklen verkürzt.
| Performance-Level | Deployment-Häufigkeit | Bedeutung |
|---|---|---|
| Elite | Mehrmals täglich | Continuous Deployment, kleinstmögliche Chargen |
| Hoch | Einmal täglich bis einmal wöchentlich | Regelmäßige, strukturierte Releases |
| Mittel | Einmal wöchentlich bis einmal monatlich | Weiterhin erheblicher manueller Aufwand |
| Niedrig | Weniger als monatlich | Hoher Release-Overhead, geballtes Risiko |
Wie gemessen wird: Anzahl der Deployments in die Produktion pro Zeiteinheit — aus dem CI/CD-System bzw. dem Deployment-Tracking.
Diese Metrik misst die Effizienz des Lieferprozesses. Eine lange Vorlaufzeit bedeutet, dass zwischen einer Codeänderung und der Produktivumgebung viele manuelle Schritte, Wartezeiten, Freigaben oder schwerfällige Tests stehen.
| Performance-Level | Durchlaufzeit | Bedeutung |
|---|---|---|
| Elite | Weniger als 1 Stunde | Vollautomatisierte Pipeline |
| Hoch | 1 Tag bis 1 Woche | Guter Automatisierungsgrad |
| Mittel | 1 Woche bis 1 Monat | Viele manuelle Prozesse |
| Niedrig | Mehr als 1 Monat | Schwerfällige Freigabeprozesse |
Diese Metrik misst die Qualität. Eine hohe Change Failure Rate bedeutet, dass Produktiv-Deployments regelmäßig zu Problemen führen — trotz Tests und Reviews.
| Performance-Level | Change Failure Rate |
|---|---|
| Elite | 0–15 % |
| Hoch | 16–30 % |
| Mittel/Niedrig | 31–60 % |
Eine hohe Change Failure Rate ist oft der Treiber für die niedrige Deployment-Häufigkeit: Wenn bei jedem zweiten Deployment etwas kaputtgeht, werden Deployments seltener und riskanter.
Diese Metrik misst die Belastbarkeit. Vorfälle werden immer auftreten — die Fähigkeit, schnell zu reagieren und sich zu erholen, unterscheidet Elite-Organisationen von anderen.
| Performance-Level | MTTR |
|---|---|
| Elite | Weniger als 1 Stunde |
| Hoch | Weniger als 1 Tag |
| Mittel | 1 Tag bis 1 Woche |
| Niedrig | Mehr als 1 Woche |
Die meisten Organisationen, die ihre erste Cloud-Migration beginnen, starten auf dem Niveau Niedrig bis Mittel. Dies ist keine Kritik — es ist der natürliche Ausgangspunkt einer Organisation, die von klassischen IT-Betriebsmodellen kommt.
| Metrik | Typischer Ausgangspunkt | DORA-Level | Ziel Jahr 1 | Ziel Jahr 2 |
|---|---|---|---|---|
| Deployment-Häufigkeit | 1× alle 2–4 Wochen | Niedrig | 1× / Woche (Mittel) | 1× / Tag (Hoch) |
| Durchlaufzeit | 3–6 Wochen | Niedrig | 1–5 Tage | unter 1 Tag |
| Change Failure Rate | 30–50 % | Niedrig/Mittel | unter 20 % | unter 10 % |
| MTTR | 2–5 Tage | Niedrig | unter 4 Stunden | unter 1 Stunde |
DORA-Kennzahlen sind keine abstrakten Konzepte — sie benötigen konkrete Datenquellen:
Deployment-Häufigkeit
Datenquelle: CI/CD-System (GitHub Actions, GitLab CI, Jenkins). Jedes erfolgreiche Produktiv-Deployment wird gezählt. Einfach zu automatisieren.
Durchlaufzeit
Datenquelle: Git-Zeitstempel des Commits kombiniert mit dem Deployment-Zeitstempel aus CI/CD. Die Differenz ist die Durchlaufzeit. DORA-Tools wie Sleuth oder LinearB automatisieren diese Berechnung.
Change Failure Rate
Datenquelle: Incidents aus dem Incident-Tracking (PagerDuty, OpsGenie, JIRA) kombiniert mit Deployments. Anteil der Deployments, die innerhalb von 24 Stunden zu einem Incident führten.
MTTR
Datenquelle: Incident-Tracking-System. Zeit zwischen Störfalleröffnung und Störfallschließung bei Produktionsstörfällen.
DORA-Kennzahlen im Management-Reporting: Diese vier Zahlen gehören in den monatlichen IT-Report an die Führung — als objektives Maß für die Lieferfähigkeit, nicht als technische Kennzahlen für Entwickler. Sie sind für das Business so relevant wie der NPS oder die Conversion Rate.
Quartal 1 — die Grundlage bilden: Zwei bis drei Pilot-Services erhalten eine vollständige CI/CD-Pipeline. Automatisiertes Testen wird eingeführt. Das erste DORA-Dashboard wird aufgebaut. Deployment-Häufigkeit: Niedrig → Mittel.
Quartal 2 — Automatisierung ausbauen: Standard Changes werden vollständig automatisiert. Der Observability-Stack ist vollständig. Reduzierung der Durchlaufzeit durch weniger manuelle Arbeitsschritte. Durchlaufzeit: Niedrig → Hoch.
Quartal 3 — Qualität verbessern: Die Testabdeckung wird ausgeweitet. Security Scanning ist in CI/CD eingebettet. Der Incident-Response-Prozess wird optimiert. Change Failure Rate und MTTR verbessern sich.
Quartal 4 — skalieren: DORA-Praktiken werden in alle Teams ausgerollt. DORA-Kennzahlen sind Bestandteil des monatlichen Managementreports. Alle vier Metriken im Bereich Hoch.
DORA-Kennzahlen — insbesondere MTTR und Change Failure Rate — können ohne ein gutes Observability-Setup nicht zuverlässig gemessen werden. Eine Organisation, die Incidents nicht innerhalb von Minuten erkennt, kann die MTTR nicht auf unter eine Stunde reduzieren. Der Aufbau von Observability ist also keine technische Nebensache, sondern die Voraussetzung für messbare DORA-Verbesserungen.