Verfügbarkeits-SLA
Monatliche Verfügbarkeit des Services. Basierend auf dem STACKIT Plattform-SLA, reduziert um einen internen Betriebspuffer. Transparent kommuniziert und im Servicekatalog dokumentiert.
ITIL (IT Infrastructure Library) war die Antwort auf das Chaos der frühen IT-Organisationen: standardisierte Prozesse für Change Management, Incident Management, Problem Management und Service Design. Für die meisten Organisationen war ITIL ein notwendiger Schritt in Richtung Reife.
In Cloud-Umgebungen gerät ITIL unter Druck. Ein Change Advisory Board, das einmal pro Woche tagt, ist nicht vereinbar mit einer Organisation, die Hunderte von Deployments pro Tag anstrebt. Ein 14-tägiger Change-Request-Prozess blockiert die agile Iteration, die die Cloud ermöglichen soll.
Die Antwort lautet nicht: ITIL abschaffen. Die Antwort lautet: ITIL weiterentwickeln.
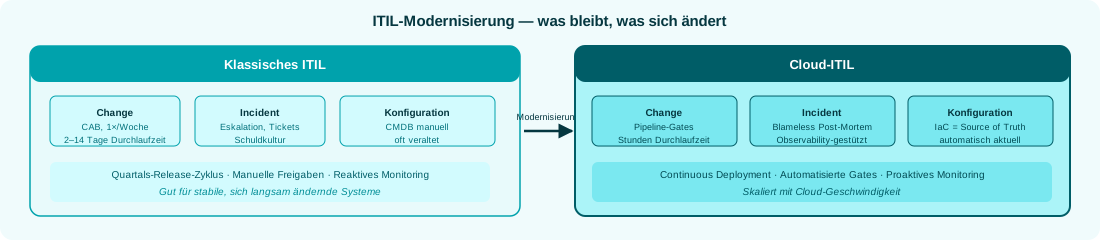
Was von ITIL bleibt:
Was sich grundlegend ändert:
Das klassische Change Management wurde für eine Welt konzipiert, in der jede Änderung an Produktivsystemen manuell, riskant und schwer rückgängig zu machen war. In dieser Welt war ein formaler Freigabeprozess sinnvoll.
In Cloud-Umgebungen mit Infrastructure-as-Code und automatisierten Tests verändert sich die Risikoeinschätzung grundlegend. Ein Terraform-Change, der vor dem Deployment automatisch gegen Policies geprüft, im Staging getestet und von zwei Personen per Pull Request geprüft wurde, hat ein anderes Risikoprofil als eine manuelle Konfigurationsänderung in der Nacht.
Das modernisierte Change-Modell:
Standard Changes (häufig, gut dokumentiert, geringes Risiko) werden vollständig automatisiert. Kein CAB, kein Change-Ticket — die Automatisierung ist der Freigabeprozess. Beispiele: Container-Image-Updates, Konfigurationsänderungen bei bekannten Parametern, Ressourcenskalierung.
Normal Changes (Änderungen an kritischen Systemkomponenten) durchlaufen einen Pull-Request-Prozess mit zwei Reviewern, einer automatisierten Test-Suite und einem Deployment-Window. Das „CAB“ ist die asynchrone Prüfung durch erfahrene Kolleginnen und Kollegen — schneller, effizienter, bei gleichbleibender Sicherheit.
Emergency Changes (kritische Korrekturen in der Produktion) haben einen beschleunigten Prozess mit anschließender Dokumentation. Sie werden im Post-Incident-Review besprochen: Wurde das Notfallverfahren korrekt angewendet? Was verhindert, dass das gleiche Problem noch einmal als Notfall behandelt wird?
Das Kernmodell des Incident Managements — Detection, Triage, Escalation, Resolution, Post-Mortem — ist in Cloud-Umgebungen genauso gültig wie in klassischen IT-Umgebungen.
Was sich ändert, ist die Geschwindigkeit und die Erwartungshaltung.
Detection: Klassisch durch Benutzermeldungen oder manuelles Monitoring. Heute durch automatisierte Observability-Systeme, die Auffälligkeiten erkennen, bevor Nutzer betroffen sind.
Triage: Klassisch durch manuelle Diagnose über SSH und Logfiles. Heute durch zentrale Dashboards, verteiltes Tracing und strukturierte Log-Suche.
Rufbereitschaftsstruktur: Cloud-Umgebungen erfordern eine Rotation der Rufbereitschaft rund um die Uhr. Für viele IT-Organisationen ist dies kulturell die größte Veränderung: Wer hat Rufbereitschaft, wie wird diese vergütet, wie wird Burnout verhindert?
Post-Mortem-Kultur: Fehleranalysen ohne Schuldzuweisung (Blameless Post-Mortems) sind in DevOps-Kulturen Standard — keine Schuldzuweisung, sondern systemisches Lernen. Für ITIL-geprägte Organisationen ist dies häufig ein kultureller Wandel, der Zeit und Engagement der Führungskräfte erfordert.
Die Configuration Management Database (CMDB) war die Antwort von ITIL auf die Frage: Was läuft wo, in welcher Konfiguration, mit welchen Abhängigkeiten zu was sonst? In klassischen Umgebungen war sie wertvoll — und notorisch schwierig aktuell zu halten.
In Cloud-Umgebungen mit Infrastructure-as-Code ist die CMDB kein Primärsystem mehr. Infrastructure-as-Code (Terraform, Ansible) ist die neue CMDB — mit dem entscheidenden Vorteil, dass sie automatisch richtig ist: Was in Terraform steht, ist (nach dem letzten Apply) Realität.
Was dies für die Organisation bedeutet:
SLAs mit den Sparten bleiben wichtig — aber deren Design ändert sich. Klassische SLAs sprachen über die Verfügbarkeit in Prozent auf Monatsbasis. Cloud-SLAs können granularer sein.
Verfügbarkeits-SLA
Monatliche Verfügbarkeit des Services. Basierend auf dem STACKIT Plattform-SLA, reduziert um einen internen Betriebspuffer. Transparent kommuniziert und im Servicekatalog dokumentiert.
Reaktionszeit-SLA
Reaktionszeiten nach Schweregrad. P1 innerhalb von 15 Minuten, P2 innerhalb von 1 Stunde — nicht als Versprechen, sondern als messbare Zusage mit monatlichem Reporting.
Recovery-Time-SLA
RTO und RPO pro Tier-Klasse (Tier 1 bis 4). Nicht als theoretische Kennzahl, sondern als regelmäßig getestete und nachgewiesene Fähigkeit.
Change Lead Time
Wie lange dauert es, bis eine genehmigte Änderung in Produktion ist? Bei Standard Changes: Stunden. Bei Normal Changes: Tage. Nicht Wochen.
ITIL-Prozesse über Nacht abzuschaffen ist genauso falsch, wie sie unverändert in die Cloud zu überführen. Das richtige Vorgehen ist schrittweise.
Bestandsaufnahme: Welche ITIL-Prozesse gibt es? Welche davon machen in der Cloud Sinn, welche erzeugen Reibung?
Quick Wins identifizieren: Die Automatisierung von Standard Changes ist in der Regel schnell umzusetzen und sofort spürbar.
Change-Prozess überarbeiten: CAB-Frequenz erhöhen oder durch asynchrone Prüfung ersetzen. Einführung eines Automatisierungs-Gateways als Alternative zu manuellen Freigaben.
Blameless Post-Mortems einführen: Kulturell fordernd, aber entscheidend für eine kontinuierliche Verbesserung. Die Führung muss vorleben, dass Fehler Lernchancen sind.
CMDB-Strategie anpassen: IaC als primäre Konfigurationsquelle festlegen; die CMDB auf strategische Informationen reduzieren.