Textstellen auf dieser Seite markieren Wählen Sie beliebigen Text aus, oder fahren Sie über einen Absatz, ein Bild, eine Tabelle, eine Karte oder einen Link. Kommentare werden Ihrer Nachricht unten hinzugefügt.
Wählen Sie Text für ein genaues Zitat aus, oder fahren Sie über ein beliebiges Element (Bild, Tabelle, Karte, …), um die Schaltfläche „Kommentar“ zu sehen.
Schreiben Sie einen kurzen Kommentar und speichern Sie ihn.
Er wird Ihrer Nachricht unten automatisch hinzugefügt.
Keine Anmeldung nötig. Wird an das Framework Core Team gesendet. Der Seitenlink wird automatisch hinzugefügt.
Fast fertig!
Senden Sie Ihr Feedback jetzt per E-Mail.
1
Öffnen Sie Ihr E-Mail-Programm und erstellen Sie eine neue E-Mail.
2
Kopieren Sie die E-Mail-Adresse und fügen Sie sie in das An-Feld ein:
3
Kopieren Sie Ihren Feedback-Text und fügen Sie ihn in den E-Mail-Text ein (Strg+V / Cmd+V):
Souveräner, sicherer Cloud-Betrieb braucht lückenlose Automatisierung und regulatorische Resilienz: von standardisierter IaC bis zur Disaster Recovery.
PLAN
Infrastructure-as-Code: der methodische Ansatz
Etablierung von IaC als strategische Führungsentscheidung und schrittweiser Aufbau der IaC-Reife (von manuell über zentralen State bis hin zu automatisierten Compliance-Checks).
Anpassung BetriebsmodelleInfrastructure-as-Code In 1 Trail
Was Infrastructure-as-Code bedeutet — und warum es eine Führungsentscheidung ist
Infrastructure-as-Code ist die Praxis, die Infrastruktur — Server, Netzwerke, Datenbanken, Sicherheitsregeln — schriftlich zu beschreiben, anstatt sie durch manuelle Klicks in einer Konsole zu konfigurieren. Was sich technisch anhört, ist in seiner Wirkung eine Führungsentscheidung: Die Organisation entscheidet, dass Änderungen an der Infrastruktur dokumentiert, nachvollziehbar und überprüfbar sein müssen — wie jede andere wichtige Entscheidung.
Diese Entscheidung hat tiefgreifende organisatorische Konsequenzen. Infrastrukturdokumentation veraltet nicht mehr, da das System immer mit dem übereinstimmt, was geschrieben wurde. Neue Umgebungen — ein zweiter Standort, eine zusätzliche Testumgebung, Disaster Recovery — entstehen nicht durch tagelange Konfigurationsarbeit, sondern durch Wiederholung von bestehendem Code. Fehler werden abgefangen, bevor sie auftreten, da Änderungen explizit gemacht werden und überprüft werden können.
Die Entscheidungen, die vor der ersten Zeile Code stehen
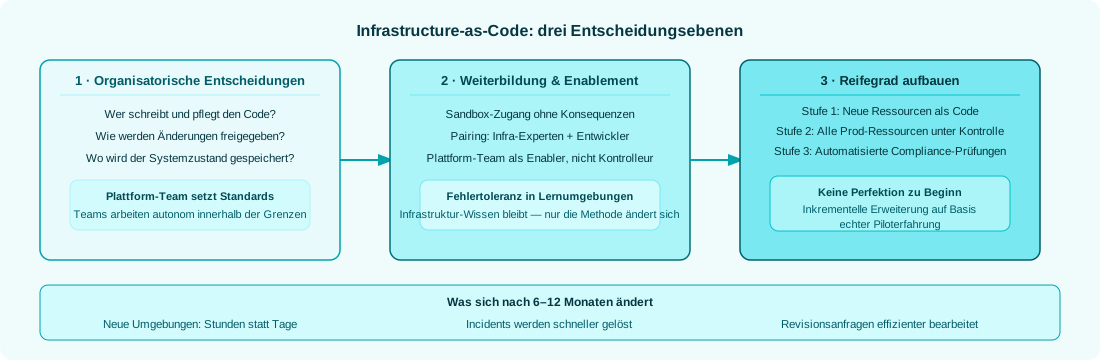
Bevor die erste Infrastrukturbeschreibungsdatei geschrieben wird, müssen drei organisatorische Fragen beantwortet werden. Sie bestimmen, ob IaC zu einem stabilen Betriebsmodell wird oder ein gut gemeinter Ansatz bleibt, der in der Praxis nicht gelebt wird.
Wer schreibt und pflegt die Infrastrukturbeschreibungen? Problematisch sind beide Extremantworten. Wenn nur das Plattform-Team Code schreibt, entsteht ein Engpass: Teams müssen auf Infrastruktur warten, anstatt eigenständig zu arbeiten. Wenn jedes Team völlig autonom ohne gemeinsame Standards agiert, entsteht ein unvereinbares Gewirr von Vorgehensweisen. Der methodisch richtige Weg liegt in der Mitte: Das Plattform-Team setzt Standards und stellt wiederverwendbare Bausteine bereit. Innerhalb dieser Grenzen arbeiten die Teams eigenverantwortlich.
Wie werden Änderungen an Produktivumgebungen freigegeben? Eine Infrastrukturänderung in der Produktion durch eine Person, ohne Prüfung, ohne Aufzeichnung — das ist das gleiche Risiko wie manuell in die Konsole zu klicken, nur schwerer rückgängig zu machen. Die sinnvolle Vorgabe ist, dass Änderungen in der Produktionsumgebung immer einen freigegebenen automatisierten Prozess durchlaufen, niemals direkt von Hand.
Wo wird der Systemzustand gespeichert? IaC-Tools verwalten den Zustand: Was ist aktuell deployt? Dieser Zustand ist entscheidend für das Funktionieren des gesamten Ansatzes. Er muss sicher, zentral und für das Team zugänglich aufbewahrt werden — niemals auf dem Laptop einer Person, niemals in einem öffentlich zugänglichen System.
Infrastructure-as-Code ändert die Anforderungen an Personen, die Infrastruktur verwalten. Dies ist nicht in erster Linie eine technische Herausforderung, sondern eine Lernkurve, die Zeit, Übung und eine fehlertolerante Lernumgebung erfordert.
Was sich ändert
Systemadministratoren, die über Jahre hinweg Infrastruktur über Konfigurationsoberflächen
gemanagt haben, müssen ein anderes Denkmodell entwickeln: Statt „Ich klicke auf Erstellen“
denken sie „Ich beschreibe den gewünschten Zustand“. Diese Verschiebung ist lernbar, braucht
aber Zeit und ist nicht zu unterschätzen.
Was bleibt
Das Infrastruktur-Wissen bleibt — und ist der größte Vorteil. Wer die Funktionsweise von
Netzwerken, Security Groups und Datenbanken versteht, lernt die neue Beschreibungsform schnell.
Technisches Wissen muss nicht neu aufgebaut werden, nur die Methode, es anzuwenden.
Was eine gute Lernumgebung braucht
Sandbox-Zugriff für folgenloses Experimentieren, Pairing mit erfahreneren Kolleginnen und
Kollegen, keine Bestrafung von Fehlern in Testumgebungen. Wer beim Lernen Fehler macht, lernt.
Wer Fehler macht und dafür kritisiert wird, hört auf zu lernen.
Die Rolle des Plattform-Teams
Das Plattform-Team ist in dieser Phase kein Kontrollorgan, sondern ein Enabler. Es stellt
Lernmaterialien zur Verfügung, beantwortet Fragen, überprüft Code gemeinsam mit den Teams —
nicht zum Bewerten, sondern zum Lehren.
Die Umstellung auf Infrastructure-as-Code ist kein Projekt mit Startdatum und Abschluss. Es handelt sich um eine Reifekurve, die sich über Monate und Jahre entfaltet. Wichtig ist, die aktuelle Position zu kennen und den nächsten sinnvollen Schritt zu gehen — nicht zu versuchen, sofort den höchsten Reifegrad zu erreichen.
Die erste Stufe ist die einfachste: Neue Ressourcen werden als Code beschrieben, bestehende Ressourcen bleiben vorerst manuell. Dies ist unvollständig, aber ein echter Anfang. Jedes neue Stück Infrastruktur, das als Code entsteht, ist eine Ressource, die das Team vollständig versteht, dokumentiert hat und wiederherstellen kann.
Die zweite Stufe bringt alle Produktionsressourcen unter Code-Kontrolle und führt einen zentralen Zustandsspeicher ein. Manuelle Änderungen an Produktivumgebungen werden zur Ausnahme, die dokumentiert werden muss.
Die dritte Stufe verbindet IaC mit automatisierten Qualitäts- und Compliance-Prüfungen. Änderungen werden nicht nur geprüft, sondern vor der Ausführung automatisch anhand von Sicherheits- und Governance-Anforderungen bewertet.
Infrastructure-as-Code ist nicht das Ziel, sondern das Mittel. Ziel ist eine Cloud-Umgebung, die nachvollziehbar, sicher, reproduzierbar und revisionssicher ist. IaC ist der effizienteste Weg dorthin.
Organisationen, die IaC einführen, melden in der Regel drei Auswirkungen nach sechs bis zwölf Monaten: Neue Umgebungen entstehen innerhalb von Stunden, nicht Tagen; Infrastruktur-Incidents werden schneller gelöst, da der Weg zurück in den Ausgangszustand bekannt ist; und Revisionsanfragen werden effizienter bearbeitet, da die Zustandsdokumentation automatisch erstellt wird.
Diese Effekte sind motivierender als jeder abstrakte Verweis auf Best Practices.
Startpunkt definieren: Mit welchem Teil der Infrastruktur beginnen? Neue Ressourcen in einer unkritischen Umgebung sind der risikoärmste Einstieg. Bestehende komplexe Produktionsinfrastruktur ist kein guter Ausgangspunkt.
Standards und Bausteine bereitstellen: Das Plattform-Team entwickelt wiederverwendbare Beschreibungen für gängige Infrastrukturkomponenten. Diese Bausteine sind der Hebel, mit dem Teams schnell starten können, ohne jeden Schritt neu erfinden zu müssen.
Die Weiterbildung begleiten: Teams erhalten Lernzeit, Sandbox-Zugriffe und Unterstützung. Dieser Schritt wird häufig unterschätzt — und ist der häufigste Grund für das Stocken von IaC-Einführungen.
Pilot abschließen und auswerten: Was hat funktioniert? Was war schwieriger als gedacht? Was muss angepasst werden? Diese Auswertung ist die Grundlage für den weiteren Rollout.
Inkrementell erweitern: Auf Basis der Piloterfahrung weitere Teams hinzuziehen, bis alle Produktionsressourcen unter Code-Kontrolle stehen.
BASE
CI/CD: Lieferfähigkeit als Organisationsprinzip
Aufbau automatisierter Deployment-Pipelines mit integrierten, automatischen Qualitäts- und Compliance-Prüfungen vor der Produktivschaltung.
Anpassung BetriebsmodelleCI/CD-Pipelines In 1 Trail
Was CI/CD wirklich bedeutet — über die Tools hinaus
Continuous Integration und Continuous Deployment sind keine Werkzeuge. Sie sind Organisationsprinzipien — eine Entscheidung darüber, wie eine Organisation Software entwickelt, validiert und betreibt.
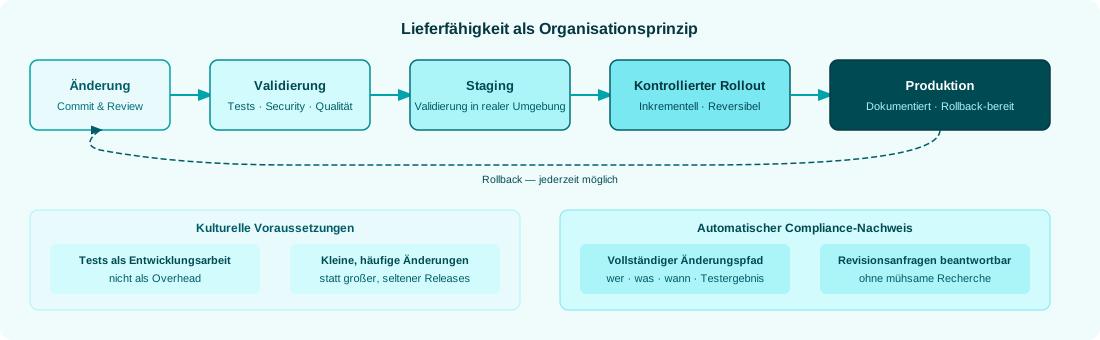
Die Kernidee ist einfach: Anstatt Änderungen selten, manuell und riskant in die Produktion zu bringen, werden sie häufig, automatisch und kontrolliert geliefert. Jede Änderung durchläuft die gleichen Qualitätsprüfungen. Jede Änderung wird dokumentiert. Jede Änderung kann rückgängig gemacht werden.
Organisationen, die diesen Weg einschlagen, liefern nicht schneller, weil sie weniger sorgfältig arbeiten. Sie liefern schneller, weil sie die Sorgfalt automatisiert haben.
Bevor eine CI/CD-Pipeline aufgebaut wird, müssen zwei kulturelle Voraussetzungen gegeben sein. Ohne sie wird jede technische Implementierung an der Organisation scheitern.
Tests sind keine optionalen Zusatzarbeiten. Eine Pipeline, die automatisch prüft, kann nur so gut sein wie die Tests, die sie durchführt. Wenn Tests als lästige Pflicht angesehen werden, um so schnell wie möglich durchzukommen, wird die Pipeline zur Formalität — ein grünes Licht, das nichts bedeutet. Tests sind als integraler Bestandteil der Entwicklungsarbeit zu verstehen, nicht als Overhead am Ende.
Kleine, häufige Änderungen statt großer, seltener Releases. Die größten Risiken bei Softwareänderungen ergeben sich aus der Größe der Änderung: Je größer das Paket, desto schwieriger die Fehlersuche, desto größer die Auswirkungen, wenn etwas schiefgeht. CI/CD funktioniert am besten, wenn Teams lernen, Änderungen in kleinere, lieferbare Einheiten zu zerlegen. Diese Arbeitsweise muss man lernen — sie ist nicht selbstverständlich für Teams, die an monatliche Releases gewöhnt sind.
Quality Gates in einer Pipeline sind Entscheidungen, keine technischen Vorgaben. Was muss
passieren, bevor eine Änderung in die Produktion gelangt? Welche Tests sind verpflichtend?
Welche Sicherheitsprüfungen sind nicht verhandelbar? Diese Gates bewusst zu setzen und zu
dokumentieren, warum sie gesetzt wurden, ist wichtiger als die technische Konfiguration.
Wer verantwortet den Betrieb der Pipeline?
Eine Pipeline ist selbst Software — sie muss gewartet, aktualisiert und schnell analysiert
werden, wenn Probleme auftreten. Bei unklarer Zuständigkeit werden Probleme ignoriert oder
umgangen. Das Plattform-Team sollte Eigentümer der Pipeline-Infrastruktur sein; einzelne Teams
besitzen die Tests und Prüfungen, die ihre Änderungen durchlaufen.
Wie wird mit ausgefallenen Pipelines umgegangen?
Wie die Organisation mit roten Pipelines umgeht, ist eine Kulturfrage. Werden Ausfälle sofort
behoben? Oder häufen sie sich an, weil „der Test seit Wochen ausfällt, aber nie ein echtes
Problem war“? Eine ausgefallene Pipeline, die niemanden mehr alarmiert, gibt keine Sicherheit
mehr.
Was passiert, wenn etwas schiefgeht?
Ein Rollback-Prozess muss definiert werden, bevor er benötigt wird — nicht in dem Moment, in dem
ein kritisches Problem aufgetreten ist. Wie lange dauert ein Rollback? Wer kann einen auslösen?
Welche Teams müssen informiert werden? Es ist viel besser, diese Fragen vorab in Ruhe zu
beantworten, als sie unter Druck zu beantworten.
Die größte Gefahr beim Deployment ist die Irreversibilität: eine Änderung, die ein Problem verursacht, und kein schneller Weg zurück. Deployment-Strategien adressieren dies durch die kontrollierte Einführung von Änderungen.
Die einfachste Strategie, Änderungen schrittweise an einen wachsenden Anteil der Benutzer auszurollen, ermöglicht es, Probleme zu erkennen, bevor alle Benutzer betroffen sind. Wenn etwas schiefläuft, sind fünf Prozent der Nutzer betroffen, nicht hundert. Rollback ist eine Entscheidung, keine Katastrophe.
Eine ausgeklügeltere Strategie — eine neue Version parallel zur alten laufen zu lassen, bis die neue Version ihre Funktionsfähigkeit gezeigt hat — eliminiert das Ausfallrisiko vollständig. Sollte die neue Version Probleme aufweisen, wird wieder auf die alte umgestellt. Bei keinem Benutzer ist ein Ausfall aufgetreten.
Welche Strategie für welchen Kontext die richtige ist, hängt von der Kritikalität des Workloads und dem Reifegrad des Teams ab. Eine hochkritische Produktionsumgebung benötigt andere Sicherheitsmechanismen als ein internes Tool.
Automatisierte Qualitätssicherung als Dokumentation
Ein oft übersehener Wert von CI/CD ist die Dokumentation. Jede Änderung, die über eine Pipeline läuft, hinterlässt Spuren: Was wurde wann geändert, von wem, welche Prüfungen wurden durchgeführt, war das Ergebnis positiv?
Für Organisationen, die regulatorischen Anforderungen unterliegen, ist dies kein Nebeneffekt — es ist ein Compliance-Asset. Anstatt Audit-Anfragen mühsam aus Protokollen und Erinnerung zusammenzustellen, gibt es einen vollständigen, unveränderlichen Pfad für jede Produktionsänderung. Dies reduziert den Revisionsaufwand erheblich.
Wählen Sie einen einzelnen Piloten: Identifizieren Sie einen Workload, bei dem das Team motiviert und bereit ist, Risiken einzugehen. Kein Kernproduktionsdienst, aber ein wichtiger, unkritischer. Bauen Sie die erste Pipeline zusammen mit dem Team auf — damit das Team die Pipeline versteht und besitzt, anstatt sie nur zu nutzen.
Quality Gates definieren: Was soll diese Pipeline prüfen? Was wird blockiert? Diese Entscheidungen werden mit dem Team besprochen und dokumentiert. Keine automatische Übernahme von Vorgaben — jedes Gate hat eine Begründung.
Auswertung der Pilotphase: Was ist gut gelungen? Was hat zu Reibung geführt? Was hätte verhindert werden sollen? Diese Überprüfung ist die Grundlage für den breiteren Rollout und sollte ehrlich durchgeführt werden.
Rollout mit Unterstützung statt Druck: Mehr Teams hinzuziehen — mit Unterstützung, nicht per Anweisung. Teams, die Pipelines als Einschränkung erleben, entwickeln Workarounds. Teams, die Pipelines als Schutz erleben, pflegen diese.
Qualität messen und lernen: Wie lange dauert ein Change von der Entwicklung bis zur Produktion? Wie oft fällt die Pipeline aus und warum? Diese Metriken — nicht als Kontrollmechanismus, sondern als Lernquelle — zeigen auf, wohin investiert werden sollte.
CI/CD und Infrastructure-as-Code sind keine getrennten Themen. In einer ausgereiften Umgebung werden Infrastrukturänderungen genauso behandelt wie Anwendungsänderungen: Sie laufen über eine Pipeline, werden automatisch geprüft, und Änderungen in Produktivumgebungen erfolgen ausschließlich über diesen freigegebenen Prozess. Dieses Zusammenspiel — Anwendungscode und Infrastrukturcode in denselben Qualitätsprozessen — ist das Kennzeichen einer ausgereiften Cloud-Betriebskultur.
STEP
Landing Zone
Bereitstellung standardisierter Platform- und Application-Landing-Zones zur Vererbung von Sicherheitsvorgaben an die Produktteams.
Eine Landing Zone ist das strukturierte Cloud-Fundament, das definiert, wie Ihre Organisation ab
Tag 1 auf STACKIT operiert. Sie kombiniert Governance, Identität, Sicherheit, Netzwerkdesign,
Kostenkontrolle und Automatisierung zu einer kohärenten Baseline.
Ohne diese Grundlage bleiben Migrationswellen in der Regel aufgrund von fehlenden Freigaben,
inkonsistenten Kontrollen und wiederholten Plattformentscheidungen stehen.
Das folgende Bild fasst die Kernkomponenten zusammen, die für eine zuverlässige Plattform-Baseline
berücksichtigt werden sollten. Diese sechs Bausteine bilden ein sicheres Plattformfundament:
Account Governance — Projektstruktur, Hierarchie und Eigentumsmodell
Identity & Access Management — Benutzer, Rollen und föderierte Identität
Security & Compliance — Leitplanken, Richtlinien und Compliance-Kontrollen
Netzwerkarchitektur — Segmentierung, Konnektivität und Verkehrssteuerung
Kostenmanagement und -kontrolle — Sichtbarkeit von Tagging, Budgets und Ausgaben
Automatisierung (IaC) — Infrastructure as Code, Pipelines und Drifterkennung
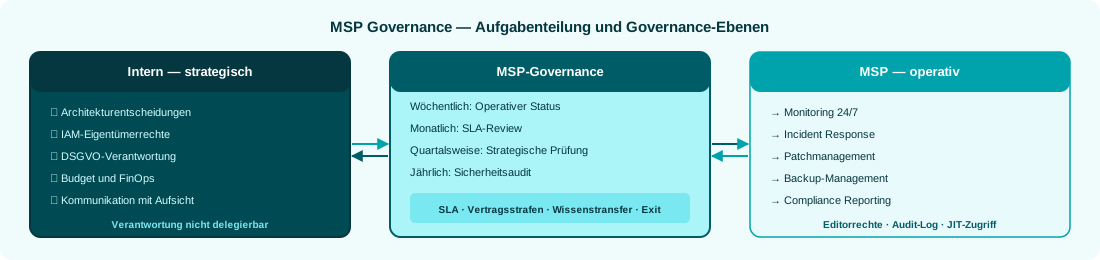
Viele Organisationen beschließen, Teile ihres Cloud-Betriebs an einen Managed Service Provider (MSP) auszulagern. Die Entscheidung ist oft richtig — der Betrieb wird zuverlässiger, interne Teams können sich auf strategische Themen konzentrieren.
Was häufig unterschätzt wird: Die MSP-Beziehung zu steuern, ist an sich schon eine anspruchsvolle Aufgabe. Wer keinen strukturierten Steuerungsprozess aufbaut, verliert nach und nach die Kontrolle über die eigene Cloud-Umgebung — ohne es zu merken.
Penalties and Credits:
Ohne wirtschaftliche Konsequenzen bei SLA-Verstößen haben SLAs wenig Lenkungseffekt. Typisch: Gutschrift von 10–30 % der monatlichen Service Fee bei nachgewiesener SLA-Unterdeckung.
Subunternehmerregelungen:
Welche Aufgaben darf der MSP weiter delegieren? Jede Weiterübertragung muss transparent sein und den gleichen Datenschutz- und Sicherheitsstandards genügen — relevant für DSGVO Art. 28 Abs. 4.
Ausstiegsregelungen:
Wie wird die Übergabe an einen anderen Anbieter bzw. zurück an das interne Team geregelt? Fristen, Wissenstransferpflichten, Dokumentationsübergabe, Zugangsrückgabe.
Der häufigste Governance-Fehler: Der MSP hat zu viele Rechte, zu lange.
Best Practice für MSP-Zugriffe:
Keine permanenten Admin-Rechte — stattdessen Just-in-Time-Zugriff für Wartungsfenster
Dedizierte MSP-Konten (keine Verwendung von Mitarbeiterkonten)
Alle MSP-Aktivitäten im Audit-Log ersichtlich
Monatliche Überprüfung der aktiven MSP-Berechtigungen
Sofortige Deaktivierung zum Vertragsende
Das interne IAM-Team (oder CCoE) behält die Eigentümerrechte an allen Projekten. Der MSP agiert mit Editorrechten in definierten Scopes — nie mit Eigentümerrechten.
MSP Governance braucht Struktur. Ohne eine regelmäßige Überprüfung tendiert die Beziehung in eine Richtung, die der Kunde nicht mitbekommt — bis ein Problem entsteht.
Hat der MSP nachweisbare Erfahrung mit STACKIT? Gibt es Referenzkunden aus ähnlichen Branchen?
STACKIT-zertifizierte Partner bieten einen strukturierten Einstieg.
Compliance-Expertise
Versteht der MSP die regulatorischen Anforderungen Ihrer Branche? DSGVO, TISAX, BAIT, KRITIS —
ein MSP ohne Compliance-Know-how ist für regulierte Umgebungen ungeeignet.
Transparente Prozesse
Kann der MSP seinen Incident-Response-Prozess, seine Change-Management-Verfahren und sein
Sicherheitskonzept vorstellen? Anbieter, die diesen Fragen ausweichen, sind ein Risiko.
Exit-Bereitschaft
Ein seriöser MSP gestaltet die Ausstiegsklausel aktiv mit — weil er weiß, dass eine gute
Beziehung die beste Kundenbindung ist. Wer Ausstiegsvorsorge blockiert, schafft Abhängigkeit.
Umfang definieren — Was wird ausgelagert, was bleibt intern? Schriftlich, als Grundlage für die Ausschreibung.
Ausschreibung oder Auswahl des MSP — Mindestens drei Angebote, eine strukturierte Bewertungsmatrix, Referenzgespräche mit Bestandskunden.
Vertragsverhandlung — SLAs, Vertragsstrafen, Subunternehmerregelung, Austrittsklausel, DSGVO-Auftragsverarbeitungsvertrag. Eine auf Cloud-Verträge spezialisierte Rechtsberatung wird empfohlen.
Review-Rhythmus festlegen — Wöchentliche, monatliche und quartalsweise Überprüfungen im Kalender verankern. Agenda-Vorlagen erstellen.
Dokumentationspflicht schriftlich vereinbaren — Was liefert der MSP, in welchem Format, in welchem Intervall? Als Vertragsbestandteil, keine verbale Zusicherung.
Die SLA-Anforderungen für MSPs leiten sich aus den DR-Tier-Klassifizierungen der betroffenen Workloads ab. Der interne Servicekatalog definiert, welche Services die IT selbst erbringt und welche der MSP übernimmt.
GOAL
Disaster Recovery und Business Continuity
Proaktive Definition, Dokumentation und regelmäßige Simulation von RTO- und RPO-Zielen für geschäftskritische Systeme auf STACKIT.
Anpassung BetriebsmodelleDisaster Recovery In 1 Trail
Disaster Recovery ist die Disziplin, die niemand praktiziert — bis sie muss. Dann kostet jede Entscheidung, die früher hätte getroffen werden können, Geld und Vertrauen.
Für die meisten Organisationen ist die Cloud-Migration der Moment, in dem DR-Anforderungen zum ersten Mal schriftlich definiert werden. Das ist die Chance: klar, verhältnismäßig und getestet.
Jedes System hat eine implizite Wiederherstellungszeit und einen akzeptablen Schwellenwert für Datenverlust. Die meisten Organisationen kennen diese Zahlen nicht — und zahlen den Preis dafür, wenn ein Vorfall eintritt.
Recovery Time Objective (RTO): Wie lange darf ein System nach einem Ausfall nicht verfügbar sein? Eine RTO von 4 Stunden bedeutet: Nach spätestens 4 Stunden muss das System wieder funktionsfähig sein.
Recovery Point Objective (RPO): Wie viel Datenverlust ist akzeptabel? Ein RPO von 1 Stunde bedeutet: Maximal dürfen die letzten 60 Minuten Daten verloren gehen.
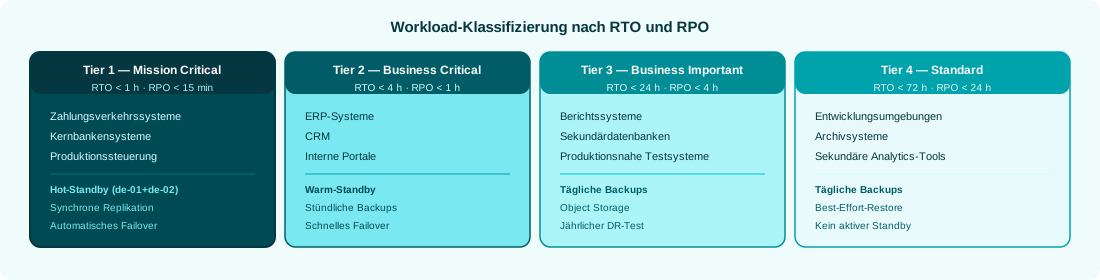
Die wichtige Regel: Je aggressiver RTO und RPO, desto höher die laufenden Kosten. Eine RTO von 15 Minuten bei einem RPO von 5 Minuten erfordert Hot-Standby-Umgebungen. Eine RTO von 24 Stunden bei einem RPO von 12 Stunden kann durch tägliche Sicherungen und manuelle Prozesse eingehalten werden.
Die richtige Antwort ist: verhältnismäßig, nicht maximalistisch.
Systeme, die innerhalb weniger Stunden wiederhergestellt werden müssen, deren Ausfall aber kurzfristig tolerierbar ist. Beispiele: ERP-Systeme, CRM, interne Portale.
Tier 3 — Business Important (RTO < 24 h, RPO < 4 h)
Systeme, die innerhalb eines Arbeitstages wiederhergestellt werden können. Beispiele: Berichtssysteme, Sekundärdatenbanken, produktionsnahe Testsysteme.
Für regulierte Branchen ist DR keine freiwillige Best Practice, sondern eine regulatorische Anforderung.
BAIT (Banken): Erfordert dokumentierte Notfallpläne, regelmäßige Tests und Ausfallszenarien für alle wesentlichen IT-Systeme. Wiederherstellungsziele müssen von der Geschäftsleitung freigegeben werden.
KRITIS (kritische Infrastruktur): Verpflichtet KRITIS-Betreiber zum Business Continuity Management nach BSI IT-Grundschutz bzw. ISO 22301. DR-Tests sind verpflichtend; Ergebnisse sind zu dokumentieren.
DSGVO: Art. 32 erfordert die Fähigkeit, die Verfügbarkeit von personenbezogenen Daten nach einem Vorfall wiederherzustellen. Ein RPO von mehr als 24 Stunden für DSGVO-relevante Systeme ist nur schwer zu begründen.
DORA (Digital Operational Resilience Act, ab Januar 2025): Verpflichtet Finanzinstitute zu einem umfassenden IKT-Risikomanagement mit expliziten BCM-Anforderungen und verpflichtenden Resilienz-Tests.
STACKIT als Partner: STACKIT betreibt in Deutschland Rechenzentren mit ISO-27001- und SOC-2-Zertifizierung. Die Datenresidenz in de-01/de-02 stellt sicher, dass Backup-Daten Deutschland nicht verlassen — ein entscheidender Vorteil für regulierte Industrien.
DR-Tests — warum sie selten stattfinden und wie man das ändert
Der häufigste DR-Fehler ist, den Plan nie zu testen. DR-Tests werden regelmäßig verschoben, weil die Produktionsumgebung als zu kritisch gilt, um ein simuliertes Failover zu riskieren, weil keine klare Verantwortlichkeit für DR-Tests besteht und weil Tests als Aufwand ohne direkten Nutzen angesehen werden.
Die Lösung: DR-Tests als regelmäßiges Engineering-Ritual verankern, nicht als Ausnahmeereignis.
Vier Testformate in aufsteigender Intensität:
1. Tabletop-Übung (jährlich, geringer Aufwand): Das Team bearbeitet gemeinsam ein Ausfallszenario — am Whiteboard. Keine Systeme werden berührt. Identifiziert Lücken in Prozessen und Verantwortlichkeiten.
2. Komponententest (quartalsweise): Ein bestimmter Backup- oder Failover-Mechanismus wird in der Staging-Umgebung getestet. Dauer: einige Stunden.
3. Teil-Failover-Test (halbjährlich): Ein nicht produktionskritisches System wird tatsächlich auf den Standby-Standort geschaltet. Misst die tatsächliche RTO. Dauer: ein halber Tag.
4. Vollständige DR-Übung (jährlich): Vollständige Simulation eines Rechenzentrumsausfalls für alle Tier-1- und Tier-2-Systeme. Erfordert Planung und Abstimmung mit Stakeholdern. Liefert die echten Nachweise für die Aufsichtsbehörden.
Verabschiedet RTO/RPO-Ziele, fungiert im Notfall als Eskalationsinstanz, gibt DR-Tests frei und
berichtet Ergebnisse an Vorstand und Aufsichtsbehörden.
Plattform-Team
Implementiert und wartet die DR-Infrastruktur, führt Komponententests durch, dokumentiert
Wiederherstellungsverfahren.
Applikationseigentümer
Klassifizieren ihre Systeme in Tier-Klassen, definieren applikationsspezifische
Wiederherstellungsschritte, nehmen an Tabletop-Übungen teil.
STACKIT
Gewährleistet die Verfügbarkeit der Cloud-Infrastruktur gemäß SLA, stellt
Zone-zu-Zone-Replikation bereit, liefert Audit-Logs für behördliche Nachweise.
Inventur und Klassifizierung aller Systeme — Tier-Zuordnung für jeden Workload, dokumentiert und durch die Sparte bestätigt.
RTO-/RPO-Ziele durch Vorstand oder CIO genehmigen lassen — Keine IT-Entscheidung, sondern eine Business-Entscheidung mit Auswirkungen auf die Kosten.
DR-Architektur pro Tier umsetzen — Vom einfachen Backup im Object Storage bis zum Hot Standby in der zweiten STACKIT-Zone.
Wiederherstellungsverfahren dokumentieren — Als Runbook, nicht als Konzept. Konkrete Schritte, die im Notfall ohne weitere Rückfragen ausgeführt werden können.
Die erste Tabletop-Übung durchführen — Innerhalb von 30 Tagen nach Produktivsetzung. Ergebnis: eine Liste der offenen Punkte mit Eigentümer und Termin.
Einen DR-Testkalender etablieren und pflegen — Quartalsweise Komponententests, halbjährlich partielles Failover, jährlich vollständige Übung.
Externer Link
Sie verlassen die Route
Dieser Link führt zu einer externen Seite außerhalb von STACKIT. Fremde Inhalte und Downloads prüfen wir nicht, folgen Sie dem Pfad nur, wenn Sie der Quelle vertrauen.