Textstellen auf dieser Seite markieren Wählen Sie beliebigen Text aus, oder fahren Sie über einen Absatz, ein Bild, eine Tabelle, eine Karte oder einen Link. Kommentare werden Ihrer Nachricht unten hinzugefügt.
Wählen Sie Text für ein genaues Zitat aus, oder fahren Sie über ein beliebiges Element (Bild, Tabelle, Karte, …), um die Schaltfläche „Kommentar“ zu sehen.
Schreiben Sie einen kurzen Kommentar und speichern Sie ihn.
Er wird Ihrer Nachricht unten automatisch hinzugefügt.
Keine Anmeldung nötig. Wird an das Framework Core Team gesendet. Der Seitenlink wird automatisch hinzugefügt.
Fast fertig!
Senden Sie Ihr Feedback jetzt per E-Mail.
1
Öffnen Sie Ihr E-Mail-Programm und erstellen Sie eine neue E-Mail.
2
Kopieren Sie die E-Mail-Adresse und fügen Sie sie in das An-Feld ein:
3
Kopieren Sie Ihren Feedback-Text und fügen Sie ihn in den E-Mail-Text ein (Strg+V / Cmd+V):
Regulierte Unternehmen auf dem Weg zu einer rechtssicheren, digital souveränen Cloud: Souveränitätsstufen, Governance-Leitplanken und ein Readiness-Gate.
PLAN
Souveränitätsstrategie & Cloud Advisory
Einteilung von Workloads in ein 3-Tier-Souveränitätsmodell (Sovereignty-mandatory, Sovereignty-preferred, Flexible) zur Risikominimierung (z. B. CLOUD Act).
Cloud-Zielbild & StrategieSouveränitätsstrategie In 1 Trail
Warum Souveränität eine Strategie und kein Feature ist
Viele Organisationen behandeln Datenhoheit als Compliance-Kästchen. Das ist ein Fehler. Souveränität ist eine strategische Entscheidung mit tiefgreifenden Folgen für Anbieterauswahl, IT-Architektur, Vertragsgestaltung und Wettbewerbspositionierung.
Die Kernfrage ist nicht: „Sind wir DSGVO-konform?“
Die Kernfrage lautet: „Wer hat im Notfall Zugriff auf unsere Daten — und können wir das steuern?“
Der CLOUD Act: ein konkretes Risiko für regulierte Industrien
Der US CLOUD Act (Clarifying Lawful Overseas Use of Data Act, 2018) ermächtigt US-Behörden, von US-Unternehmen Zugriff auf Daten zu fordern — unabhängig davon, wo diese physisch gespeichert sind.
Die Realität: Selbst wenn sich Ihre Daten in einem Rechenzentrum in Frankfurt befinden, kann ein US-Provider gesetzlich verpflichtet sein, diese Daten an US-Behörden herauszugeben.
Für Organisationen in stark regulierten Bereichen ist dies kein theoretisches Risiko, sondern ein konkreter Compliance- und operativer Engpass:
STACKIT (die digitale Marke von Schwarz Digits, dem IT-Powerhouse der Schwarz Gruppe) bietet eine klare Alternative zu außereuropäischen Hyperscalern. Es ist darauf ausgelegt, Drittlandzugriffsrisiken vollständig zu eliminieren.
Rechtshoheit: Daten werden ausschließlich unter europäischer Rechtsprechung gespeichert und verarbeitet, abgeschirmt von extraterritorialen Gesetzen.
Technologische Freiheit: Open-Source-Architekturen sorgen für maximale Transparenz, Code-Prüfbarkeit und problemlose Interoperabilität.
Organisatorische Unabhängigkeit: Migrationsmuster und Ausstiegsstrategien sind so konzipiert, dass Sie immer die absolute Kontrolle über Ihre operativen Daten behalten.
Wirtschaftliche Stabilität: Gestützt auf die Finanzkraft der Schwarz Gruppe, die eine langfristige operative Lebensfähigkeit frei von volatilen Marktveränderungen sicherstellt.
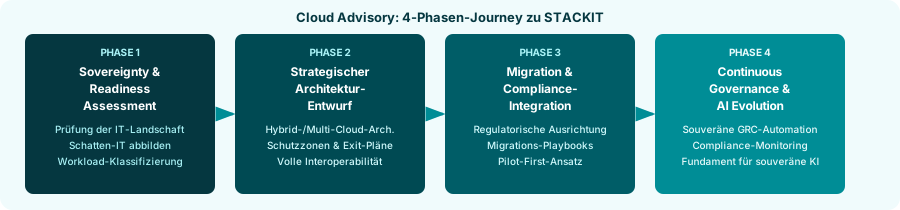
Der Übergang in eine souveräne Cloud erfordert eine strukturierte Roadmap. Wir begleiten Ihre Organisation von der Erstbewertung bis zum vollständig konformen, kontinuierlichen Betrieb auf STACKIT.
Wir prüfen Ihre aktuelle IT-Landschaft, um Abhängigkeiten von Drittanbietern zu identifizieren, bilden Schatten-IT ab und klassifizieren Ihre bestehenden Workloads basierend auf regulatorischen und organisatorischen Anforderungen.
Wir gestalten hybride oder Multi-Cloud-Zielarchitekturen unter Verwendung von Open-Source-Standards. Dies beinhaltet die Einrichtung von Schutzzonen, die Planung von Ausstiegsstrategien und die Sicherstellung einer vollständigen Interoperabilität.
Wir gleichen die nativen Sicherheitskontrollen von STACKIT an Ihren spezifischen Ordnungsrahmen (BSI IT-Grundschutz, ISO 27001, DSGVO) an. Anschließend führen wir Migrations-Playbooks durch, beginnend mit risikoarmen Piloten, bevor wir Kernsysteme verschieben.
Wir etablieren souveräne GRC-Automation (Governance, Risk, Compliance) und schaffen die Voraussetzungen für sichere, souveräne KI-Modelle, die vollständig auf der sicheren Infrastruktur von STACKIT gehostet werden.
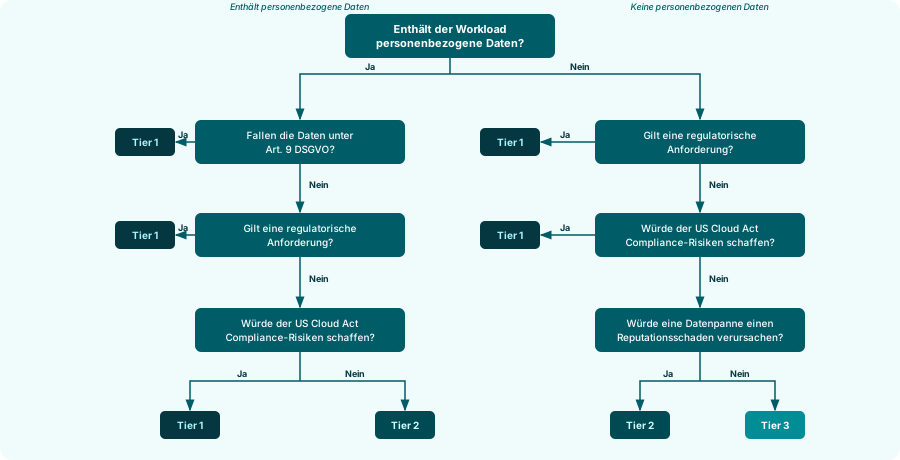
Nicht alle Workloads haben die gleichen Souveränitätsanforderungen. Um Over-Engineering oder unnötige Kosten zu vermeiden, klassifizieren wir Ihre Anwendungen in drei verschiedene Tiers:
Kriterien: Regulatorische oder vertragliche Verpflichtung zur lokalen Datenspeicherung und -verarbeitung; Daten, die bei Zugriff durch ausländische Behörden erhebliche Haftungsrisiken mit sich bringen; sensible personenbezogene Daten (Art. 9 DSGVO).
Beispiele: Stammdaten von Kunden, Gesundheitsakten, Finanztransaktionen, TISAX-klassifizierte Entwicklungsdateien und KRITIS-Kontrollsysteme.
Voraussetzung: Ausschließlich STACKIT (oder gleichwertige Sovereign Cloud). Kein Deployment auf US-Hyperscalern.
Kriterien: Kein hartes Regulierungsveto, aber erhöhter Schutzbedarf. Daten, deren Kompromittierung Reputationsschäden oder Wettbewerbsnachteile verursachen würde.
Beispiele: ERP-Systeme, HR-Datenbanken (ohne besondere Kategorien von personenbezogenen Daten), interne Kommunikationsplattformen und eigene Produktdesigns.
Anforderung: STACKIT bevorzugt; andere sichere europäische Anbieter akzeptabel. US-Hyperscaler sind nicht zu empfehlen.
Kriterien: Keine personenbezogenen Daten, nicht sensible Betriebsdaten oder öffentlich zugängliche Werte, bei denen Schnelligkeit und globale Reichweite strikte Souveränität überwiegen.
Beispiele: Öffentliche Webseiten, CDN-Inhalte, Open-Source-Build-Artefakte und isolierte Entwicklungs-Sandboxes.
Ihre digitale Souveränität zu sichern ist ein aktiver Prozess. Wir arbeiten mit Ihren Teams zusammen, um diese unmittelbaren, praktischen Schritte auszuführen:
Schritt 1: Workload-Inventar erstellen — Erstellen Sie ein übergreifendes Verzeichnis aller Applikationen und deren jeweiliger Datenkategorien
Schritt 2: Souveränitätsworkshop — CISO, DSB und Rechtsabteilung zusammenbringen, um die dreistufige Einordnung abzuschließen
Schritt 3: Souveränitätsmatrix etablieren — Ein lebendiges, geprüftes Dokument aufsetzen, das klare Ownership- und Hosting-Regeln für jeden Workload zuweist
Schritt 4: Benennung eines Data Sovereignty Officer — Definieren Sie klare Verantwortlichkeit und Souveränitäts-Governance für den Cloud-Betrieb
Schritt 5: Vertragliche Absicherung — AVV mit STACKIT finalisieren, Datenschutz-Cockpit entsprechend Ihrer Security Baseline konfigurieren
BASE
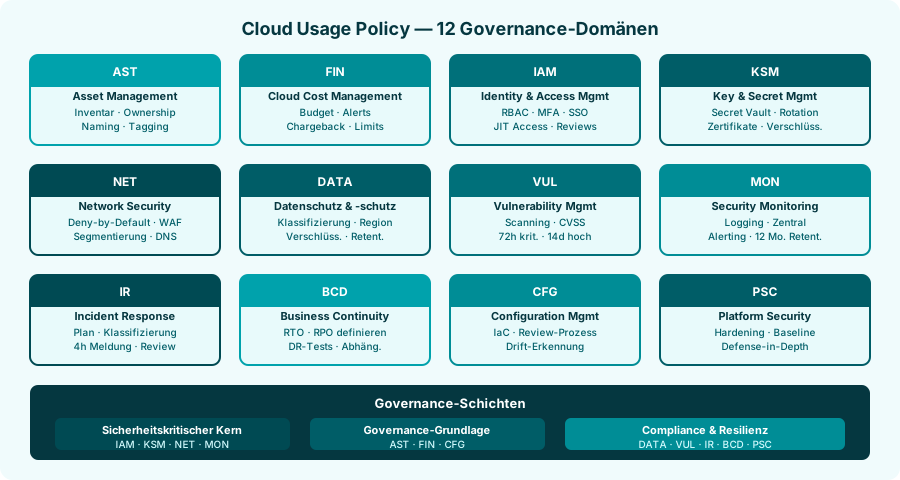
Cloud Usage Policy: 12 Governance-Domänen
Etablierung verbindlicher Nutzungsrichtlinien entlang der 12 Governance-Domänen (Fokus auf IAM, Key/Secrets- und Netzwerksicherheit).
Die Cloud Governance Policy definiert strategische Leitplanken und Grundsätze. Die Cloud Usage Policy übersetzt diese Richtlinien in verbindliche, operative Vorgaben — konkrete Regeln, die für jede Person und jedes Team gelten, die Cloud-Ressourcen bereitstellen, konfigurieren oder betreiben.
Eine Nutzungsrichtlinie ohne strukturierte Domänen ist schwer durchzusetzen: Sie wächst zu einem undurchsichtigen Regelwerk heran, das niemand vollständig kennt und das mit neuen Anforderungen uneinheitlich erweitert wird. Die Aufteilung in zwölf Domänen schafft Klarheit — jede Anforderung gehört zu einer klaren Domäne und Stakeholder wissen sofort, welche Domäne für ihr Thema zuständig ist.
Das Asset Management ist die Grundlage aller anderen Governance-Domänen. Wer nicht weiß, welche Cloud-Ressourcen existieren, kann diese weder absichern noch kosteneffizient betreiben noch compliance-konform halten. Eine vollständige Inventur aller Cloud-Ressourcen ist daher keine optionale Maßnahme, sondern die Voraussetzung für eine funktionierende Governance.
Kernpflichten: Jede Ressource wird in einem zentralen Inventar erfasst und aktuell gehalten; jeder Ressource ist ein verantwortliches Team oder eine verantwortliche Person zugeordnet; alle Ressourcen folgen definierten Namenskonventionen; eine vollständige Kennzeichnung nach Standard ist verpflichtend. Ressourcen ohne definierten Eigentümer und ohne vollständige Tags sind per Definition nicht konform und müssen sofort behoben oder entfernt werden.
Unkontrollierter Cloud-Konsum führt zu erheblichen und unerwarteten Kosten. Eine transparente Kostenzuordnung und aktives Management sind daher zwingende Anforderungen an alle Cloud-Nutzenden — nicht nur an das FinOps-Team.
Jede Ressource muss mit obligatorischen Kostenzuordnungs-Tags gekennzeichnet sein, Budgetalarme müssen konfiguriert werden, maximale Ausgabengrenzen werden technisch durchgesetzt und ungenutzte oder verwaiste Ressourcen müssen regelmäßig identifiziert und entfernt werden. Ressourcen mit erheblichen Kostenauswirkungen — GPU-Instanzen, große Datenbankcluster — müssen vor der Bereitstellung explizit genehmigt werden.
Das Chargeback- und Showback-Prinzip stellt sicher, dass Cloud-Kosten transparent auf die verursachenden Teams verteilt werden. Kostenverantwortung ohne Kostentransparenz ist ineffektiv.
Identitäten und Zugriffsberechtigungen sind der primäre Angriffsvektor in Cloud-Umgebungen. Die IAM-Domäne definiert verbindliche Vorgaben zur Verwaltung von Benutzer-, Service- und Systemidentitäten sowie zur Governance von Zugriffsrechten.
Alle Zugriffsrechte werden ausschließlich über Rollen oder Gruppen vergeben — niemals direkt an einzelne Personen. Jede Person hat eine individuelle, identifizierbare Nutzeridentität; gemeinsame Konten sind untersagt. Die Multifaktor-Authentifizierung ist für alle Cloud-Ressourcen verpflichtend, ausnahmslos für privilegierte Konten. Der Zugriff erfolgt ausschließlich über den zentralen Identity Provider — lokale Cloud-Accounts außerhalb des IdP sind nicht zulässig. Der privilegierte Zugriff wird zeitlich begrenzt und just-in-time gewährt und regelmäßig überprüft.
Kryptografische Schlüssel, Secrets und Zertifikate sind kritische Sicherheitsassets, deren unsachgemäße Verwaltung schwerwiegende Sicherheitsvorfälle verursachen kann. Secrets werden ausschließlich in einem dedizierten, von der Plattform bereitgestellten Secret-Management-Service gespeichert — nicht in Quellcode, Konfigurationsdateien oder Versionskontrollsystemen.
Vom System verwaltete Identitäten sind statischen Anmeldeinformationen vorzuziehen. Secrets und kryptografische Schlüssel rotieren in definierten Intervallen automatisch. Zertifikate werden zentral mit kontinuierlich überwachten Ablaufdaten verwaltet. Jeder Zugriff auf Secrets und Schlüssel ist lückenlos zu protokollieren.
Die Netzwerkarchitektur bildet die Grundlage für eine sichere und kontrollierte Kommunikation zwischen Cloud-Ressourcen und externen Systemen. Das Grundprinzip ist Deny-by-Default: Jeglicher Netzwerkverkehr wird standardmäßig verweigert. Eine Kommunikation ist nur über explizit definierte Regeln zulässig.
Cloud-Ressourcen werden in logisch unterschiedliche Netzwerksegmente unterteilt. Der Zugriff von außen erfolgt nur über definierte und kontrollierte Zugangspunkte. Öffentlich zugängliche Webservices und APIs müssen durch eine Web Application Firewall geschützt werden. Der Netzwerkverkehr wird kontinuierlich auf Auffälligkeiten überwacht.
Alle in der Cloud verarbeiteten Daten müssen klassifiziert werden — die Klassifizierung ist die Grundlage für alle nachgelagerten Schutzmaßnahmen. Daten dürfen nur in freigegebenen Cloud-Regionen gespeichert und verarbeitet werden.
Alle gespeicherten Daten müssen verschlüsselt werden — Datenbanken, Speicherkonten und Backups ausnahmslos. In Nicht-Produktionsumgebungen dürfen keine Produktionsdaten verwendet werden, sondern es sind synthetische oder anonymisierte Datensätze zu verwenden. Sensible Daten sind in Protokollen, Ausgaben und Schnittstellen zu maskieren. Cloud-Workloads, die personenbezogene Daten verarbeiten, müssen im Verarbeitungsverzeichnis erfasst werden.
Schwachstellen in Cloud-Ressourcen, Abhängigkeiten und Konfigurationen stellen ein kontinuierliches Sicherheitsrisiko dar. Alle Cloud-Ressourcen werden regelmäßig und automatisch auf Schwachstellen gescannt. Identifizierte Schwachstellen werden nach CVSS klassifiziert und priorisiert.
Verbindliche Behebungsfristen nach Schweregrad: Kritische Schwachstellen (CVSS 9,0–10,0) müssen innerhalb von 72 Stunden behoben werden. Hohe Schwachstellen (CVSS 7,0–8,9) innerhalb von 14 Tagen. Mittlere Schwachstellen (CVSS 4,0–6,9) innerhalb von 30 Tagen. Geringe Schwachstellen im nächsten regulären Patchzyklus. Container und VM-Images mit kritischen oder hohen Schwachstellen dürfen nicht in Produktivumgebungen bereitgestellt werden.
Eine kontinuierliche Überwachung aller Cloud-Ressourcen ist unerlässlich, um Sicherheitsvorfälle, Fehlkonfigurationen und anomales Verhalten frühzeitig zu erkennen. Alle Cloud-Ressourcen und Workloads müssen protokolliert werden — die Deaktivierung der Protokollierungsfunktionen ist nicht zulässig.
Protokolle werden zentral gesammelt und aufbewahrt — eine dezentrale oder isolierte Protokollspeicherung ist nicht zulässig. Protokolle sind manipulationssicher aufzubewahren. Sicherheitsrelevante Protokolle sind mindestens 12 Monate vorzuhalten. Für sicherheitsrelevante Ereignisse müssen automatisierte Alarme konfiguriert werden.
Ein dokumentierter Incident-Response-Plan für Cloud-Umgebungen ist obligatorisch. Sicherheitsvorfälle müssen klassifiziert, priorisiert und nach definierten Verfahren behandelt werden. Kritische Sicherheitsvorfälle erfordern eine Meldung an das Cloud-Team innerhalb von 4 Stunden.
Alle Vorfälle werden lückenlos dokumentiert — mit Ursachen, Auswirkungen und ergriffenen Maßnahmen. Nach jedem signifikanten Incident ist ein strukturiertes Post-Incident-Review mit dokumentierten Lessons Learned durchzuführen. Die forensische Untersuchbarkeit von Vorfällen ist durch eine ausreichende Protokollierung und Vorfalldokumentation sicherzustellen.
Domäne 10: Business Continuity & Disaster Recovery (BCD)
Für kritische Anwendungen sind Recovery Time Objectives (RTO) und Recovery Point Objectives (RPO) zu definieren. Diese Werte sind die Grundlage für die Backup-Strategie und die Disaster-Recovery-Architektur — ohne sie kann kein angemessenes Recovery-Design erstellt werden.
Backup-Konzepte müssen den definierten RPO-Anforderungen entsprechen. Disaster-Recovery-Pläne müssen regelmäßig getestet werden — ungetestete Pläne sind keine Sicherheitsgarantie. Abhängigkeiten zwischen Systemen müssen erkannt und bei der Wiederherstellungsplanung berücksichtigt werden.
Jede Cloud-Infrastruktur muss als Code definiert und versioniert werden. Manuelle Konfigurationsänderungen an Produktionsressourcen sind nicht zulässig — alle Änderungen erfolgen über den definierten IaC-Prozess. Konfigurationsänderungen durchlaufen einen formalen Prüf- und Genehmigungsprozess.
Konfigurationsabweichungen (Drift) zwischen Soll- und Ist-Zustand müssen automatisch erkannt werden. Alle Konfigurationsänderungen werden versioniert und sind nachvollziehbar.
Alle Cloud-Ressourcen müssen gemäß definierter Security Baselines gehärtet werden. Die von der Plattform bereitgestellten Sicherheitsdienste — Endpoint Protection, Vulnerability Scanning, Log Collection — müssen auf allen Ressourcen aktiviert werden. Nicht konforme Ressourcen müssen identifiziert, behoben oder entfernt werden.
Es gilt das Defense-in-Depth-Prinzip: mehrere unabhängige Sicherheitsschichten statt einer einzelnen Maßnahme. Sicherheitsbewertungen für Cloud-Umgebungen werden regelmäßig und bei signifikanten Architekturänderungen durchgeführt.
Die zwölf Domänen sind hinsichtlich ihres Gefährdungspotenzials nicht gleich. IAM, KSM und NET bilden den sicherheitskritischen Kern — Verstöße in diesen Domänen können unmittelbar zu Security Incidents mit erheblichem Schadenspotenzial führen. AST und FIN bilden das Governance-Fundament — ohne vollständige Bestands- und Kostentransparenz kann keine der anderen Domänen wirksam durchgesetzt werden.
Der CCoE ist für die Aufrechterhaltung, Kommunikation und Durchsetzung der Nutzungsrichtlinie verantwortlich. Durch eine regelmäßige Überprüfung — mindestens jährlich — wird sichergestellt, dass die Richtlinie aktuell ist und neue Cloud-Services und Risiken berücksichtigt.
STEP
Die drei Säulen der Cloud Governance
Technische Umsetzung von Sicherheits-, Finanz- und Betriebsleitplanken (Hard-Mandatory Guardrails wie z. B. exklusive Datenhaltung in Deutschland).
Cloud Governance ruht auf drei gleichermaßen wichtigen Säulen. Eine Schwäche in einer Säule destabilisiert den gesamten Rahmen.
Die drei Säulen bilden ein gleichseitiges Dreieck: Security Governance steht an der Spitze, Financial Governance und Operational Governance bilden die Basis. Die Schwäche einer Säule destabilisiert den gesamten Rahmen — eine Organisation, die nur Security Governance betreibt, verliert Kostenkontrolle und operative Stabilität; eine, die sich nur auf die Operational Governance konzentriert, öffnet Sicherheitslücken und Budgetrisiken.
Zweck: Sicherstellen, dass Cloud-Ressourcen keine Sicherheitsschwachstellen darstellen, regulatorische Anforderungen erfüllt werden und Compliance nachweisbar ist.
Cloud Governance funktioniert nur, wenn klar ist, wer welche Verantwortung trägt. Es ist ein häufiger Fehler, die Verantwortung nur zwischen „Cloud-Anbieter“ und „uns“ aufzuteilen. In der Praxis bedarf es einer genaueren Unterscheidung über drei Ebenen hinweg — denn innerhalb der Organisation sind nicht alle Parteien gleichermaßen verantwortlich.
Cloud Service Provider (CSP)
Der Anbieter liefert das technische Fundament: Rechenzentren, Hardware, Netzwerkinfrastruktur,
Virtualisierung und Zugriff auf Cloud-Services über APIs und Portale. Die Verantwortung des
Anbieters endet dort, wo die Organisation die bereitgestellten Leistungen konsumiert.
Cloud-Team (CCoE + Platform Team)
Das interne Cloud-Team ist verantwortlich für Governance, Standards, Sicherheitsanforderungen
und die technische Plattform. Es schützt nicht einzelne Anwendungen, sondern setzt den Rahmen,
innerhalb dessen Anwendungsteams sicher arbeiten können. Ohne diesen Rahmen entsteht
unkontrolliertes Wachstum.
Anwendungsteams
Die Teams, die Applikationen erstellen und betreiben, sind für die korrekte Nutzung der
bereitgestellten Plattform verantwortlich. Sie entscheiden über Deployments, Konfigurationen und
den Betrieb ihrer Workloads — innerhalb der vom Cloud-Team festgelegten Grenzen.
Die kritische Erkenntnis: „Der Provider ist sicher“ bedeutet nicht, dass Ihre Ressourcen beim Provider sicher konfiguriert sind. Eine falsch konfigurierte IAM-Richtlinie, ein öffentlich zugänglicher Storage Bucket, ein Container ohne Sicherheitskontext — das liegt in der Verantwortung des Anwendungsteams, nicht des Anbieters. Das Cloud-Team legt die Leitplanken fest, die solche Fehler erkennen oder verhindern.
CCoE vs. Platform Team: zwei unterschiedliche Funktionen
Innerhalb des Cloud-Teams gibt es eine weitere wichtige Unterscheidung, die in der Praxis häufig verwischt und zu Reibungen führt.
Das Cloud Center of Excellence (CCoE) verantwortet Governance und Standards — es definiert, was gilt: Richtlinien, Sicherheitsanforderungen, Compliance-Kontrollen, Kostenmanagement, Servicekatalog. Es beantwortet die Frage: „Wie muss und darf die Cloud aussehen?“ Der CCoE berät Anwendungsteams, setzt Leitplanken und kontrolliert deren Einhaltung.
Das Cloud Platform Team ist verantwortlich für die technische Implementierung und den Betrieb — es setzt das Wie um: Landing Zone, Netzwerkinfrastruktur, Automatisierung, Self-Service-Plattformen, Monitoring der Plattformkomponenten. Es beantwortet die Frage: „Wie ist das, was der CCoE definiert hat, technisch realisiert?“
Diese Trennung verhindert, dass Governance-Entscheidungen stillschweigend durch technische Umsetzungsentscheidungen ersetzt werden — und umgekehrt Governance zum Papiertiger wird, weil niemand sie umsetzt.
Ausnahmemanagement: Wenn Leitplanken zu restriktiv sind
Leitplanken sind nicht für jede Situation perfekt. Es wird berechtigte Fälle geben, in denen ein Team von einem Standard abweichen muss. Das Ausnahmemanagement ist hierfür der strukturierte Prozess.
Der Ausnahmeprozess folgt fünf Schritten: Das Team beantragt die Ausnahme mit Begründung und geplanter Dauer (Request). Der CCoE prüft innerhalb von 2 Werktagen — ist die Abweichung akzeptabel oder muss eine Alternative gefunden werden? (Review). Bei einer positiven Entscheidung füllt das Team ein Ausnahmeformular aus: Beschreibung des Standards, Begründung für die Abweichung, Risikobewertung, Mitigationsmaßnahmen, Dauer und Prüfdatum — unterschrieben vom CCoE Lead, bei Sicherheitsausnahmen zusätzlich vom CISO (Approval). Die Ausnahme wird im Ausnahmeprotokoll dokumentiert, eine Kalendererinnerung wird gesetzt und sie wird monatlich im Governance-Bericht aufgeführt (Monitoring). Zum Prüftermin entscheidet der CCoE: die Ausnahme schließen und den Standard umsetzen oder eine Verlängerung beantragen — mit Eskalation durch den CCoE, damit Ausnahmen nicht stillschweigend dauerhaft werden (Review / Verlängerung).
Das Ausnahmeprotokoll: Transparenz über Abweichungen
Die Adoption-Phase darf erst starten, wenn alle fünf Dimensionen das Level „Ready“ erreicht haben. Eine Dimension auf „Nicht bereit“ ist ein Go-/No-Go-Kriterium — kein optionaler Punkt.
Readiness-Scorecard ausfüllen: 4 Wochen vor dem geplanten Freigabetermin
Rote Punkte eskalieren: Wer kann entsperren? Was ist der schnellste Lösungsweg?
Gelbe Punkte verfolgen: Täglicher Status bis zum Freigabedatum
Go-/No-Go-Entscheidung auf Basis der Scorecard
Externer Link
Sie verlassen die Route
Dieser Link führt zu einer externen Seite außerhalb von STACKIT. Fremde Inhalte und Downloads prüfen wir nicht, folgen Sie dem Pfad nur, wenn Sie der Quelle vertrauen.