Cloud-Zielbild & Strategie
Nordstern definieren, Souveränitätsstrategie festlegen, Anbieterauswahl treffen, Beschaffung rechtskonform strukturieren. Das strategische Fundament, ohne das alle weiteren Schritte auf Sand gebaut sind.
Zuletzt aktualisiert am


Cloud-Transformationen brauchen strategische Führung und finanzielle Kontrolle: von der Cloud-Vision über das Rollenmodell bis zur Transformations-Freigabe.
Strategischer Leitfaden für C-Level-Sponsoren zur sequenziellen Abfolge aller Kernentscheidungen in der Advisory-Phase.
Dieses Rahmenwerk ist für Sie geschrieben, wenn Sie als CIO, CDO, COO oder Vorstand die Verantwortung für eine Cloud-Transformation tragen oder tragen werden. Es ist kein technisches Handbuch. Es ist ein Führungsinstrument.
Die einzige Frage, die jeder erfolgreichen Cloud-Transformation vorausgeht: Warum jetzt und zu welchem Zweck genau? Organisationen, die diese Frage nicht beantworten können, scheitern nicht an der Technologie. Sie scheitern daran, dass niemand weiß, wofür es sich lohnt, die Anforderungen der Veränderung auszuhalten.
Die Transformation verläuft in zwei Phasen. Advisory geht vor Adoption — denn operative Exzellenz ohne strategische Klarheit ist Energieverschwendung.
Phase 1 — Advisory (Monate 1–6): Sie entscheiden über die strategische Ausrichtung. Welche Souveränitätsstufe ist für Ihre Organisation zwingend erforderlich? Wer leitet das Cloud Center of Excellence? Welches Budget steht zur Verfügung? Welche Workloads kommen zuerst? Diese Entscheidungen sind nicht delegierbar — sie prägen alles, was folgt.
Phase 2 — Adoption (Monate 4–18): Ihr Team führt aus. Sie steuern. Der wichtigste Beitrag, den Sie in dieser Phase leisten: sichtbar dahinterstehen. Die Transformation scheitert meist nicht an technischen Problemen, sondern daran, dass das C-Level nach dem Kick-off verschwindet. Mehr dazu im Kapitel Vorstand als Sponsor.
Cloud-Zielbild & Strategie
Nordstern definieren, Souveränitätsstrategie festlegen, Anbieterauswahl treffen, Beschaffung rechtskonform strukturieren. Das strategische Fundament, ohne das alle weiteren Schritte auf Sand gebaut sind.
Business Case & Finanzplanung
TCO-Analyse, ROI-Berechnung, CFO-Szenarien, Investitionsplanung. Die komprimierte Business-Case-Erzählung für Ihr nächstes Vorstandsgespräch.
Cloud Center of Excellence
Wer baut die Transformation auf? Wie ist der CCoE aufgebaut? Welche Rollen werden benötigt? Wie vermeidet es der CCoE, zu einer neuen Bürokratie zu werden? Die organisatorische Schaltzentrale.
Kulturwandel
Widerstand ist rational. Bauen Sie ein Champions-Netzwerk auf. Binden Sie Betriebsräte ein. Und: was der Vorstand selbst tun muss — nicht nur ermöglichen, sondern vorleben.
Governance
Drei-Säulen-Governance, Policy-as-Code, Compliance-Matrix für DSGVO, TISAX, BAIT, DORA. Governance, die skaliert, ohne zu bürokratisieren.
Adoption & Betrieb
Landing Zone, IAM, Betriebsmodell, DevOps, Disaster Recovery. Die operative Umsetzung — für Ihr IT-Team, nicht für Sie persönlich. Aber Sie sollten wissen, was möglich ist.
Heute bezahlen Sie für Infrastruktur, die Sie nicht vollständig nutzen, für Compliance-Risiken, die Sie nicht vollständig kennen, und für Geschwindigkeit, deren Mangel Sie sich nicht leisten können. Die Cloud-Transformation auf STACKIT adressiert alle drei gleichzeitig — mit dem entscheidenden Unterschied zu US-Hyperscalern: Ihre Daten bleiben in Deutschland, unterliegen deutschem Recht und sind immun gegen den Zugriff der US-Regierung.
Der Business Case funktioniert zweidimensional. Die direkte Dimension — TCO-Reduktion, Vermeidung von Hardware-Refresh, Lizenzkosten — ist konservativ kalkulierbar und liefert über drei Jahre typischerweise einen ROI von 150–200 %. Die strategische Dimension — Compliance-Sicherheit, Geschwindigkeit, Innovationsfähigkeit — ist schwerer zu quantifizieren, aber real: jede Stunde weniger Systemausfall, jedes regulatorische Risiko, das nie eintritt, jedes Feature, das vier Wochen früher live geht.
Die vollständige Berechnung befindet sich bei ROI & Payback und Business Case Narrative.
Der erste Schritt ist nicht die Technik. Der erste Schritt ist die Beantwortung der Frage: Warum transformieren wir und was soll in drei Jahren anders sein? Formulieren Sie diese Antwort in einem Satz. Wenn das schwierig ist, ist es kein Fehlschlag — es ist der wichtigste Indikator dafür, wo die Arbeit beginnen muss.
Beginnen Sie mit dem Kapitel Nordstern & Cloud-Ziele. Dort wird diese Frage methodisch bearbeitet.
Dieses Framework basiert auf den Erfahrungen aus deutschen Enterprise-Cloud-Transformationen. Es ist kein Universalrezept, sondern ein strukturiertes Denkgerüst, das dabei hilft, die richtigen Fragen in der richtigen Reihenfolge zu stellen.
Definition einer langfristigen Cloud-Vision (North Star) und Operationalisierung durch messbare strategische KPIs (Agilität, Finanzen, Compliance).
Bevor ein Nordstern formuliert werden kann, muss es ehrliche Klarheit über die Faktoren geben, die Veränderungen erzwingen oder auslösen. Diese Treiber sind oft nicht steuerbar — sie kommen von außen oder ergeben sich aus internen Entwicklungen, die man nicht mehr ignorieren kann.
Typische externe Treiber sind auslaufende Rechenzentrumsverträge, End-of-Life von Systemen ohne Herstellerunterstützung, steigende regulatorische Anforderungen (DSGVO, NIS2, DORA), geopolitische Entwicklungen mit Souveränitätsfragen und Wettbewerbsdruck durch den technologischen Wandel. Interne Treiber resultieren häufig aus einem wachsenden Kapazitätsbedarf, steigenden Infrastrukturkosten, der operativen Belastung durch Legacy-IT oder der mangelnden Fähigkeit, schnell auf neue Geschäftsanforderungen zu reagieren.
Warum ist diese Analyse wichtig? Weil der dominante Treiber bestimmt, welcher Nordstern glaubwürdig ist. Eine Organisation, die primär durch Compliance-Druck getrieben wird, hat eine andere Dringlichkeit als eine Organisation, die von Innovationszielen getrieben wird. Die Treiberanalyse schützt davor, eine Cloud-Strategie zu formulieren, die den tatsächlichen Problemdruck verfehlt.
Aus den identifizierten Treibern werden strategische Ziele abgeleitet. Diese Ziele sind das Bindeglied zwischen Handlungsdruck und Nordstern: Sie beschreiben, was die Organisation mit der Cloud konkret erreichen will.
Typische strategische Ziele sind die Verbesserung der IT-Kostenstruktur, die Steigerung der Innovationsfähigkeit, die Verkürzung der Time-to-Market, die Ermöglichung neuer digitaler Geschäftsmodelle, die Verbesserung der globalen Verfügbarkeit von IT-Services, die Reduktion der Komplexität der IT-Landschaft und der Aufbau von Experimentierfähigkeit. Diese Ziele sind nicht abstrakt — sie müssen konkret genug sein, um in messbare KPIs übersetzt zu werden.
Cloud-Prinzipien sind grundlegende Leitregeln, nach denen Architektur-, Technologie- und Implementierungsentscheidungen getroffen werden. Sie schaffen Konsistenz: Steht ein Team vor einer Entscheidung, geben die Grundsätze klare Orientierung, ohne dass jede Situation einzeln eskaliert werden muss.
| Grundsatz | Bedeutung |
|---|---|
| Cloud First | Neue Anwendungen werden als Cloud-Lösungen realisiert, sofern keine zwingenden Gründe dagegen sprechen. |
| Managed Services bevorzugen | Managed Services reduzieren den operativen Aufwand und verbessern die Skalierbarkeit — sie werden standardmäßig selbst betriebenen Alternativen vorgezogen. |
| Standardisierung vor Individualisierung | Cloud Services werden möglichst standardisiert genutzt, um die Komplexität zu reduzieren und die Wiederverwendbarkeit zu erhöhen. |
| Automation First | Infrastruktur- und Plattformkomponenten werden durch Automatisierung bereitgestellt und betrieben — nicht durch manuelle Klicks. |
| Infrastructure as Code | Infrastruktur wird deklarativ als Code definiert, versioniert und automatisch bereitgestellt. |
| Security & Compliance by Design | Sicherheits- und Compliance-Anforderungen werden von vornherein in Architektur und Implementierung integriert und nicht rückwirkend ergänzt. |
Diese Grundsätze sind keine Empfehlungen, sondern verbindliche Leitplanken, anhand derer der CCoE Architekturentscheidungen bewertet und bei Abweichungen eine Begründung einfordert.
Das Cloud-Zielbild beschreibt den Soll-Zustand der zukünftigen IT-Landschaft. Es leitet sich aus der Geschäfts- und IT-Strategie ab und definiert die Rolle von Cloud-Technologien bei der Entwicklung der IT-Fähigkeiten der Organisation.
Die Cloud wird als zentrale Plattform für die Entwicklung und den Betrieb der digitalen Anwendungen und Dienste der Organisation dienen. Anwendungen werden primär auf automatisierten und skalierbaren Cloud-Plattformen über Managed Services und standardisierte Plattform-Services betrieben. Der Einsatz offener Technologien, standardisierter Plattformen und Automatisierung ermöglicht einen reduzierten operativen Aufwand und mehr Flexibilität. So entsteht eine sichere, skalierbare und zukunftsfähige IT-Landschaft, die digitale Geschäftsmodelle und Innovationen unterstützt.
Dieses Zielbild ist mehr als eine technologische Beschreibung — es ist eine strategische Positionierung. Es beantwortet die Frage, warum die Cloud gewählt wird, und stellt die Verbindung zwischen IT-Entscheidungen und Geschäftszielen her. Führungskräfte auf allen Ebenen müssen diesen Zielzustand verstehen und ihn aktiv vertreten, damit die Transformation gelingt.
Ein Cloud-Zielbild hat drei wesentliche Funktionen: Es richtet die Organisation auf einen gemeinsamen Zielzustand aus, schafft Legitimität für Investitions- und Priorisierungsentscheidungen und dient als Benchmark, an dem Fortschritte regelmäßig gemessen werden können.
Der Nordstern ist eine einzelne, präzise Aussage, die die Frage beantwortet: Warum machen wir das? Es ist keine Technologiebeschreibung — es ist eine geschäftsstrategische Aussage.
Schwache Nordsterne (technologiefokussiert):
Starke Nordsterne (geschäftsfokussiert):
Der Unterschied: Ein starker Nordstern ist für den Finanzvorstand ohne fachliche Erklärung verständlich.
Das Strategierahmenwerk hat vier Ebenen. Ebene 1 — Warum (Nordstern): Welchem Geschäftszweck dient die Cloud-Transformation? Diese Antwort muss in einem Satz ausdrückbar sein. Ebene 2 — Was (strategische Ziele): 3–5 messbare Ziele, die den Nordstern operationalisieren und in KPIs übersetzt werden können. Ebene 3 — Wie (strategische Entscheidungen): Souveränitätsstrategie, Anbieterauswahl, Betriebsmodell — die grundlegenden Entscheidungen, die alle nachgelagerten Entscheidungen beeinflussen. Ebene 4 — Wer und Wann (Roadmap): Priorisierung der Workloads, Phasenplanung, Ressourcenplan — die Operationalisierung des Wie.
Jede Cloud-Strategie dient einer Kombination aus vier Zielkategorien:
| Kategorie | Beispielziele | Primäre Stakeholder |
|---|---|---|
| Agilität | Time-to-Market-Reduktion, kürzere Deployment-Zyklen | GLV, CDO |
| Kosteneffizienz | TCO-Reduktion, CAPEX→OPEX-Shift, FinOps-Reifegrad | CFO |
| Souveränität & Compliance | DSGVO-Konformität, Cloud-Act-Immunität, TISAX-Zertifizierung | CISO, DSB, Recht |
| Belastbarkeit & Stabilität | SLA-Verbesserung, Disaster-Recovery-Fähigkeit, Verfügbarkeit | CTO, IT Operations |
Wichtig: Jede Organisation hat eine dominante Zielkategorie — diese bestimmt, welche Cloud-Entscheidungen priorisiert werden. Eine primär nach Souveränität strebende Organisation trifft andere Anbieterentscheidungen als eine primär nach Agilität strebende Organisation.
Ohne Messung ist die Cloud-Transformation ein Glaubensakt. Das Kennzahlengerüst macht sie zu einer rechenschaftspflichtigen Investition.
| KPI | Ausgangsmessung | 24-Monatsziel |
|---|---|---|
| Time-to-Market für neue digitale Features | Heute messen | 50 % Reduktion |
| IT-Betriebskosten in % vom Umsatz | Heute messen | 15 % Reduktion |
| Anteil Workloads auf Sovereign Cloud | 0 % | Organisationsspezifisches Ziel |
| Compliance-Vorfälle (Datenschutz, Revisionsfeststellungen) | Heute messen | Trend: rückläufig |
| KPI | Ausgangsmessung | 24-Monatsziel |
|---|---|---|
| Deployment-Häufigkeit (Deployments/Woche) | Heute messen | 5-fache Verbesserung |
| Vorlaufzeit für Änderungen | Heute messen | 70 % Reduktion |
| Cloud-Kosteneffizienz (Spend vs. Budget) | Baseline nach Monat 3 | ±5 % Budgetgenauigkeit |
| Mitarbeitende mit Cloud-Zertifizierung | Heute messen | Mind. 1 von 5 technischen Mitarbeitenden |
| KPI | Ausgangsmessung | Ziel |
|---|---|---|
| Mean Time to Recovery (MTTR) | Heute messen | 50 % Reduktion |
| Leitplanken-Einhaltungsquote | N/A (Baseline) | >99 % |
| Einhaltung von Ressourcen-Tagging | 0 % | 100 % neue Ressourcen |
| Ungenutzte Ressourcen (Abfall) | 0 % (Baseline) | <5 % des Cloud-Budgets |
Ein starkes Cloud-Vision-Statement beantwortet in 3–4 Sätzen drei Fragen: Was wollen wir werden (Soll-Zustand), warum es wichtig für unser Geschäft ist und was unseren Ansatz auszeichnet (z. B. Souveränität).
„[Organisation] wird bis zum [Datum] zu einer Cloud-nativen Organisation, die [Geschäftsziel erreicht]. Wir werden primär souveräne Cloud-Infrastruktur [Anbieter/Ansatz] nutzen, weil [strategischer Grund — z. B. regulatorische Vorgaben, Wettbewerbsdifferenzierung, Datenschutz]. Wir messen unseren Erfolg an [2–3 Top-KPIs].“
Eine Cloud-Strategie ohne Entscheidungsgremium ist ein Dokument ohne Auftrag. Das Cloud Strategy Board ist das Governance-Gremium, das die Cloud-Strategie verabschiedet und regelmäßig überprüft, als Eskalationspfad für Architekturentscheidungen mit strategischer Relevanz dient, Investitionsentscheidungen über den CCoE-Auftrag hinaus trifft und den Transformationsfortschritt quartalsweise anhand von KPIs bewertet.
Details zum Strategy Board sind im Cloud Strategy Board zu finden.
Etablierung des Lenkungskreises und Nutzung des "CIO Canvas" (1-Seiten-Statusbericht) für effiziente, vorstandsgerechte Abstimmungen.
Eine Cloud-Strategie in einem Dokument ist notwendig, aber nicht ausreichend. Ohne ein Gremium mit Mandat und Entscheidungshoheit wird die Strategie nicht gelebt — sie wird archiviert.
Das Cloud Strategy Board ist das Führungsgremium, das die Cloud-Strategie verabschiedet und regelmäßig überprüft, als Eskalationspfad für Architekturentscheidungen mit strategischer Relevanz dient, Investitionsentscheidungen über das CCoE-Mandat hinaus trifft und den Übergang von Advisory zu Adoption formal freigibt.
| Rolle | Person | Verantwortung |
|---|---|---|
| Vorsitz | CIO | Strategische Ausrichtung, Entscheidungsauftrag |
| Mitglied | CTO | Technische Architekturentscheidungen |
| Mitglied | CFO (oder Delegierter) | Investment Governance, Budgetfreigaben |
| Mitglied | CISO | Security- und Compliance-Sicht |
| Beratend | CDO (falls vorhanden) | Datenstrategie, Perspektive Datenhoheit |
| Beratend | CCoE Lead | Operativer Stand, technische Empfehlungen |
| Beratend | Datenschutzbeauftragter | DSGVO-Compliance, Souveränitätsmatrix |
Wichtig: Das Strategy Board ist ein Führungs- und kein Fachgremium. Technische Details werden im CCoE erarbeitet und dem Gremium zur Entscheidung vorgelegt.
| Entscheidungstyp | Beispiel | Entscheidungsebene |
|---|---|---|
| Strategieverabschiedung | Nordstern, KPI-Rahmenwerk, Souveränitätsstrategie | Gremium (Pflicht) |
| Anbieterentscheidung | STACKIT als Hauptanbieter | Gremium (Pflicht) |
| Budget über Schwellenwert | Cloud-Jahresbudget, Großinvestitionen | Gremium + CFO-Freigabe |
| Meilensteine | Advisory→Adoption-Übergang, Freigabe von Wellen | Gremium (Pflicht) |
| Governance-Ausnahmen | Abweichung von Leitplanken-Richtlinien | Gremium oder an CCoE delegiert |
| Architekturstandards | Neue Plattformentscheidungen mit Breitenwirkung | CCoE empfiehlt, Gremium entscheidet |
Was das Gremium NICHT entscheidet:
| Besprechung | Frequenz | Dauer | Inhalt |
|---|---|---|---|
| Strategieüberprüfung | Quartalsweise | 90 Minuten | KPI-Review gegen Transformationsziele, strategische Anpassungen |
| Phasengate-Meeting | An Übergängen | 2–3 Stunden | Formale Readiness-Bewertung, Freigabe |
| Budgetüberprüfung | Halbjährlich | 60 Minuten | Cloud Spend vs. Budget, Forecast, Anpassungen |
| Eskalation | Nach Bedarf | 60 Minuten | Kritische Architektur- oder Compliance-Fragen |
Vorbereitung: Der CCoE Lead erstellt quartalsweise den Strategiebericht — ein 5-seitiges Executive Summary mit KPI-Scorecard, Top-3-Risiken und Top-3-Empfehlungen.
Der CIO Canvas ist ein One-Page-Visualisierungstool für Vorstandsgespräche zum Transformationsstatus. Es zeigt auf einen Blick, worauf es ankommt.
Der CIO Canvas ist in sechs Felder unterteilt. An der Spitze: Nordstern (kurzes Vision Statement), Top-KPIs (Time-to-Market und TCO-Reduktion: heute → Ziel) und Phasenstatus (Advisory / Adoption / Migration mit aktuellem Fortschritt). Unten: Workload-Status (Tier 1/2/3 — X von Y Workloads sind live), Risiken (die 3 wichtigsten aktuellen Risiken) und erforderliche Entscheidungen (wofür ein Gremienmandat erforderlich ist). Eine zusätzliche Zeile zeigt Budget Spend vs. Forecast, Team-Headcount und die nächsten drei Meilensteine mit Datum.
Dieses Format ist bewusst auf eine A4-Seite beschränkt — wer mehr braucht, hat keinen Canvas, sondern ein Statusdokument.
Der Canvas wird vor jedem Quartalsmeeting durch den CCoE Lead aktualisiert und bildet die primäre Grundlage für das Gremiengespräch.
Das Gremium generiert während der gesamten Transformation vier Klassen von verbindlichen Dokumenten. Erstens das Cloud-Strategiedokument — verabschiedet und unterzeichnet von allen Gremienmitgliedern, das Nordstern, KPIs, Souveränitätsstrategie und Anbieterentscheidung abdeckt. Zweitens die Investitionsgenehmigung — ein unterzeichnetes Budgetdokument für die Adoption-Phase, in dem die Cloud-Ausgaben genehmigt werden. Drittens Phase-Gate-Protokolle — Dokumentation der Bereitschaftsbewertung bei jedem Phasenübergang, die bestätigt, dass alle Akzeptanzkriterien erfüllt wurden. Viertens ein Ausnahmeprotokoll — alle genehmigten Abweichungen von den Governance-Standards mit Begründung, quartalsweise überprüft.
Gremium ohne Entscheidungsmandat: Ein Gremium, das nur informiert wird, aber keine Entscheidungen trifft, ist eine teure Sitzung. Das Gremium muss einen ausdrücklichen Auftrag haben — dokumentiert in einer Charta.
Zu häufige Meetings: Wöchentliche Gremiensitzungen erschöpfen die Aufmerksamkeit auf C-Level. Quartalsweise ist der richtige Rhythmus.
Kein CFO im Gremium: Cloud-Investitionen brauchen CFO-Buy-in. Ein Gremium ohne Finanzperspektive produziert Strategien, die später an der Budgetstufe scheitern.
Zuweisung klarer Verantwortlichkeiten (RACI-Matrix) für über 20 Transformationsaktivitäten unter den 8 Kernrollen der Führungsebene.
Eine Cloud-Transformation scheitert selten an der Technologie. Sie scheitert daran, dass unklar ist, wer was entscheidet, wer informiert werden muss und wer letztendlich die Verantwortung trägt. Das RACI-Modell beantwortet diese Frage für jede der zentralen Aktivitäten im Framework — bevor die Unklarheit zum Hindernis wird.
RACI steht für vier Arten von Verantwortung. Responsible bezeichnet die Person, die eine Aufgabe ausführt oder koordiniert. Accountable ist die Person, die letztendlich die Verantwortung dafür tragen muss — genau eine pro Tätigkeit. Consulted werden Personen, deren Input gesucht wird, bevor eine Entscheidung getroffen wird. Informed sind Personen, die über das Ergebnis informiert werden, ohne aktiv involviert zu sein.
Das Rollenmodell dieses Rahmenwerks ist bewusst funktional, nicht hierarchisch aufgebaut. Ein CIO kann gleichzeitig für die Gesamtstrategie verantwortlich (Accountable) sein und über technische Detailentscheidungen informiert werden. Die Rollen beschreiben Verantwortung, nicht Stellenprofile.
Der CIO ist der Sponsor und letztendliche Entscheidungsträger der Cloud-Transformation. Er verantwortet die strategische Ausrichtung, sichert das Budget und dient als Bindeglied zwischen IT-Transformation und Unternehmensführung. In der Advisory-Phase trifft der CIO die grundlegenden Entscheidungen: Welche Cloud-Strategie verfolgen wir? Mit welchem Anbieter? Auf welchem Zeithorizont? In der Adoption-Phase ist der CIO in erster Linie Eskalationsinstanz und Kommunikator nach oben und nach außen.
Der CIO ist die einzige Rolle, die für die gesamte Transformationsstrategie verantwortlich ist. Ohne einen aktiven, sichtbaren CIO als Sponsor scheitern Cloud-Transformationen nicht am Budget, sondern an der Energie der Organisation.
Der CTO verantwortet die technische Architektur und die Plattformstrategie. Er sorgt dafür, dass die fachlichen Entscheidungen der Transformation konsistent sind, den langfristigen Zielen der Organisation dienen und nicht im Technologie-Zoo enden. In Organisationen ohne eigene CTO-Rolle wird diese Funktion typischerweise von einem Leiter Architektur oder einem Enterprise Architect wahrgenommen.
Der CTO ist die Brücke zwischen strategischer Vision und technischer Realität. Er beantwortet die Frage: Ist das, was wir tun, auch das, was wir in fünf Jahren tun wollen?
Der CISO ist verantwortlich für die Sicherheitsanforderungen und deren Durchsetzung in der Cloud-Umgebung. Er definiert die Security Baseline, bewertet Risiken und sorgt dafür, dass Compliance-Anforderungen — DSGVO, BSI IT-Grundschutz, TISAX, BAIT — in technische Kontrollen übersetzt werden.
Der CISO ist oft der kritischste Stakeholder bei Cloud-Transformationen: Er kann eine Transformation verlangsamen, wenn seine Anforderungen nicht frühzeitig berücksichtigt werden, und er ist einer der wichtigsten Befähiger, wenn Sicherheit von Anfang an in die Architektur integriert und nicht nachträglich verankert wird.
Der Cloud Architect ist der technische Lead der Transformation auf Plattformebene. Er konzipiert die Landing Zone, definiert die Netzwerktopologie, stellt Leitplanken auf und ist erster Ansprechpartner für technische Architekturentscheidungen der Produktteams. Der Cloud Architect ist kein Engpass — er ist ein Enabler, der Patterns und Referenzarchitekturen bereitstellt, damit Produktteams eigenständig bauen können.
Der Platform Owner ist für den Betrieb der Cloud-Plattform als internes Produkt verantwortlich. Er stellt sicher, dass die Plattform verfügbar, aktuell und für die Produktteams nutzbar ist. Der Platform Owner arbeitet eng mit dem Cloud Architect zusammen und ist für den Betrieb verantwortlich, während der Architect für das Design verantwortlich ist.
Der FinOps Lead ist verantwortlich für Kostentransparenz, Cost Governance und die Einführung von FinOps-Praktiken in der Organisation. Er koordiniert zwischen Finance, IT und Business, betreibt das Tagging-Framework, führt Rightsizing-Reviews durch und kommuniziert Cloud-Kosten nachvollziehbar an alle Stakeholder.
Der FinOps Lead ist keine reine IT-Rolle. Die erfolgreichsten FinOps-Programme werden von Personen geleitet, die sowohl Controlling-Affinität als auch technisches Verständnis mitbringen.
Der IAM Lead ist verantwortlich für die Identitäts- und Zugriffsarchitektur der gesamten Cloud-Umgebung. Er definiert das RBAC-Konzept, führt den IDP ein, setzt MFA durch und stellt sicher, dass die Least-Privilege-Prinzipien operativ gelebt werden. Der IAM Lead arbeitet eng mit dem CISO zusammen, ist jedoch eine unabhängige operative Rolle.
Der CCoE Lead koordiniert das Cloud Center of Excellence und ist dafür verantwortlich, dass Wissen, Standards und Best Practices in der Organisation verteilt werden. Er organisiert Gilden, baut das Champions-Netzwerk auf, koordiniert Schulungsprogramme und ist die erste Anlaufstelle für Teams, die Unterstützung bei der Cloud-Einführung benötigen.
Der CCoE Lead ist eine der einflussreichsten Rollen in der Transformation — und eine der am häufigsten unterschätzten. Ein effektiver CCoE multipliziert die Wirkung aller anderen Rollen.
In der folgenden Matrix: R = Responsible (führt aus / koordiniert), A = Accountable (trägt die Letztverantwortung), C = Consulted (Mitarbeit gesucht), I = Informed (über Ergebnis informiert).
| Aktivität | CIO | CTO | CISO | Cloud Arch. | Platform Owner | FinOps Lead | IAM Lead | CCoE Lead |
|---|---|---|---|---|---|---|---|---|
| STRATEGIE & GOVERNANCE | ||||||||
| Cloud-Strategie verabschieden | A | C | C | C | — | C | — | I |
| Cloud-Anbieter auswählen | A | R | C | R | — | C | C | I |
| Governance-Charta verabschieden | A | C | R | C | — | — | C | C |
| Compliance-Register aufbauen | I | — | A | — | — | — | C | R |
| Security Baseline definieren | I | C | A | R | C | — | R | C |
| Cloud-Budget freigeben | A | C | — | — | — | R | — | I |
| ORGANISATION & ROLLEN | ||||||||
| CCoE gründen und beauftragen | A | C | C | — | — | — | — | R |
| RACI-Modell einführen | A | C | C | C | C | C | C | R |
| Schulungsprogramm aufsetzen | I | C | C | C | — | — | — | A/R |
| Champions-Netzwerk aufbauen | I | — | — | C | — | — | — | A/R |
| Betriebsmodell einführen (YBIYRI) | A | R | C | R | R | — | — | C |
| PLATTFORM & LANDING ZONE | ||||||||
| Landing Zone gestalten | I | A | C | R | C | — | C | — |
| Landing Zone in Betrieb nehmen | I | A | C | R | R | — | — | — |
| Leitplanken umsetzen | I | C | A | R | R | — | C | — |
| Netzwerktopologie freigeben | I | A | C | R | C | — | — | — |
| FINANZEN & KOSTEN | ||||||||
| Tagging-Standard definieren | I | C | — | C | C | A/R | — | C |
| Showback einführen | I | — | — | — | C | A/R | — | C |
| Chargeback einführen | C | — | — | — | C | A/R | — | C |
| Rightsizing-Prozess etablieren | I | — | — | — | C | A/R | — | — |
| IDENTITÄT & ZUGANG | ||||||||
| IDP-Federation einrichten | I | C | C | C | R | — | A/R | — |
| MFA für alle Benutzer erzwingen | I | — | A | — | R | — | R | — |
| RBAC-Matrix definieren | I | C | A | C | — | — | R | — |
| Zugriffsüberprüfungsprozess einführen | I | — | A | — | — | — | R | — |
| BESCHAFFUNG & RECHT | ||||||||
| AVV mit Anbieter abschließen | A | — | R | — | — | — | — | — |
| EVB-IT-Cloud-Vertrag prüfen | A | C | R | — | — | — | — | — |
Die RACI-Matrix ist ein Ausgangspunkt, kein unveränderliches Dokument. Jede Organisation hat eine andere Führungsstruktur, unterschiedliche Rollendefinitionen und unterschiedliche Entscheidungswege. Die Matrix soll zu Beginn der Advisory-Phase im Führungsteam besprochen, angepasst und anschließend formal verabschiedet werden.
Drei Muster, die häufig in der Anwendung auftreten und die Qualität der Matrix beeinträchtigen: Erstens zu viele A-Einträge für eine Person. Verantwortlichkeiten sind sparsam zu verteilen. Wenn eine Person für 15 von 25 Tätigkeiten verantwortlich ist, ist das kein Führungsleitbild, sondern eine Diagnose der Überlastung. Zweitens fehlende R-Einträge. Wenn niemand für eine Tätigkeit verantwortlich aufgeführt ist, wird diese entweder nicht durchgeführt oder spontan von der falschen Person übernommen. Drittens zu viele C-Einträge. Wenn bei jeder Aktivität alle Rollen hinzugezogen werden, verlangsamt das die Entscheidungsfindung ohne entsprechenden Qualitätsgewinn.
Definition eines verpflichtenden Metadaten-Schemas zur granularen Zuordnung aller Cloud-Ressourcen zu Kostenstellen und Umgebungen.
Tags sind Kennzeichnungen, die an Cloud-Ressourcen angebracht werden. Aber zu entscheiden, welche Tags obligatorisch sind, welche Werte gültig sind, wer für ihre Pflege verantwortlich ist und wie die Einhaltung durchgesetzt wird — das sind Governance-Entscheidungen. Und wie bei den meisten Governance-Entscheidungen ist die technische Umsetzung der leichte Teil.
Organisationen, die das Tagging als Konfigurationsaufgabe betrachten, enden mit Tag-Schemata, die nie konsequent angewendet wurden, Kostenberichten, denen niemand vertraut, und Compliance-Lücken, die bei jedem Audit Probleme verursachen. Organisationen, die es als Governance-Entscheidung angehen, kommen zu einem System, das tatsächlich funktioniert — weil die Personen, die es anwenden müssen, verstehen, warum es existiert, und die Regeln akzeptieren.
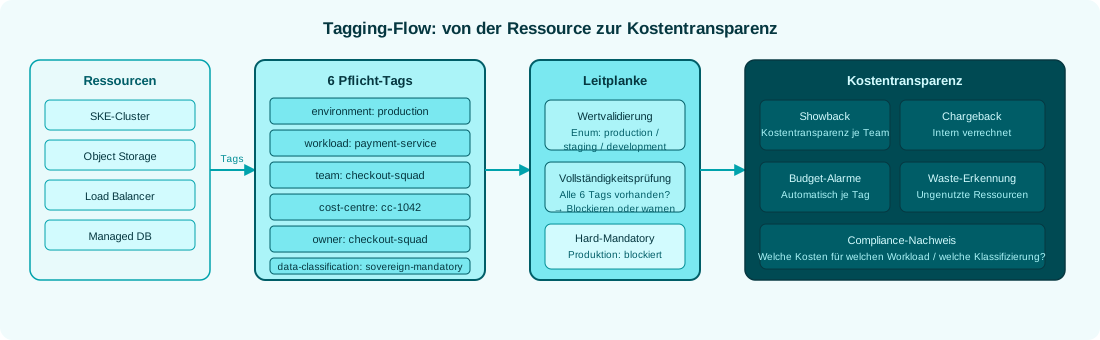
Ein Tagging-Framework ist mehr als eine Liste von Tag-Schlüsseln. Es deckt vier Dimensionen ab, die zusammen entscheiden, ob das System in der Praxis funktioniert.
Was wird getaggt? Nicht jede Ressource muss jedes Tag tragen. Das Framework definiert, welche Ressourcentypen welche Tags benötigen — wobei zwischen Kernressourcen (VMs, Storage, Datenbanken) und unterstützenden Ressourcen (Netzwerkkonfigurationen, Sicherheitsregeln) unterschieden wird. Diese Unterscheidung verhindert Tag-Ermüdung: Teams werden nicht gebeten, 20 Tags auf einer Firewall-Regel zu pflegen.
Welche Werte sind gültig? Freitextwerte in Tags sind der Anfang vom Ende. „dev“, „Dev“, „development“, „Development“ und „DEV“ bedeuten alle dasselbe — aus Sicht der Kostenberichterstattung und der Automatisierung handelt es sich jedoch um vier verschiedene Werte. Ein gutes Rahmenwerk definiert zulässige Werte, wo immer möglich, pro Tag und macht Abweichungen sichtbar.
Wer ist verantwortlich? Jedes Tag hat einen Eigentümer: jemanden, der entscheidet, was das Tag bedeutet, die Liste gültiger Werte verwaltet und Ausnahmen behandelt. Ohne klare Verantwortlichkeit bauen sich Tags lautlos ab — niemand bemerkt, wenn Werte inkonsistent werden, weil niemand zuschaut.
Wie wird Compliance durchgesetzt? Die Durchsetzung hat zwei Dimensionen: Was passiert, wenn eine nicht konforme Ressource erstellt wird, und wie eine bestehende Nicht-Konformität identifiziert und behoben wird. Beide benötigen eine definierte Antwort, bevor die erste Leitplanke aktiviert wird.
Ein Tag-Schema, das funktioniert, ist eines, das in Zusammenarbeit mit den Personen entworfen wurde, die es anwenden. Tags, die isoliert von einem zentralen Team entwickelt und dann an alle Teams mandatiert werden, neigen zum Scheitern: Entweder entsprechen sie nicht den realen Anforderungen, oder Teams verstehen ihren Zweck nicht und wenden sie inkonsistent an.
Beginnen Sie mit den Fragen, die Sie beantworten müssen
Das beste Tag-Schema leitet sich aus den Reporting- und Governance-Anforderungen ab, die es erfüllen muss. Welche Kostenverrechnungsberichte benötigen wir? Wer muss Compliance-Ownership nachweisen? Was muss durch die automatisierte Behebung erkannt werden? Diese Fragen bestimmen die Tags — nicht umgekehrt.
Beteiligen Sie die Teams, die Tags anbringen werden
Plattform-Team, FinOps, Security und mindestens zwei Anwendungsteams sollten im Raum sein. Teams, die beim Entwerfen des Schemas helfen, verstehen seinen Zweck und wenden ihn konsequent an. Teams, die von oben ein Mandat erhalten, wenden es ungern an — und uneinheitlich.
Definieren Sie realistische, nicht ideale gültige Werte
Gültige Werte sollten widerspiegeln, wie die Organisation tatsächlich funktioniert — nicht, wie sie idealerweise funktionieren sollte. Ein Kostenstellen-Tag, das einen Code benötigt, den drei Teams noch nicht haben, wird vom ersten Tag an drei nicht konforme Teams erzeugen. Arbeiten Sie mit Finance zusammen, um sicherzustellen, dass die gültigen Werte in den Systemen vorhanden sind, wo dies erforderlich ist.
Dokumentieren Sie, was die einzelnen Tags bedeuten
Jeder Tag-Schlüssel benötigt eine Beschreibung: Was bedeutet er, warum wird er benötigt, was sind die gültigen Werte, wem gehört er? Teams ziehen diese Dokumentation heran, wenn sie sich nicht sicher sind. Ohne sie sind Tags Rätselraten.
Die effektivsten Tag-Rollouts fangen klein an und erweitern sich basierend auf Evidenz — nicht auf einem Big-Bang-Mandat, das eher Compliance-Theater als echte Compliance schafft.
Die erste Phase ist Audit-only: Überwachung ohne Erzwingung. Neue und bestehende Ressourcen werden gegen das Tag-Schema geprüft. Verstöße sind sichtbar, blockieren aber nichts. Diese Phase erstellt ein Bild des aktuellen Zustands und gibt den Teams Zeit, das Schema zu verstehen und anzuwenden, bevor es Konsequenzen hat.
In der zweiten Phase wird ein Soft Enforcement für neue Ressourcen eingeführt: Ressourcen ohne obligatorische Tags lösen eine Benachrichtigung aus. Die Teams werden informiert, erhalten Unterstützung bei der Behebung und erhalten einen Zeitplan. Dadurch soll verhindert werden, dass sich neue Verstöße häufen, während bestehende Verstöße angegangen werden.
Die dritte Phase erreicht die vollständige Durchsetzung: Nicht konforme neue Ressourcen werden blockiert. Bestehende Verstöße wurden behoben oder explizit als Ausnahme anerkannt. Das Tag-Schema ist nun eine echte Governance-Kontrolle, kein Anspruch.
Ein Tag-Katalog definiert, welche Tags für jede Cloud-Ressource obligatorisch sind — und welche Werte erlaubt sind. Ohne definierte Wertesätze werden Tags zu einem Freitextfeld, das niemand filtern, auswerten oder automatisch erzwingen kann.
Fünf obligatorische Tags bilden den Mindeststandard für eine steuerbare Cloud-Umgebung:
environment — Die Betriebsumgebung der Ressource. Ermöglicht eine eindeutige Zuordnung von Ressourcen zu Lebenszyklus und Betriebsphasen.
| Wert | Bedeutung |
|---|---|
prod | Produktionsumgebung, die von Endanwendern oder Geschäftsprozessen genutzt wird |
dev | Entwicklungsumgebung für neue Features und initiale Validierung |
test | Testumgebung für funktionales, technisches oder automatisiertes Testen |
qa | Qualitätssicherung vor der weiteren Freigabe einer Lösung |
stage | Produktionsnahe Validierung vor der Produktivbereitstellung |
uat | User Acceptance Testing durch fachliche Nutzer oder Stakeholder |
demo | Demonstrationsumgebung für Kunden, Schulungen oder interne Demos |
archive | Archivierte oder stillgelegte Ressourcen, die weiterhin für Audit oder Wiederherstellung benötigt werden |
int | Integrationsumgebung für Schnittstellen- und End-to-End-Tests |
sandbox | Experimentieren und Bewerten außerhalb definierter Entwicklungsprozesse |
provisioned-by — Wie die Ressource erstellt wurde. Dieses Tag ermöglicht die Erkennung von Ressourcen, die außerhalb des IaC-Prozesses erstellt wurden — ein kritisches Governance-Signal.
| Wert | Bedeutung |
|---|---|
iac | Bereitstellung über Infrastructure as Code (Terraform, OpenTofu, Pulumi, Bicep, CloudFormation) |
portal | Erstellt über ein Webportal oder eine grafische Verwaltungsoberfläche |
cli | Bereitstellung über eine Befehlszeilenschnittstelle |
sdk | Bereitstellung über das SDK eines Cloud-Anbieters |
rest-api | Direkte Bereitstellung über die REST-API des Cloud-Anbieters |
Ressourcen mit dem Tag portal oder cli in einer Produktionsumgebung signalisieren, dass jemand den IaC-Prozess umgangen hat — genau die Governance-Sichtbarkeit, die dieses Tag bieten soll.
cost-center — Die organisatorische Einheit, die die Kosten trägt. Der Wert muss eine gültige Kennung aus dem maßgeblichen Finanz- oder ERP-System sein. Es sind nur genehmigte Kostenstellenkennzeichen erlaubt.
data-classification — Die Vertraulichkeit der Daten, die von der Ressource verarbeitet, gespeichert oder übertragen werden. Steuert Sicherheitskontrollen, Verschlüsselungsanforderungen und Zugriffsbeschränkungen.
| Wert | Bedeutung |
|---|---|
public | Öffentliche oder nicht klassifizierte Informationen, die zur Veröffentlichung vorgesehen sind |
internal | Interne Informationen für Mitarbeitende, Partner oder beauftragte Dritte |
restricted | Erhöhter Schutzbedarf; unerlaubte Weitergabe verursacht erhebliche Auswirkungen |
confidential | Hoher Schutzbedarf; unerlaubte Weitergabe hat gravierende Folgen |
secret | Sehr hoher Schutzbedarf; Offenlegung verursacht kritische Konsequenzen |
top-secret | Höchste Klassifizierung; Offenlegung hat existenzielle oder katastrophale Folgen |
application-id — Die eindeutige Kennung der Anwendung aus der CMDB oder dem Anwendungsregister. Dieses Tag stellt die nachvollziehbare Verbindung von Cloud-Ressource zur Business-Applikation her.
Für den gesamten Tag-Katalog gelten zwei Grundsätze: Tags verweisen auf Informationen, sie duplizieren diese nicht. Ein Tag zeigt auf das autoritative System, anstatt seine Daten inline zu reproduzieren. Und Tags ersetzen nie eine CMDB — sie verweisen darauf. Die CMDB enthält den vollständigen Anwendungskontext; das Tag stellt lediglich die Verbindung her.
Was funktioniert
Wenige, aussagekräftige Tags mit klarer Verantwortlichkeit. Gültige Werte im Voraus definiert. Enforcement sukzessive eingeführt. Teams, die am Design beteiligt sind. Ausnahmen werden durch einen definierten Prozess behandelt, keine Ad-hoc-Übersteuerungen.
Woran es scheitert
Zu viele Tags, die niemand versteht. Freitextwerte, die Berichte fragmentieren. Big-Bang-Durchsetzung, die Teams blockiert, bevor sie das Schema verstehen. Tags, die allein vom Plattform-Team definiert werden, ohne Zutun derer, die sie anwenden.
Reporting-Anforderungen definieren: Welche Fragen soll das Tag-Schema beantworten? Kosten nach Team, Umgebung, Projekt, Datenklassifizierung — diese Anforderungen bestimmen das Tag-Design, nicht abstrakte Best Practices.
Das Schema gemeinsam entwerfen: Workshop mit Plattform-Team, FinOps, Security und repräsentativen Anwendungsteams. Definieren Sie Tag-Schlüssel, gültige Werte, Ownership und den Zweck jedes Tags.
Dokumentieren und kommunizieren: Jedes Tag erhält eine Beschreibung. Das Schema wird dort veröffentlicht, wo es von allen Teams zu finden ist. Teams, die Tags anwenden müssen, wissen warum — und nicht nur was.
Audit-only-Phase: Überwachung ohne Erzwingung aktivieren. Den aktuellen Stand verstehen. Teams bei der Behebung bestehender Verstöße unterstützen. Gültige Werte auf Basis des Gelernten verfeinern.
Phasenweise Durchsetzung: Aktivieren Sie die Durchsetzung, indem Sie mit den kritischsten Ressourcen beginnen. Behandeln Sie Ausnahmen anhand eines definierten Prozesses. Bauen Sie auf Vollabdeckung aus.
Wie das Tag-Schema in die Kostenberichterstattung und -optimierung integriert wird, wird in Showback & Chargeback behandelt.
Implementierung proaktiver Budget-Warnungen, Kosten-Visualisierung (Showback) und interner Kostenweiterverrechnung (Chargeback).
Cloud-Kostenmanagement-Tools sind weit verbreitet. Den meisten Organisationen, die mit Cloud Cost Governance zu kämpfen haben, fehlt nicht ein Tool, sondern es fehlt ein Rhythmus. Sie haben Dashboards, auf die niemand schaut, Alarme, auf die niemand reagiert, und Berichte, die zu spät eintreffen, um die Entscheidungen zu beeinflussen, die die Kosten verursacht haben.
Ein Governance-Rhythmus ist die regelmäßige Kadenz von Prüfung, Entscheidung und Maßnahme, die aus Kostendaten Steuerungsintelligenz macht. Ohne sie produziert auch das beste Tool Zahlen, nach denen niemand handelt. Damit reichen bereits einfache Tools aus, um die Cloud-Kosten planbar und unter Kontrolle zu halten.
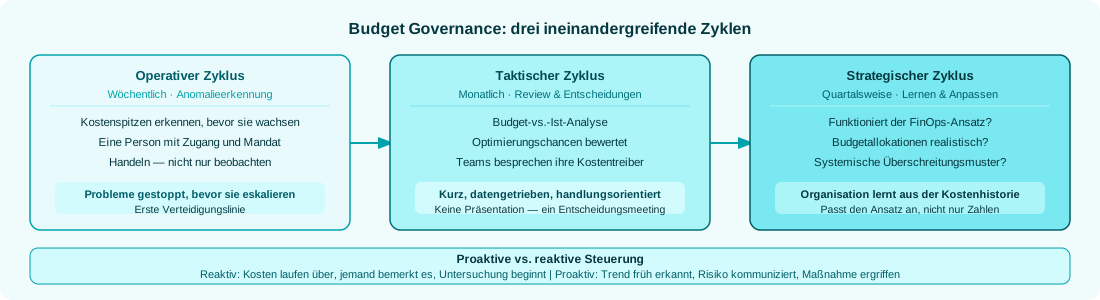
Budget Governance funktioniert über drei ineinandergreifende Zyklen, die jeweils einen anderen Zweck und eine andere Zielgruppe haben.
Der operative Zyklus ist die wöchentliche Schicht. Sein Zweck ist es, Anomalien zu erkennen, bevor sie zu erheblichen Überschreitungen werden. Jemand überprüft die Kostenentwicklung, prüft auf ungewöhnliche Spitzen und greift gegebenenfalls ein. Dafür ist kein Gremium oder eine formelle Sitzung erforderlich — es bedarf einer Person mit den richtigen Zugriffsrechten und dem Mandat zu handeln. Der operative Zyklus ist der Punkt, an dem Probleme gestoppt werden, bevor sie eskalieren.
Der taktische Zyklus ist die monatliche Schicht. Sein Zweck ist es, den Fortschritt im Vergleich zum Budget zu überprüfen, Optimierungsmöglichkeiten zu bewerten und Probleme an die Oberfläche zu bringen, die von der operativen Ebene identifiziert, aber nicht gelöst werden konnten. Dies ist das Meeting, in dem Teams ihre Cloud-Kosten besprechen, FinOps die Analyse des Monats vorstellt und Entscheidungen über Optimierungsinvestitionen getroffen werden. Monatliche Überprüfungen sollten kurz, datengetrieben und handlungsorientiert sein — keine Darstellung von Zahlen um ihrer selbst willen.
Der strategische Zyklus ist die vierteljährliche Schicht. Sein Zweck ist es zu bewerten, ob der FinOps-Ansatz an sich funktioniert. Sind Budgetallokationen realistisch? Haben organisatorische Änderungen zu Diskrepanzen zwischen Budgetverantwortlichen und tatsächlichen Ausgabenverantwortlichen geführt? Gibt es systemische Muster in den Überschreitungen, die strukturelle Veränderungen erfordern? Bei der vierteljährlichen Überprüfung lernt die Organisation aus ihrer Kostenhistorie und passt ihren Ansatz an.
Eine Anomalie ist ein Kostenmuster, das signifikant von dem abweicht, was erwartet wurde. Um Anomalien gut zu erkennen, bedarf es einer Methodik — und nicht nur eines Schwellenwerts.
Die Ausgangslage zählt
Ein Alarm, der jeden Montag ausgelöst wird, weil die Workloads zu Beginn der Woche hochskalieren, ist Lärm. Ein nützliches Anomalieerkennungssystem erkennt normale Muster — tägliche, wöchentliche und monatliche — und alarmiert nur, wenn etwas von diesen Mustern abweicht. Die Erstellung dieser Baseline erfordert einige Beobachtungswochen, bevor die Anomalieerkennung nützlich ist.
Der Kontext ist alles
Eine Kostenspitze ist nicht automatisch ein Problem. Eine geplante Migration, ein Produktlaunch oder ein einmaliger Batch Job kann berechtigterweise zu Spitzen führen. Eine gute Anomalieerkennung unterscheidet zwischen erwarteten und unerwarteten Abweichungen — was einen Kanal erfordert, über den Teams geplante Ereignisse melden können, bevor sie eintreten.
Schnelle Untersuchung, nicht nur Alarmierung
Ein Anomalie-Alarm, der drei Tage später eine Untersuchung auslöst, ist für die operative Reaktion nicht sinnvoll. Der Alarm muss jemanden erreichen, der die Untersuchung schnell durchführen kann und der über die entsprechenden Zugriffsmöglichkeiten und Fähigkeiten verfügt. Alarmdesign und Eskalationspfaddesign gehen Hand in Hand.
Der Abschluss zählt
Jede Anomalie sollte ein dokumentiertes Ergebnis haben: Was wurde gefunden, was hat sie verursacht, was wurde getan. Diese Dokumentation bildet ein institutionelles Gedächtnis, das eine schnellere Diagnose zukünftiger Anomalien ermöglicht — und die Evidenzgrundlage für strukturelle Veränderungen liefert, wenn sich Muster wiederholen.
Der Unterschied zwischen einer reaktiven und einer proaktiven Cloud-Kostenorganisation liegt nicht in den eingesetzten Tools, sondern in der Haltung gegenüber Kostentrends.
Eine reaktive Organisation reagiert auf Probleme, nachdem sie aufgetreten sind. Kosten überziehen das Budget, jemand bemerkt es, eine Untersuchung beginnt. Wenn die Maßnahme ergriffen wird, ist die Überschreitung bereits erheblich.
Eine proaktive Organisation nimmt Kostentrends wahr, während sie entstehen. Sie fragt: Wenn der aktuelle Verbrauch in diesem Tempo weitergeht, wo werden wir dann am Monatsende stehen? Werden bereits Ressourcen angelegt, die in drei Tagen als Kosten anfallen? Diese vorausschauende Haltung erfordert einen operativen Rhythmus und die Disziplin, ihn konsequent zu betreiben — aber sie vermeidet eine große Kategorie von Budgetüberschreitungen vollständig.
Um eine solche Haltung zu erreichen, müssen Sie in drei Dinge investieren: die richtigen Kennzahlen (Vorlaufindikatoren, nicht nur die kumulierten Ausgaben), die richtigen Leute (jemanden, zu dessen Job es gehört, diese Kennzahlen zu beobachten) und den richtigen Eskalationspfad (wenn jemand ein Risiko identifiziert, weiß er, was damit zu tun ist).
Ein Budget-Governance-System ohne definierten Eskalationspfad ist unvollständig. Wenn eine Anomalie festgestellt wird, die das Betriebsteam nicht beheben kann, wer wird benachrichtigt? Wenn die Ausgaben eines Teams auf Kurs sind, das Budget deutlich zu überschreiten, wer entscheidet dann, ob und wie interveniert wird? Wenn eine Kostenreduktionsempfehlung investiert werden muss, wer gibt diese frei?
Diese Entscheidungen sollten im Voraus getroffen werden, in Ruhe — nicht unter Druck, wenn ein Problem bereits eskaliert ist. Der Eskalationsweg sollte dokumentiert, kommuniziert und mindestens jährlich getestet werden.
Grundlegende Sichtbarkeit einrichten: Bevor Sie Alarmschwellenwerte oder Review-Rhythmen definieren, sollten Sie die tatsächlichen Kostenmuster der Organisation verstehen. Wie sieht eine normale Woche aus? Was sind die natürlichen Höhen und Tiefen? Zwei bis vier Wochen Beobachtungszeit geben in der Regel genug Aufschluss, um aussagekräftige Baselines zu setzen.
Den operativen Zyklus gestalten: Wer prüft wöchentlich die Kosten, wann und mit welchen Daten? Diese Person braucht einen klaren Zugang, einen klaren Wirkungsbereich und ein klares Mandat, entsprechend ihren Erkenntnissen zu handeln. Der operative Zyklus funktioniert nur, wenn er jemandem gehört.
Den monatlichen Review strukturieren: Definieren Sie die Agenda, die Teilnehmer und die erwarteten Ergebnisse. Der monatliche Review soll zu Entscheidungen führen, nicht nur zu Diskussionen. Wie gehen wir mit den identifizierten Optimierungschancen um? Wer ist für die Nachverfolgung zuständig?
Den Eskalationspfad definieren: Was passiert, wenn der wöchentliche Review eine signifikante Auffälligkeit feststellt? Was passiert, wenn ein Team auf Kurs ist, die Ausgaben deutlich zu überschreiten? Dokumentieren Sie die Entscheidungen und die Entscheider, bevor die Situation entsteht.
Die vierteljährliche strategische Überprüfung einführen: Sobald der operative und taktische Zyklus läuft, bietet die vierteljährliche Überprüfung den Raum, um zu bewerten, ob der Ansatz an sich funktioniert. Ändert der Governance-Rhythmus tatsächlich das Verhalten? Werden die Kosten berechenbarer?
Die Verbindung zwischen Budget Governance und den einzelnen Teamverantwortlichkeiten ist im RACI-Modell beschrieben.
Eine der effektivsten Governance-Maßnahmen im Cloud-Kostenmanagement ist konzeptionell auch eine der einfachsten: Cloud-Kosten werden den Teams zugerechnet, bei denen sie angefallen sind — transparent, regelmäßig und nachvollziehbar. Dieser Mechanismus wird als Chargeback (interne Abrechnung) oder Showback (Sichtbarkeit ohne direkte Abrechnung) bezeichnet.
Der Grundgedanke ist klar: Wer Cloud-Ressourcen konsumiert, soll die Kosten direkt sehen — oder sie sogar intern abgerechnet bekommen. Kostentransparenz schafft Anreize für sparsames Handeln. Ein Entwicklungsteam, das nie seine Cloud-Rechnung sieht, hat strukturell wenig Grund, ressourceneffizient zu arbeiten. Ein Team, dem diese Kosten sichtbar sind oder direkt zugeordnet werden, entwickelt ein anderes Kostenbewusstsein.
Showback ist der pragmatische Einstieg. Jedes Team erhält regelmäßig eine Aufschlüsselung seiner Cloud-Kosten — segmentiert nach Workloads, Umgebungen und Services. Diese Aufteilung ist informativ, nicht bindend: Kein Budget wird direkt belastet. Showback schafft Awareness und ist der ideale Ausgangspunkt, bevor vollständige Chargeback-Mechanismen etabliert sind.
Voraussetzung für ein funktionierendes Showback ist das vollständige Tagging aller Cloud-Ressourcen. Ohne korrekte Tags können Kosten nicht den richtigen Teams zugeordnet werden — das ist der häufigste Grund für unvollständige oder fehlerhafte Showback-Berichte.
Chargeback geht einen Schritt weiter: Cloud-Kosten werden intern abgerechnet. Teams erhalten ein Cloud-Budget, mit dem ihr tatsächlicher Verbrauch verrechnet wird. Überschreitungen werden sichtbar und müssen begründet werden. Minderausgaben können zurückgemeldet oder für zukünftige Zeiträume geplant werden.
Chargeback funktioniert nur, wenn die Voraussetzungen stimmen: eine vollständige Kostenzuordnung über Tags, eine akzeptierte Methode zur Kostenzuordnung (Wie werden Shared Services auf Teams verteilt?) und ein vereinbarter Governance-Prozess für Budgetüberschreitungen. Eine Kostenverrechnung auf Basis des tatsächlichen Verbrauchs schafft Anreize für eine sparsame Cloud-Nutzung — das ist der eigentliche Wert. Kostenbewusstsein entsteht nicht durch Dashboard-Abonnements, sondern dadurch, dass Kosten Teil der Teamverantwortung werden.
Formales Meilenstein-Meeting, bei dem CIO, CTO, CFO und CISO die Readiness-Scorecard abnehmen, Budgets freigeben und Signaturen leisten.
Das Freigabegespräch ist keine Statusaktualisierung. Es ist die Gründungsveranstaltung der Adoption-Phase — der Moment, in dem die Organisation gemeinsam entscheidet: „Wir sind bereit. Wir verpflichten uns. Wir starten.“
Ohne dieses formale Ereignis fehlt es in der Adoption-Phase an:
Dauer: 2–3 Stunden
Ort: Physisches Meeting empfohlen (keine virtuelle Checkbox-Übung)
| Zeitblock | Agendapunkt | Wer |
|---|---|---|
| 15 Min | Begrüßung und Zweck des Gesprächs | CIO |
| 30 Min | Readiness-Scorecard: Ergebnisse aller 5 Dimensionen | CCoE Lead |
| 20 Min | Offene Punkte und Gefährdungsbeurteilung | CCoE Lead |
| 20 Min | Adoption-Roadmap: erste Migrationswellen, Ressourcenplan | CCoE Lead |
| 15 Min | Fragen und Diskussion | Alle |
| 15 Min | Formale Freigabe: Unterschriften | Cloud Strategy Board |
| 5 Min | Kick-off-Kommunikation | CIO |
Unterzeichner (obligatorisch):
Beratende Anwesenheit:
Das Freigabedokument ist der verbindliche Output des Gesprächs:
Datum: [Datum]
Organisation: [Name]
Hiermit wird bestätigt:
Die Beratungsphase der Cloud-Transformation wurde erfolgreich abgeschlossen. Alle definierten Ergebnisse (Cloud-Strategie, Business Case, Einrichtung des CCoE, FinOps-Rahmenwerk, Change-Management-Programm, Governance-Rahmenwerk, Readiness-Bewertung) sind vorhanden.
Die 5-Dimension-Readiness-Bewertung wurde durchgeführt. Alle Dimensionen haben das Kriterium „Ready“ erreicht oder werden es bis zum [Datum] erreichen (offene Punkte: [Liste]).
Das Cloud-Jahresbudget für die Adoption-Phase in Höhe von [TEUR X] wird freigegeben.
Die Adoption-Roadmap mit folgenden ersten Migrationswellen wird freigegeben:
Der CCoE ist mit [N] FTE vollständig besetzt und operativ.
Eskalationswege und Governance:
| Rolle | Name | Unterschrift | Datum |
|---|---|---|---|
| CIO | |||
| CTO | |||
| CFO | |||
| CISO |
Eine digitale Freigabe per E-Mail ist nicht mit einer persönlichen Unterschrift in einem gemeinsamen Meeting gleichzusetzen. Unterschriften schaffen:
Commitment: Jeder Unterzeichner hat sich öffentlich bekannt. Das macht es später schwerer, sich von der Transformation zu distanzieren.
Gleichzeitigkeit: Alle vier C-Level-Funktionen verpflichten sich gemeinsam — kein späteres „Das war ja nur ein IT-Projekt“.
Dokumentierte Budgetbindung: Der CFO hat das Budget auf dem Dokument genehmigt — kein späteres „Das war ja nicht in der Budgetplanung“.
Historischer Bezug: Bei späteren Governance-Konflikten gibt es ein Dokument, das zeigt: Diese Entscheidung wurde bewusst und gemeinsam getroffen.
Der CIO kommuniziert den Start der Adoption-Phase innerhalb von 24 Stunden an die Organisation: