Gemeinsamer Dateispeicher für STACKIT Kubernetes Engine
Zuletzt aktualisiert am
Anwendungsfall und Nutzen
Abschnitt betitelt „Anwendungsfall und Nutzen“Mehrere Replikate einer Anwendung benötigen dieselben Uploads, erzeugten Berichte oder Arbeitsdateien, auch wenn Kubernetes sie auf unterschiedlichen Nodes ausführt. Dateien ausschließlich im Container stellen dieses gemeinsame Verzeichnis nicht bereit. Dieser Blueprint verbindet die STACKIT Kubernetes Engine (SKE) über NFS mit STACKIT File Storage (SFS) und stellt den Speicher über einen ReadWriteMany-PersistentVolumeClaim (RWX) bereit.
Die Anwendung arbeitet weiter mit Dateipfaden, statt eine Object-Storage-API einzubinden. Typische Anwendungsfälle sind eine replizierte Webanwendung mit gemeinsamen Mediendateien oder Worker, die Dateien austauschen. Die Anwendung muss parallele Zugriffe unterstützen: RWX ermöglicht einen gemeinsamen Mount, übernimmt aber keine Anwendungssperren oder transaktionalen Schreibzugriffe.
Architektur und Datenfluss
Abschnitt betitelt „Architektur und Datenfluss“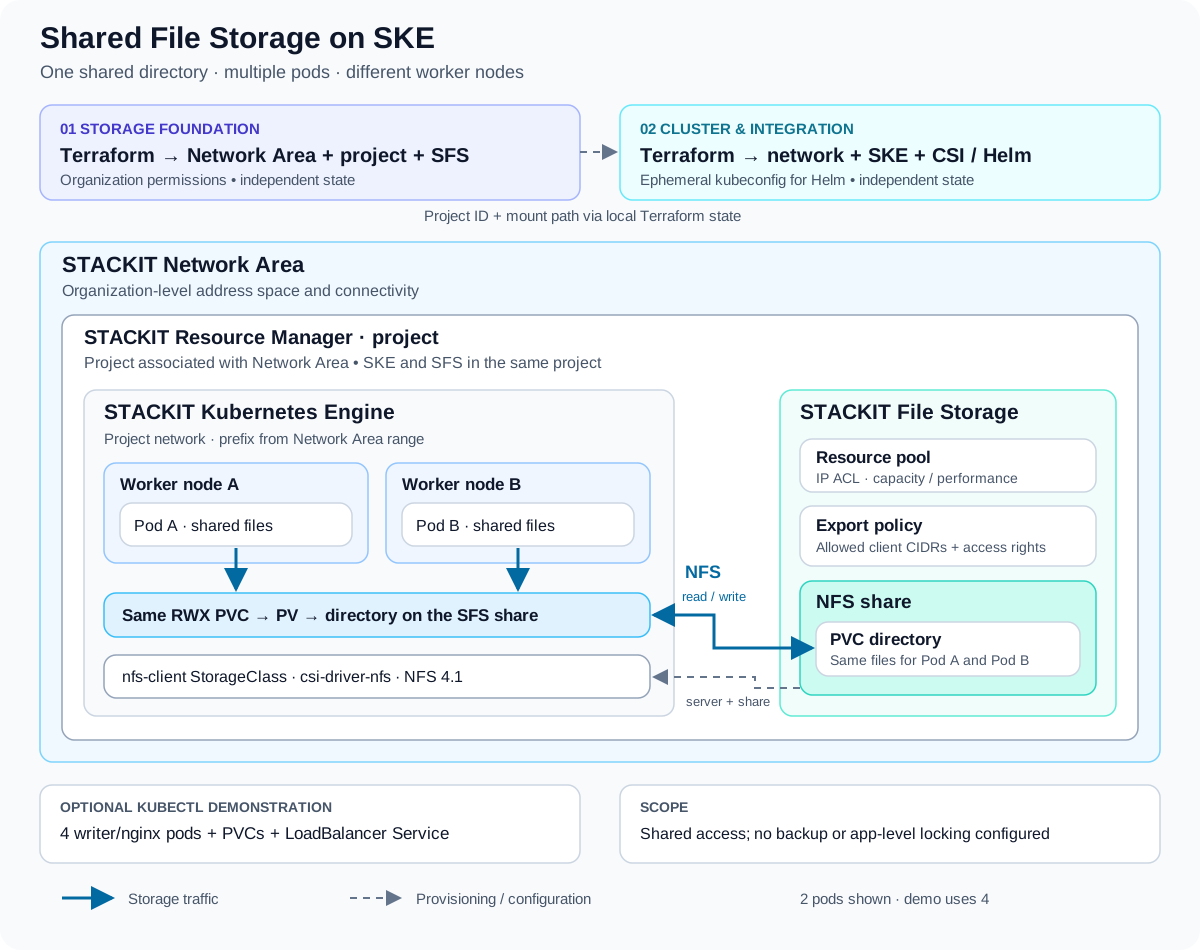
Die Grafik zeigt beispielhaft zwei Pods; die mitgelieferte Demonstration verteilt vier Replikate auf mindestens zwei Nodes. Network Area stellt Adressraum und Netzverbindung bereit. Das Projekt ist dieser Network Area zugeordnet, sodass das SKE-Netz ein Präfix aus ihrem konfigurierten Bereich erhält. Die IP-ACL des SFS-Pools und die Export Policy erlauben standardmäßig Clients aus diesem Bereich.
In SKE bindet der per Helm installierte csi-driver-nfs den vorhandenen SFS-Endpunkt über die StorageClass nfs-client ein. Ihre Parameter server und share stammen aus dem SFS-Mount-Pfad. Die dynamische Provisionierung erzeugt je PVC ein Verzeichnis auf dem Share; Pods mit demselben PVC teilen dieses Verzeichnis. Unterschiedliche PVCs greifen nicht automatisch auf dieselben Dateien zu. Die NFS-CSI-Treiberparameter beschreiben dieses Modell.
| Komponente | Aufgabe im Blueprint |
|---|---|
| STACKIT Resource Manager: Projekt | Enthält SFS und SKE; wird im Beispiel direkt unter der Organisation angelegt |
| STACKIT Network Area und Projektnetz | Stellen Adressbereich und Netzpfad zwischen SKE-Nodes und SFS bereit |
| STACKIT File Storage | Resource Pool, Export Policy und NFS-Share halten die gemeinsamen Dateien |
| STACKIT Kubernetes Engine | Führt die Anwendung in einem Node Pool mit zunächst zwei Nodes aus |
| NFS-CSI-Treiber und StorageClass | Verbinden den vorhandenen Share mit Kubernetes-PVs und -PVCs; sind Komponenten im Cluster |
Was wird bereitgestellt?
Abschnitt betitelt „Was wird bereitgestellt?“Terraform ist in zwei getrennt verwaltete Stufen aufgeteilt. So bleiben Einrichtung auf Organisationsebene und die langsamere Bereitstellung des Storage-Pools von Cluster-Operationen getrennt.
01-storage: Erstellt Network Area und regionale Adressbereiche, ein zugeordnetes Projekt sowie SFS Resource Pool, Export Policy und Share. Outputs enthalten Projekt-ID, Mount-Pfad und Netzwerkinformationen.02-cluster: Liest Projekt-ID und Mount-Pfad aus dem lokalen State der ersten Stufe, erstellt Projektnetz und SKE-Cluster und installiert NFS-CSI-Helm-Chart und StorageClass. Eine ephemere Kubeconfig liefert Helm-Zugangsdaten, ohne diese Kubeconfig im Terraform-State abzulegen.- Optionale Demonstration: Kubernetes-Manifeste erzeugen einen Test-PVC, danach einen zweiten PVC, vier Pods mit Writer und nginx sowie einen
LoadBalancer-Service. Die Writer hängen ihre Hostnamen an eine gemeinsame Datei an, die nginx ausliefert. Diese Objekte werden außerhalb von Terraform mitkubectlangelegt.
Voraussetzungen und Bereitstellung
Abschnitt betitelt „Voraussetzungen und Bereitstellung“Für den vollständigen Blueprint ist Terraform ab 1.10 erforderlich: Stufe 1 benötigt 1.5, Stufe 2 wegen der ephemeren Ressource 1.10. Das Beispiel deklariert den STACKIT Provider >= 0.116.0 und den Helm Provider >= 3.1.1. SFS-Beta-Ressourcen und das SKE-Experiment sind in der jeweiligen Provider-Konfiguration aktiviert.
Benötigt werden Organisationsberechtigungen für die erste Stufe, ein für Terraform zugänglicher Service-Account-Schlüssel und eine authentifizierte STACKIT CLI. Das Beispiel legt das Projekt direkt unter der Organisation an, da seine README eine Einschränkung für SKE-Cluster in Projekten unterhalb von Ordnern dokumentiert. Prüfe die aktuelle SKE-Dokumentation , bevor du diese Hierarchie anpasst. Für die Demonstration ist kubectl erforderlich. Berücksichtige Kosten für bereitgestellte Speicherkapazität, Worker-Nodes und den optionalen Load Balancer.
- Storage konfigurieren. Klone das Quellrepository und wechsle nach
examples/ske-stackit-sfs-integration/01-storage. Kopiereterraform.tfvars.examplenachterraform.tfvars, trage Organisation, übergeordneten Container und Eigentümer-E-Mail ein und konfiguriere Zugangsdaten sowie überschneidungsfreie Netzbereiche. - Storage prüfen und erstellen. Führe
terraform init,terraform validateundterraform planaus und wende anschließend den geprüften Plan an. Warte auf einen nutzbaren IPv4-NFS-Endpunkt. Für Pool-Operationen sind 60 Minuten Timeout voreingestellt; die README der Stufe beschreibt die Prüfung eines Timeouts vor einer Wiederherstellung. - Cluster prüfen und erstellen. Wechsle nach
../02-cluster, passe bei Bedarf die Variablen an und führeterraform init,terraform validateundterraform planaus. Wende den geprüften Plan an. Behalte für die voreingestellte State-Übergabe die vorgesehene Verzeichnisstruktur beider Stufen bei. - Gemeinsamen Zugriff nachweisen. Folge der README von Stufe 2, um eine Kubeconfig abzurufen, den Cluster-Kontext auszuwählen und
PersistentVolumeClaim.yamlsowieexample-rwx-deployment.yamlanzuwenden. Prüfe gebundene PVCs und vier laufende Pods auf mindestens zwei verschiedenen Nodes. Lies/data/index.htmlaus Writer-Containern auf verschiedenen Nodes und prüfe Einträge mehrerer Pod-Hostnamen.
Die Demonstration belegt gemeinsamen Zugriff über Node-Grenzen hinweg. Sie belegt weder die Durchsetzung von RWX-Zugriffsmodi durch Kubernetes noch Anwendungskonsistenz, Durchsatz oder Wiederherstellungsverhalten.
Was lässt sich anpassen?
Abschnitt betitelt „Was lässt sich anpassen?“| Bereich | Verfügbare Konfiguration und Auswirkungen |
|---|---|
| Platzierung und Namen | Organisation, Projekt-Container, Eigentümer-E-Mail, Namen und Region. Konfiguriere beide Stufen für dieselbe vorgesehene Region und stimme die Availability Zones von SFS und SKE darauf ab. |
| Netzwerk | Transfer-CIDR und Workload-Bereich der Network Area; Präfixlänge und DNS-Server des SKE-Netzes. Plane überschneidungsfreie Bereiche mit genügend Platz für SFS und Cluster-Netze. |
| Speicherkapazität | sfs_pool_size_gigabytes ist auf 512 voreingestellt; die Validierung verlangt mindestens 500. sfs_share_size_gigabytes ist auf 128 voreingestellt. Das sind Pool-Kapazität und Share-Hard-Limit, keine Reservierungen je PVC. |
| Storage-Platzierung und Leistung | sfs_availability_zone ist auf eu01-m, sfs_performance_class auf Standard voreingestellt. Prüfe unterstützte Kombinationen und Grenzen in der aktuellen File-Storage-Dokumentation. |
| Zugriff und Lebenszyklus | sfs_ip_acl, Labels und Timeout für Pool-Operationen. Die voreingestellte ACL erlaubt den gesamten Network-Area-Bereich; grenze sie nach Möglichkeit auf benötigte Clients ein. |
| Cluster | Cluster-Name, minimale Kubernetes-Version, Maschinentyp, Node-Availability-Zones und Autoscaling-Grenzen. Voreingestellt sind c2i.2, eu01-3 und zwei bis drei Nodes. Die Demo benötigt mindestens zwei Nodes. |
| CSI-Integration | Chart-Version (voreingestellt 4.13.4), StorageClass-Name und Mount-Optionen (voreingestellt nfsvers=4.1). Bei Umbenennung von nfs-client müssen beide YAML-Manifeste angepasst werden. |
| Vorhandene Infrastruktur | Mit beiden Werten stackit_project_id und sfs_mount_path entfällt das Lesen des States aus Stufe 1. Stufe 2 erstellt weiterhin Netz und Cluster; ein bestehender Cluster erfordert Codeanpassungen. Das gewählte Projekt benötigt passende Network-Area-Zuordnung und Zugriff auf den Share. |
Export-Regeln, Root-Squashing, zusätzliche Shares, Backup-Regeln und die Sicherheitseinstellungen der Anwendungs-Pods erfordern Änderungen an Terraform oder Manifesten; sie sind nicht alle als Variablen verfügbar. Behandle Änderungen an Region und Platzierung als Architekturänderungen und prüfe den resultierenden Terraform-Plan.
Grenzen und Entscheidungen für den Produktivbetrieb
Abschnitt betitelt „Grenzen und Entscheidungen für den Produktivbetrieb“- Parallele Schreibzugriffe: Gemeinsamer Speicher macht eine Anwendung nicht automatisch für mehrere Writer geeignet. Prüfe Dateisperren, Berechtigungen und Aktualisierungsverhalten. Aus der reinen Append-Demo lässt sich keine Eignung für Datenbanken ableiten.
- Kapazität und Isolation: Der generische NFS-CSI-Treiber provisioniert Unterverzeichnisse eines bestehenden Shares. Ein PVC-Request erzeugt weder einen eigenen SFS-Share noch eine durch diesen Blueprint konfigurierte Verzeichnisquota. Plane gemeinsame Kapazität und Mandantentrennung ausdrücklich.
- Zugriffsschutz: IP-ACLs identifizieren Netzwerk-Clients, keine einzelnen Pods. Prüfe Export-Policy-Rechte und passende UID/GID-Einstellungen der Container. Das Beispiel setzt
super_usernicht; laut Quellcode gewährt der API-Standard Root-Zugriff. Prüfe Root-Squashing ausdrücklich vor dem Einsatz über Vertrauensgrenzen hinweg. - Verfügbarkeit und Wiederherstellung: Der voreingestellte Worker-Pool nutzt eine Availability Zone. Zwei Nodes zeigen gemeinsamen Zugriff, keine Ausfallsicherheit über Zonen. Der Blueprint konfiguriert weder Backup-Zeitpläne und Restore-Tests noch Anwendungs-Failover oder Monitoring; sichtbare Snapshots allein ergeben keine Backup-Strategie.
- State und Zugangsdaten: Die voreingestellte Übergabe liest einen lokalen State. Schütze beide States und Zugangsdaten; passe Backend und Zugriffsmodell für den Teambetrieb an. Die ephemere Helm-Authentifizierung hält diese Kubeconfig aus dem State, ersetzt aber keinen allgemeinen State-Schutz. Die README von Stufe 2 beschreibt Einschränkungen für Imports, solange der Cluster nicht existiert.
- Demo-Anwendung: nginx-Endpunkt und Writer demonstrieren die Funktion. Produktive Authentifizierung, TLS, Ressourcenbemessung und Anwendungshärtung sind nicht enthalten. Das Deployment nutzt
Recreateund zeigt daher keine unterbrechungsfreien Rollouts.
Aufräumen und aufbewahrte Daten
Abschnitt betitelt „Aufräumen und aufbewahrte Daten“Entferne die Demonstration nach der Anleitung in der README von Stufe 2, bevor du Terraform-Ressourcen löschst. Terraform verwaltet ihren LoadBalancer-Service nicht. Die StorageClass nutzt reclaimPolicy: Retain: Beim Löschen eines PVCs bleiben PV und Daten erhalten. Auch das Löschen des aufbewahrten PV-Objekts entfernt dessen Verzeichnis auf dem Share nicht; entscheide bewusst über Archivierung oder Löschung dieser Dateien.
Baue zuerst 02-cluster und danach 01-storage ab. Das Löschen von Stufe 1 entfernt auch SFS-Share und Pool. Kubernetes-Retain schützt somit nicht vor dem Löschen der Storage-Infrastruktur.
Quellcode und Service-Dokumentation
Abschnitt betitelt „Quellcode und Service-Dokumentation“Implementierung und Stufen-READMEs sind die Referenz für Befehle, Vorgaben und Fehlerbehebung. Die STACKIT-File-Storage-Dokumentation beschreibt aktuelle Service-Funktionen und Grenzen. Das Quellbeispiel nennt Markus Brunsch in MAINTAINERS.md als technischen Maintainer.